


- @m0_71832273


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
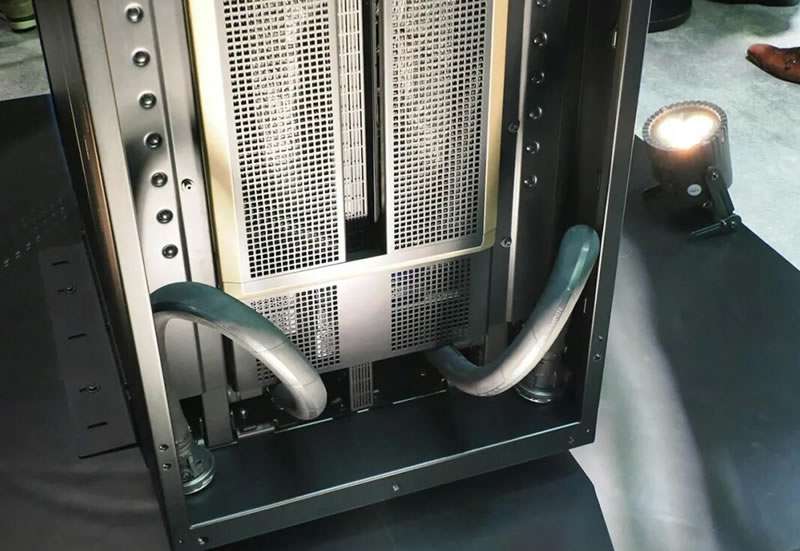
云达科技现场展示的1U机型QuantaGrid D75B-1U,在Nvidia GB200 NVL72的系统建置框架之下,可透过单座机柜容纳72台这样的设备。新一代 AI 液冷机架解决方案 NVIDIA GB200 NVL72,结合了 36 个 NVIDIA GB200 Grace Blackwell 超级芯片,其中包括 72 个基于 NVIDIA Blackwell 的 GPU 和 36 个NV
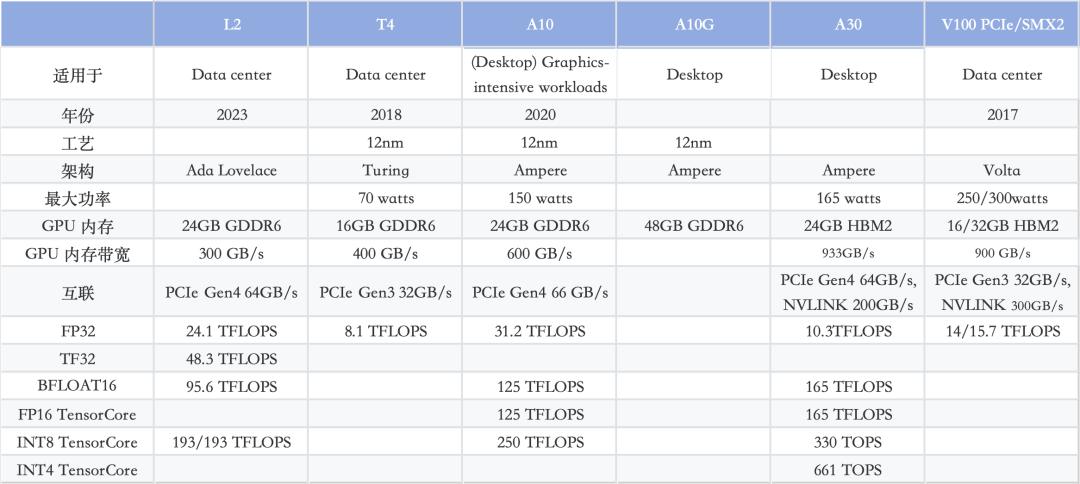
NVIDIA NVLink采用全网状拓扑,如下所示,(双向)GPU-to-GPU 最大带宽可达到400GB/s (需要注意的是,下方展示的是8*A100模块时的600GB/s速率,8*A800也是类似的全网状拓扑);和华为/海思主流 GPU 的型号性能,供个人参考使用,文中使用数据均源自官网。本文转自SDNLAB,编译自arthurchiao的博客,主要介绍了。以上内容来自架构师联盟。
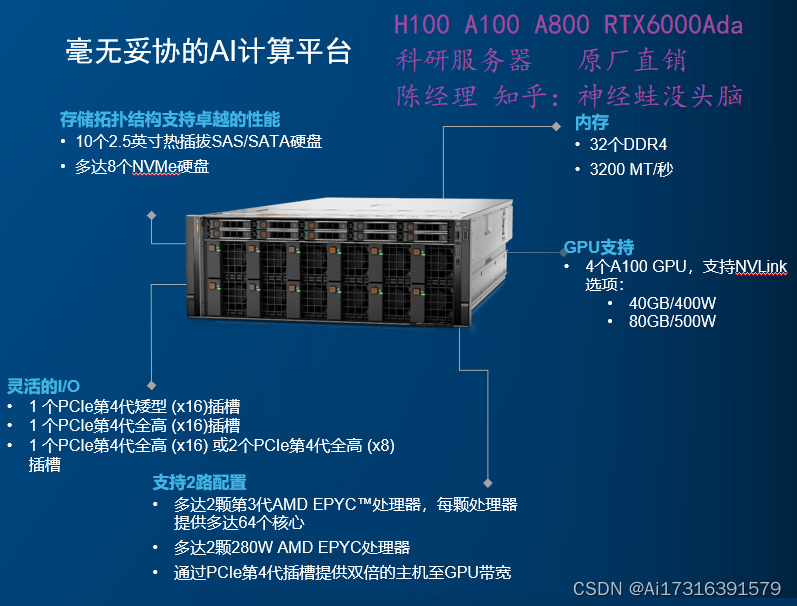
虽然对于这些国产AI芯片厂商来说,美国的新的AI芯片限制政策是一个利好消息,但是对于国内依赖于高性能AI芯片提供AI硬件的厂商、以及提供AI服务的互联网厂商及一些AI技术厂商来说则是一个利空,毕竟如果缺少了强大的AI芯片的支撑,那么其AI技术的发展及所能够提供的AI服务也将受到负面影响。,在目前供需失衡不正常的市场情况下,市面大部分商家是无法供应的,甚至提供不属实的信息,如果是科研服务器的话首选风
阅读本文前需要先搞懂NAT、PAT、端口映射几个概念,前面我有写了一篇关于这几个概念的博文。根据之前的博文我们已经知道,内网宽带中的主机可以访问公网宽带主机,反之不可以访问;公网宽带主机可以和公网宽带主机双向访问;内网宽带中的主机和内网宽带中的主机互相无法访问。那么内网宽带中的客户机和公网宽带中的客户机如何访问另一个内网宽带中的服务器呢?这里就需要用到内网穿透技术。

AI产品榜全球总榜分为网站榜和应用榜两大类别。网站榜依据月访问量对全球网站进行排名,应用榜则根据月活跃用户数排序。榜单由权威机构AICPB制定标准并每月更新,网站榜数据周期为2025年12月,应用榜为2026年1月。该排名系统为行业提供了客观的AI产品影响力评估指标,最新更新时间为2026年2月3日。

它采用了先进的Ampere微架构,具备强大的浮点运算能力和高效的内存带宽,能够满足大模型训练推理的高计算需求。对于预算有限的用户,可以选择性价比较高的V100 32G或A800/H800等型号的GPU。对于大模型而言,足够的显存能够确保训练过程的顺利进行。这些GPU不仅能够满足大模型的训练需求,还能够在推理过程中提供稳定可靠的性能。此外,还需要考虑GPU的散热性能,以确保在高负载运行时能够保持稳定
如果你可以为你的集群购买 RTX GPU:66% 的 8路RTX 4080 和 33% 的 8路RTX 4090(要确保能有效地冷却)。如果解决不了 RTX 4090 的冷却问题,那么可以购买 33% 的 RTX 6000 GPU 或 8路Tesla A100。任何专业绘图显卡(如Quadro 卡);进一步学习,卖掉你的 RTX 4070,并购买多路RTX 4090。根据下一步选择的领域(初创公司
它采用了先进的Ampere微架构,具备强大的浮点运算能力和高效的内存带宽,能够满足大模型训练推理的高计算需求。对于预算有限的用户,可以选择性价比较高的V100 32G或A800/H800等型号的GPU。对于大模型而言,足够的显存能够确保训练过程的顺利进行。这些GPU不仅能够满足大模型的训练需求,还能够在推理过程中提供稳定可靠的性能。此外,还需要考虑GPU的散热性能,以确保在高负载运行时能够保持稳定
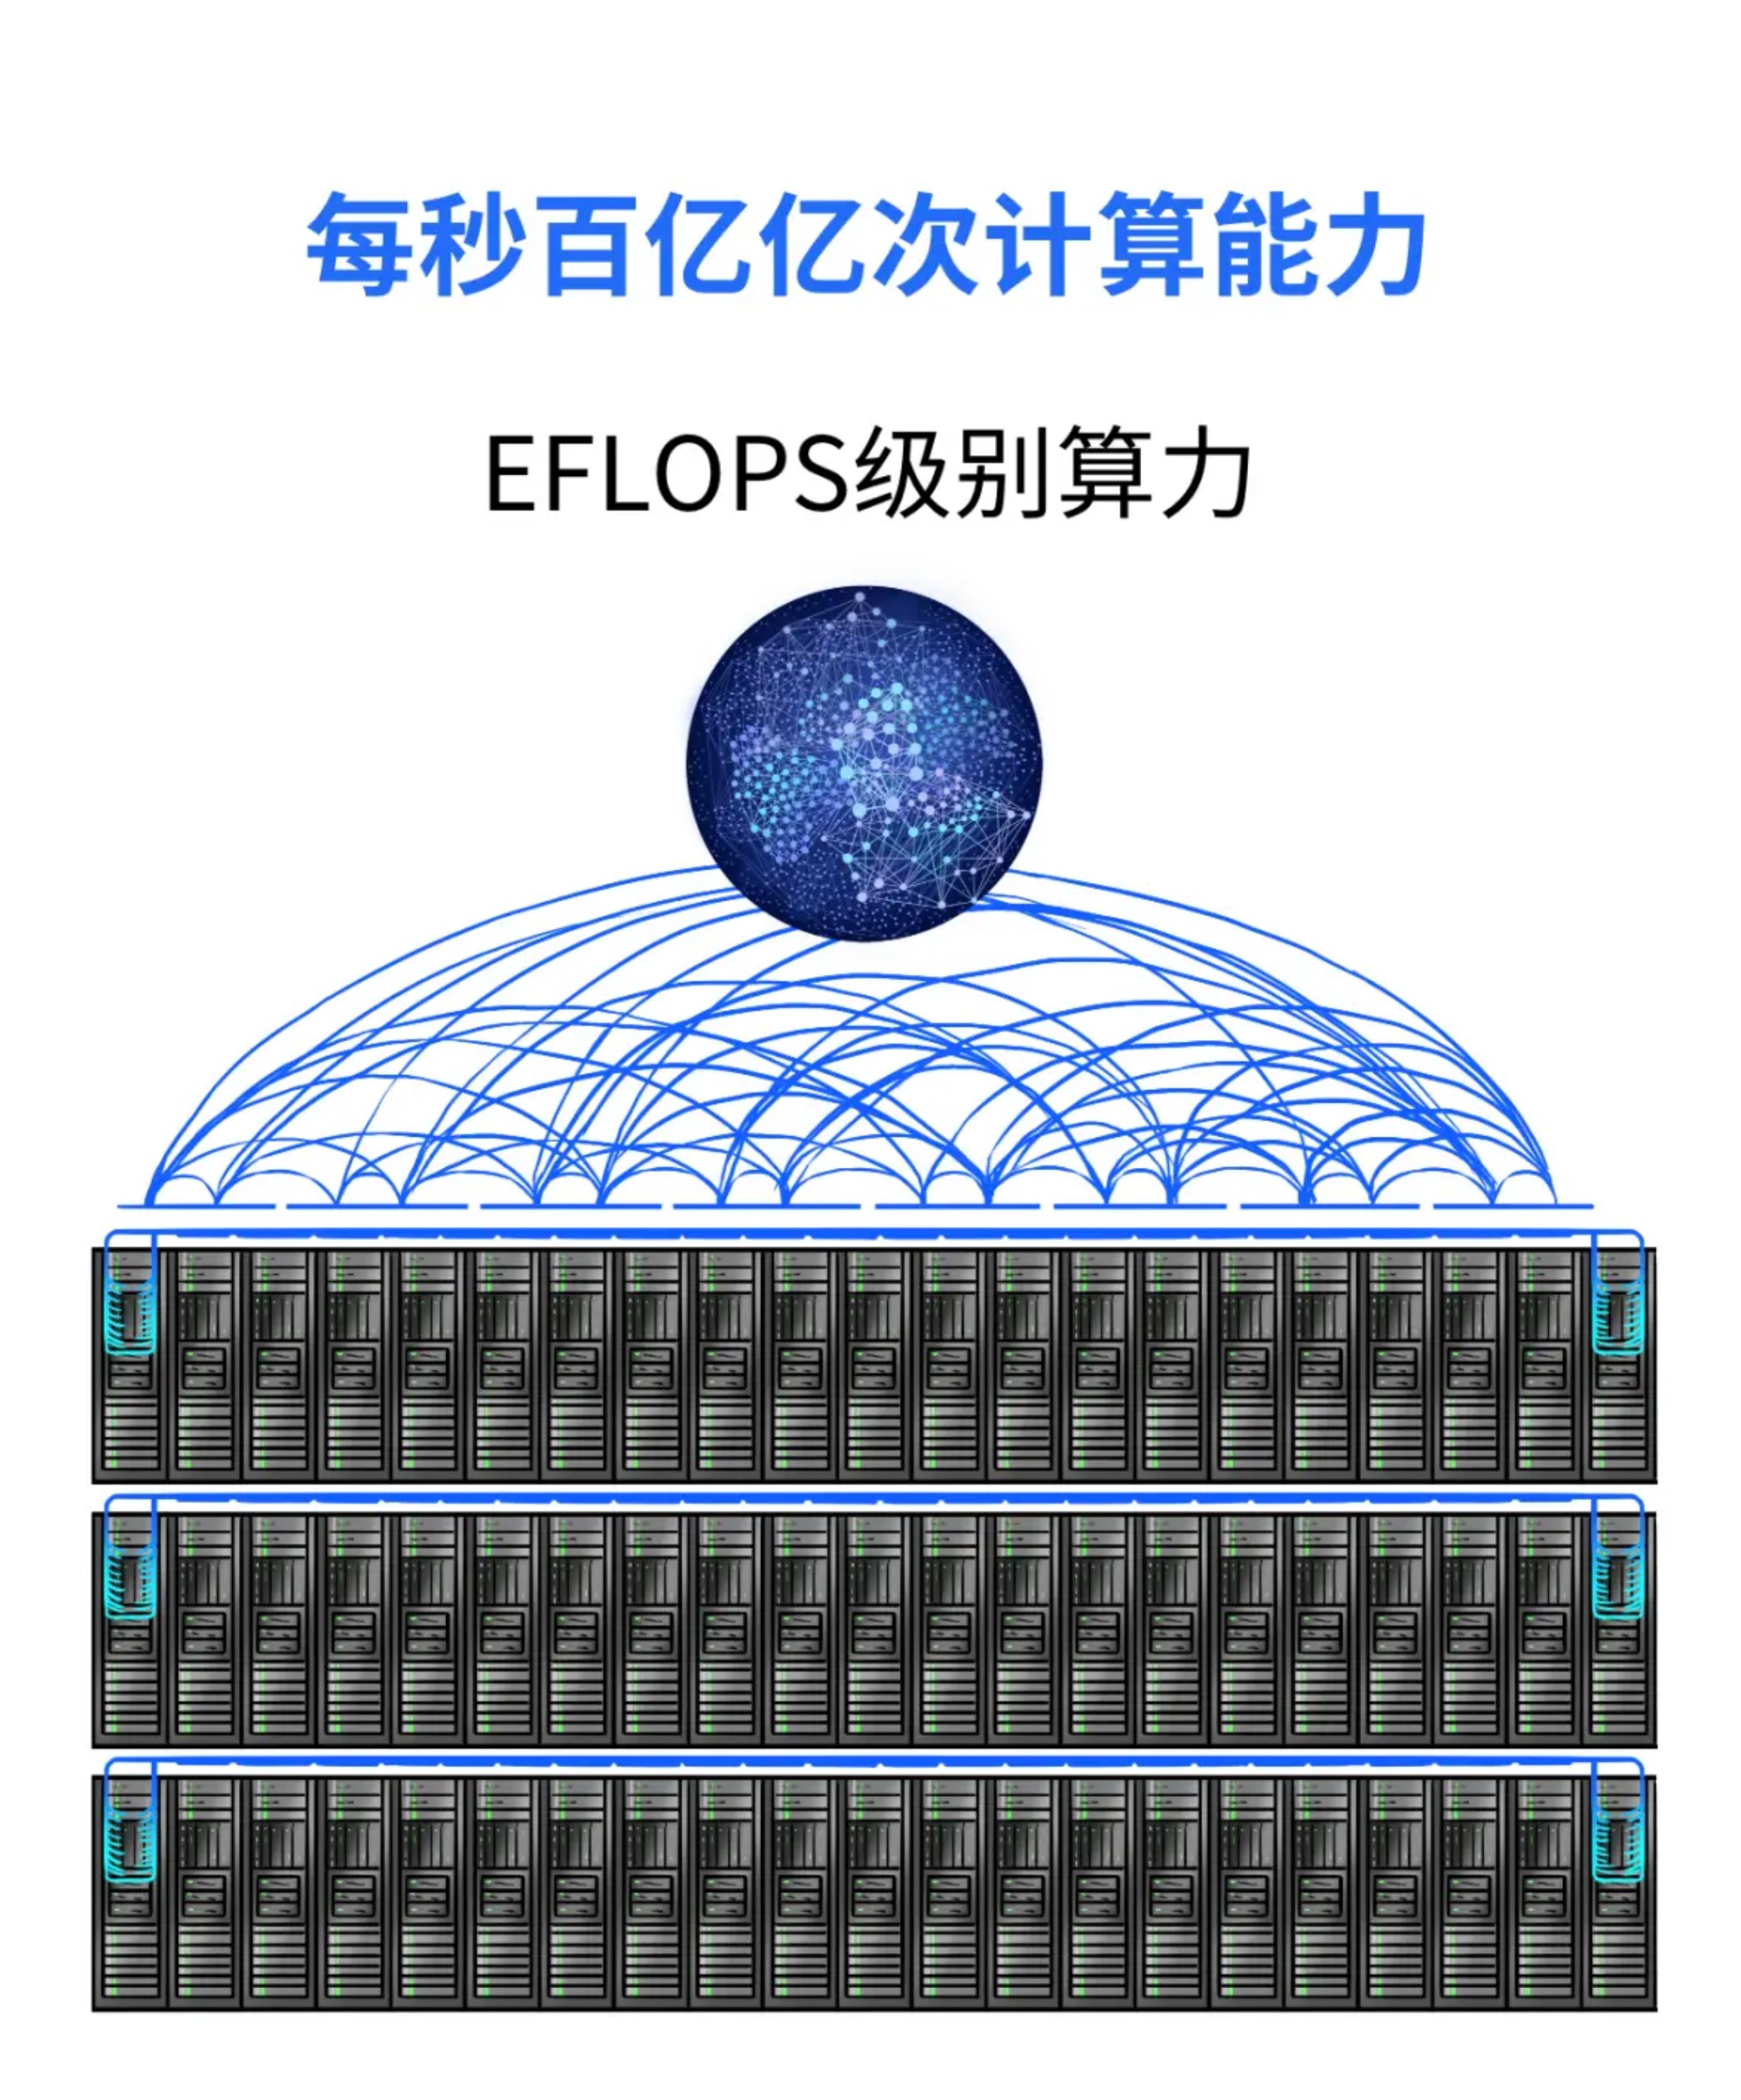
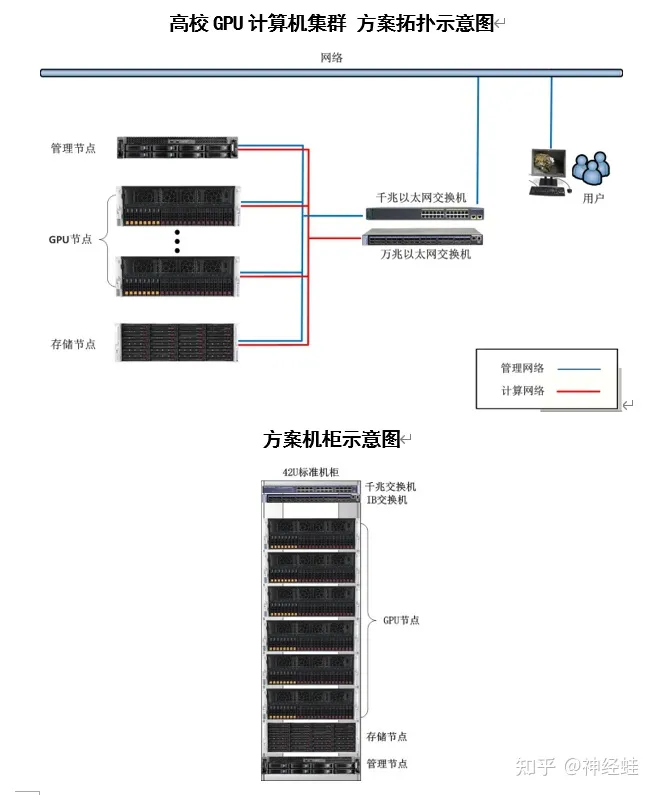
而集群的最大优势在于对故障服务器的监控是基于应用的,也就是说,只要服务器的应用停止运行,其它的相关服务器就会接管这个应用,而不必理会应用停止运行的原因是什么。高性能计算、深度学习集群服务器解决方案,提供标准的软硬件接口,支持分布式AI运算,可用于机器学习、人工智能和大数据开发等,相对传统的集群服务器,拥有低功耗、高可管理性、高灵活性等特点。集群系统可解决所有的服务器硬件故障,当某一台服务器出现任何
NVIDIA NVLink采用全网状拓扑,如下所示,(双向)GPU-to-GPU 最大带宽可达到400GB/s (需要注意的是,下方展示的是8*A100模块时的600GB/s速率,8*A800也是类似的全网状拓扑);和华为/海思主流 GPU 的型号性能,供个人参考使用,文中使用数据均源自官网。本文转自SDNLAB,编译自arthurchiao的博客,主要介绍了。以上内容来自架构师联盟。