- @m0_66822255


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Word2Vec 的设计理念源自分布假设(Distributional Hypothesis)——即一个词的含义由它周围的词决定。基于这一假设,Word2Vec 构建了一个简洁的神经网络模型,通过学习词与上下文之间的关系,自动为每个词生成一个能反映语义特征的稠密向量表示。模型输入输出上下文词(前后若干个词)预测目标中心词Skip-gram中心词预测上下文词(前后若干个词)只要按照上述目标训练模型,
ResNet(Residual Neural Network,残差神经网络)是由何恺明等人在 2015 年提出的一种深度卷积神经网络架构。该模型在当年ImageNet 竞赛中一举夺得分类任务第一名和目标检测第一名,同时在COCO 数据集上也斩获目标检测和图像分割的双料冠军。ResNet 的核心创新在于引入了**残差块(Residual Block)**结构,通过"跳跃连接"的方式有效缓解了深层网络
如果你想检测更小的人脸,可以增加这个值(如 1 表示上采样一次),但会降低速度。dlib.get_frontal_face_detector() 返回一个基于 HOG + 线性 SVM 的人脸检测器对象。该检测器经过大量训练,能检测不同大小、不同角度的人脸(正面和侧面)。通过对比可以看出,dlib 更适合对准确率有较高要求的场景,如果你的应用对实时性要求极高,可以继续使用 Haar,反之则推荐 d
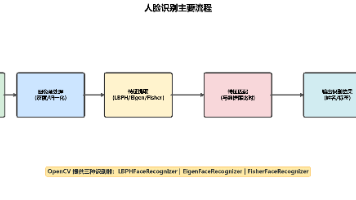
实现人脸识别的主要流程如下图所示:LBPH(局部二值模式直方图)EigenFaces(特征脸)FisherFaces(费舍尔脸)下面将逐一详细介绍这三种方法的原理与实现。
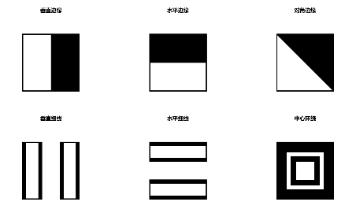
在 OpenCV 中,人脸检测主要通过调用预训练的分类器来实现。Haar 特征级联分类器:基于 Haar-like 特征,是最经典的人脸检测方法LBP 特征级联分类器:基于局部二值模式,速度更快HOG 特征分类器:主要用于行人检测这些分类器以XML 文件的形式提供,用户只需加载对应的 XML 文件即可快速实现人脸检测功能。Haar 特征是一种基于图像亮度差异的局部特征描述符,常用于目标检测任务。其
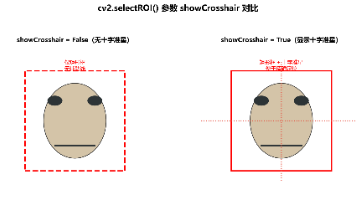
物体跟踪(Object Tracking)是指在视频序列中持续定位和追踪特定目标的过程。智能监控:持续跟踪可疑目标或行人自动驾驶:跟踪前方车辆、行人等障碍物增强现实(AR):跟踪标记物以叠加虚拟内容人机交互:手势跟踪、眼球追踪等与目标检测不同,物体跟踪侧重于连续帧间的一致性,利用时间序列信息实现高效的目标定位。
在 OpenCV 中,指纹验证是一种利用图像处理技术识别和验证人类指纹的方法。指纹是每个人独有的生物特征,具有唯一性和稳定性,因此被广泛应用于身份认证领域。指纹图像提取:通过图像处理和特征提取算法,从原始图像中提取出指纹的纹路和图案信息指纹图像匹配:将提取的指纹特征与预先存储的指纹模板进行比对,计算相似度并做出判断当两幅指纹图像的相似度超过设定阈值时,系统判定它们属于同一个人;否则判定为不同人。安
本篇文章从零起步,不讲晦涩公式推导,用大白话讲懂混淆矩阵所有知识点,零基础也能一次性吃透,学完直接用于项目实战、论文实验、模型调优。混淆矩阵是分类任务中最核心的模型评估表格,专门用来直观统计模型预测结果对错分布,主要应用在二分类、多分类场景,日常使用最多的是二分类混淆矩阵。简单理解:把真实标签和模型预测标签两两对应摆放,统计每一种组合的样本数量,形成的二维表格就是混淆矩阵。它的最大作用就是不再只看
对于刚接触机器学习聚类算法的小伙伴来说,K-Means(K 均值聚类) 是最经典的无监督学习算法之一。但很多新手都会遇到一个核心问题:怎么确定聚类的最优 K 值(簇的数量)?本文用啤酒数据集作为实战案例,选择 K-Means 最优聚类数,代码全程可直接运行,有需要可自取。K-means 聚类广泛应用于市场细分、图像分割、文档聚类等领域。例如,在市场营销中,可以将客户划分为不同的群体,以便进行更针对
信用卡欺诈是典型的类别极不平衡的分类问题:正常交易(负样本)远多于欺诈交易(正样本)。如果直接用原始数据训练模型,模型会倾向于把所有样本都预测为“正常”,导致召回率极低。本文使用下采样(Undersampling)平衡正负样本,并用逻辑回归建模,最后通过调整分类阈值提升欺诈交易的召回率。本文通过一个完整的代码实例,展示了信用卡欺诈检测的完整流程:数据标准化与清洗—>下采样处理类别不平衡—>交叉验证