


- @m0_61134850


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
当 GPU、模型和科研 Agent 快速进入实验室,一个容易被忽略的瓶颈开始显现:Agent 能计算,却未必能稳定找到、读取并核验科学证据。AI for Science 的下一层基础设施,不只是更多算力,而是把论文、原文上下文和引用关系变成 Agent 可调用的数据接口。
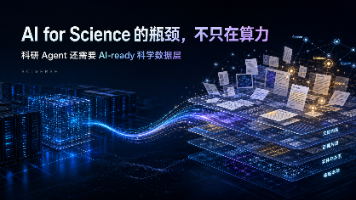
摘要: 主流AI模型(OpenAI、Gemini、Claude、Mistral)近年纷纷推出文档解析功能,支持PDF等格式的直接输入和内容提取。然而,PDF的底层结构(基于坐标而非语义)导致解析存在天然缺陷,表现为表格乱序、公式乱码等问题。测试显示:OpenAI集成简便但易截断;Gemini支持长文档却成本高;Claude语义理解强但结构输出弱;Mistral OCR专注格式转换,准确率达95%+

PDF文档解析痛点与MinerU解决方案实战 文档解析已成为RAG(检索增强生成)系统的关键瓶颈,传统方法在处理双栏论文、复杂表格、扫描件和公式时存在信息丢失问题。MinerU作为新一代文档解析工具,通过结构化转换技术将PDF/Office/图片等转换为机器可读的Markdown/JSON格式,保留文档的完整语义结构。 本文通过实际案例演示了MinerU+LangChain构建PDF问答系统的流程
本文探讨了OCR与MinerU在文档解析中的互补关系,指出OCR仅解决文字识别问题,而MinerU专注于将复杂文档编译成适合大模型使用的结构化知识。文章分析了OCR的局限性(如无法处理语义理解、版式还原等),并介绍了MinerU作为文档解析编译器的核心能力(如标题层级恢复、表格结构化输出等)。通过对比单独OCR与OCR+MinerU组合的差异,提出了三种工程组合方案,强调应避免重复OCR和错误累积

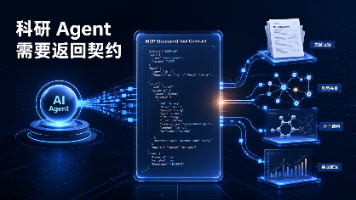
科研Agent工具调用规范正从"能否调用"转向"能否验证输出可靠性"。MCP 2026-07-28规范强化了JSON Schema验证能力,但科研场景需要更严格的证据链契约。 核心问题在于:工具返回必须包含可验证的科研证据特征,包括稳定身份标识(doc_id/chunk_id)、精确位置信息(offset/page_no)和明确语义定义(chunk与score的含义)。Sciverse平台通过分层
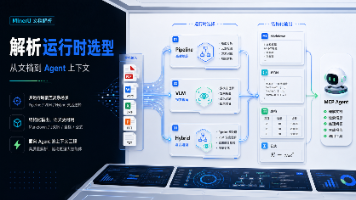
文档解析技术正从单一转换发展为可调度的工程能力,MCP、RAG和科研Agent推动其进入协议层和运行时策略阶段。MinerU作为智能文档解析平台,通过多入口(CLI、Open API、SDK等)和多后端(pipeline、VLM等)支持结构化输出,强调解析策略对OCR质量、隐私、成本等的影响。Agent时代需将解析后端升级为上下文生产策略,根据文档类型、密级等动态选择运行时。RAG效果依赖解析阶段
MCP 正在把工具结果推向带 schema 的结构化内容,科研数据平台也在强调 Agent 可直接消费的 AI-Ready 全文。于是,文档入库的关键不再是“这次能不能解析成功”,而是半年后能否解释、复跑并安全升级。MinerU 的 Markdown、JSON、元素资产与多入口能力,适合成为这条版本链的解析层。
本文探讨了科研Agent面临的核心挑战——数据层级混淆问题。近期Nature和OpenAI事件表明,AI系统容易将局部相关性误认为整体可靠性。文章指出科研工作流需清晰区分四层结构:元数据层(筛选论文池)、证据层(相关片段)、原文上下文层(验证片段)、资源关系层(扩展引用)。现有系统的不足在于将这些层级混为一谈,导致Agent无法判断信息来源的真实性和上下文。作者以Sciverse为例,展示了如何通
科研Agent的核心能力正从单纯提供答案转向构建可审计的证据链路,尤其在需要文献综述的场景中。当前RAG系统存在三大缺口:片段检索无法定位论文族谱、元数据过滤不支持关系扩展、论文级结果与片段结果脱节。Sciverse等平台通过分层接口(候选层、关系层、证据层)将“第二跳检索”标准化,支持Agent沿引用网络扩展并回读原文,更贴近真实科研流程。相比传统检索系统,这类方案强调让Agent持续追踪文献关
科研Agent的核心能力正从单纯提供答案转向构建可审计的证据链路,尤其在需要文献综述的场景中。当前RAG系统存在三大缺口:片段检索无法定位论文族谱、元数据过滤不支持关系扩展、论文级结果与片段结果脱节。Sciverse等平台通过分层接口(候选层、关系层、证据层)将“第二跳检索”标准化,支持Agent沿引用网络扩展并回读原文,更贴近真实科研流程。相比传统检索系统,这类方案强调让Agent持续追踪文献关