- @he_wen_jie


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
交叉熵损失函数给定一个样本xxx,预测1的概率为p(y=1∣x)p(y=1|x)p(y=1∣x),预测为0的概率为1−p(y=1∣x)1-p(y=1|x)1−p(y=1∣x)。p(y)={yy^=11−yy^=0p(y)=\begin{cases}y & \hat{y}=1 \\1-y& \hat{y}=0\end{cases}p(y)={y1−yy^=1y^=0最终得到一
泰勒展开式就是使用多项式函数在x0x_0x0处逼近函数f(x)f(x)f(x),即在x0x_0x0处f(x)f(x)f(x)等于泰勒展开式。虽然是废话,但是一定要好好思考,这个才是核心1. 梯度下降法为什么可以求极值a. 梯度的定义我们通常称在函数f(x)f(x)f(x)某个点上x0x_0x0的变化率为导数,通常可以求出这个点的切线,一般叫斜率,即f′(x0)=limΔyΔx=limf(x0

• 分布改变的补偿:当对多数类进行降采样时,训练集中多数类的概率分布就被人为地改变了。如果直接在这个分布上训练,模型会低估多数类的真实重要性。这时,给降采样后的样本赋予权重(例如,降采样10倍,则权重设为10),正是在补偿这种分布差异。这个权重可以被理解为重要性权重wxpxqxwxpxqx的一种实践,其中pxp(x)px是真实分布,qxq(x)qx是降采样后的分布。
假设检验假设检验是用来判断样本与样本,样本与总体的差异是由抽样误差引起还是本质差别造成的统计推断方法。其基本原理是先对总体的特征作出某种假设,然后通过抽样研究的统计推理,对此假设应该被拒绝还是接受作出推断。样本间差异有两种方式导致这两个或几个样本均数(或率)来自同一总体,其差别仅仅由于抽样误差即偶然性所造成。这两个或几个样本均数(或率)来自不同的总体,即其差别不仅由抽样误差造成,而主要是...
• 分布改变的补偿:当对多数类进行降采样时,训练集中多数类的概率分布就被人为地改变了。如果直接在这个分布上训练,模型会低估多数类的真实重要性。这时,给降采样后的样本赋予权重(例如,降采样10倍,则权重设为10),正是在补偿这种分布差异。这个权重可以被理解为重要性权重wxpxqxwxpxqx的一种实践,其中pxp(x)px是真实分布,qxq(x)qx是降采样后的分布。
• 建议分布pxp(x)px: 当前训练中的 LLM 策略(Policy)。我们利用该模型针对同一个 Prompt 生成NNN个不同的候选响应。• 评估指标: 奖励模型(Reward Model, RM)。它作为一个判别器,为这NNN个样本分别打分rxyr(x,y)rxy,分值高低代表了样本符合人类价值观或逻辑要求的程度。• 目标分布1x1(x)1x: 这是一个理想的“对齐分布”,即那些奖励得分极
数字 M的四位表示 UUID 版本,当前规范有5个版本,M可选值为1, 2, 3, 4, 5。这5个版本使用不同算法,利用不同的信息来产生UUID,各版本有各自优势,适用于不同情景。UUID是一个 128 位无符号整数,通常使用十六进制字符串来表示,以连字号分隔的五组来显示,形式为 8-4-4-4-12,总共有 36个字符(即三十二个英数字母和四个连字号)。数字 N的一至四个最高有效位表示 UUI
sorted排序val=[3,5,1,4,2]# 递增res = sorted(val)print res# output [1,2,3,4,5]# 递减res = sroted(val,reverse=True)print res# output [5,4,3,2,1]按某个关键字排序val = [(5,5),(6,1),(6,2),(3,3),(2,2),(2,1)...
• 建议分布pxp(x)px: 当前训练中的 LLM 策略(Policy)。我们利用该模型针对同一个 Prompt 生成NNN个不同的候选响应。• 评估指标: 奖励模型(Reward Model, RM)。它作为一个判别器,为这NNN个样本分别打分rxyr(x,y)rxy,分值高低代表了样本符合人类价值观或逻辑要求的程度。• 目标分布1x1(x)1x: 这是一个理想的“对齐分布”,即那些奖励得分极
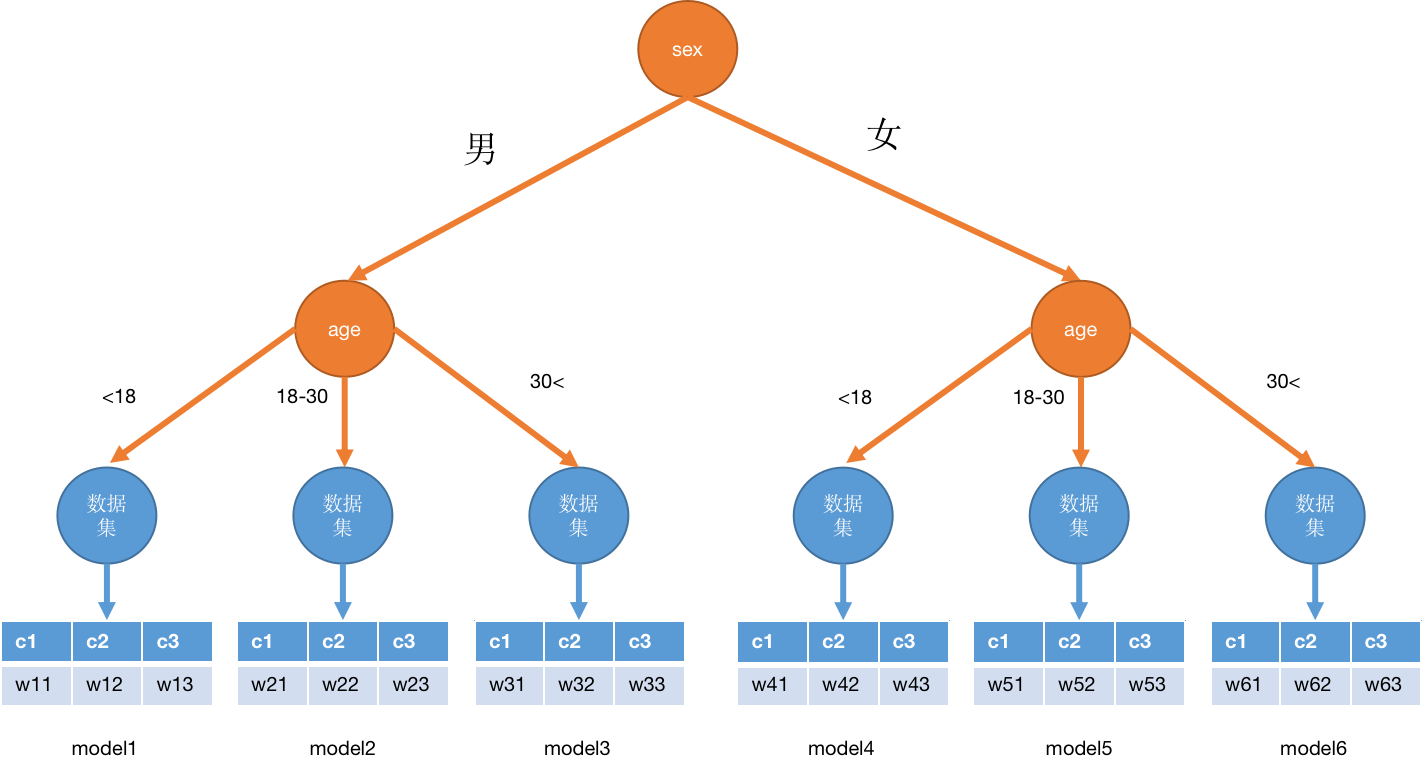
1.困惑之源半年前第一次做推荐算法,无意中碰到了一个问题,我使用LR模型对用户和商品进行联合打分,其中使用了所谓的交叉特征,这个问题思考了大半年终于有了一些思路。问题是这样的,我统计了不同用户在不同类目上的点击率,以此作为所谓的交叉特征,并且将点击率做了一个线上表,当用户请求时,直接查询用户历史所有的类目偏好。其中ucucuc表示用户(user)和类目(cate)的交叉特征,这里为点击率,下标表示