


- @guoqi_666


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
面对工具返回数据过载导致上下文爆满的问题,应构建“源头窄化—预处理过滤—分批处理—截断兜底”的四层防线。核心原则:优先在接口层限制返回量(如禁用select*、加limit、不传正文),避免数据在多轮中重复携带;预处理阶段清洗、过滤、摘要需保留回查入口;大结果集采用分页或文件索引模式;截断仅作兜底,并显式标注缺失信息。成本与收益呈乘轮放大,源头优化最高效。精确字段永不进摘要,组合策略依场景而定。根

本文系统探讨Agent记忆管理的核心挑战:默认的“只追加+相似度检索”方案会导致旧记忆越用越顽固,新信息被压制。作者提出两条核心机制——差异化衰减(按重要性设定半衰期,硬约束近乎永久保留)与冲突分类处理(区分状态变更、真实矛盾等四类关系,动作各异),并强调“过期不等于删除”,采用失效标记而非物理删除以保障可回溯与审计。工程上需解决并发读写、合并误判与调参激进等陷阱。最终以四个问题评估方案真伪:衰减

本文分享作者从“万能Agent”陷阱中汲取的架构教训:将意图识别(Router)与执行逻辑(Skill)解耦,实现稳定可扩展的AI系统。核心观点包括:Router仅输出结构化路由计划,不掺杂业务逻辑;Skill是带风险等级、工具白名单和确认策略的能力契约;面对复合意图,需显式表达步骤依赖;上百个Skill时采用“召回+精排”两段式路由;通过用户纠正入口与埋点实现自我进化。最终强调:路由本质是信息压
本文系统区分了“自检”与“反思”的本质差异,提出反思是带判定标准与收敛条件的纠错链路。作者基于四阶段结构(结果校验、错误复盘、迭代修正、沉淀总结)构建可落地的反思机制,并通过线上案例说明:仅靠调优prompt无法解决空结果问题,必须在工具返回后加入确定性校验与参数修正。文章进一步将反思分为三类场景,强调工具层纠错性价比最高,需优先实现。上线前守住迭代上限、错误分类与模块解耦三条底线,避免资源浪费。

摘要"保叙事丢约束"是有损的——预算、格式、排除项最先丢。硬约束必须存显式状态。

本文深入剖析Agent取消功能的五层实现:从前端断请求到分布式对账,揭示“停止生成”按钮背后的复杂性。指出多数实现仅停留在第一层(断连接),导致任务仍在后台运行、数据脏写。真正完整的取消需在步骤边界设置检查点,状态落库分三态(运行中/申请取消中/已取消),结合幂等键与执行台账保障数据一致性,并通过业务单号对账解决“是否已执行”的不确定性。强调取消应为独立终态,不可归入失败以避免自动重试。最终提出面
1.xshell和xftp的简述XshellXshell是一个用于MS Windows平台的强大的SSH,TELNET,和RLOGIN终端仿真软件。它使得用户能轻松和安全地从Windows PC上访问Unix/Linux主机。XftpXftp是一个用于MS Windows平台的强大的FTP和SFTP文件传输程序。Xftp能安全地在Unix/Linux和Windows PC之间传输文件。Xftp和X
开发钉钉过程,遇到的错误,记录一下。遇到的错误:{errcode: 88,sub_code: "40000",sub_msg: "access_token is blank",errmsg: "ding talk error[subcode=40000,submsg=access_token is blank]",request_id: "9wwm75auaqk3"}根本不是“access_tok
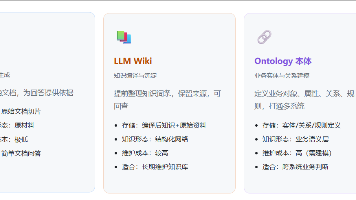
2026年知识库建设进入“三巨头”时代:RAG、LLMWiki与Ontology本体分工明确。RAG负责检索资料,提供回答依据,适合简单问答;LLMWiki实现知识编译与沉淀,支持长期积累与跨文档综合;Ontology则定义业务实体与关系,打通多系统语义壁垒。三者非替代关系,而是按需选用——先用RAG验证需求,再依场景升级至LLMWiki或引入Ontology。未来趋势为RAG下沉为基础设施,LL
问题如图:解决办法:左侧不见的解决办法:右侧不见了的解决办法:亲测好用