- @gongdiwudu


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在本章中,我们将探讨进行假设检验时需要了解的 3 个重要分布:总体分布、样本分布和抽样分布。最重要的是,我们将探索它们之间的关系,以便您不仅内化它们是什么,而且内化它们为什么重要。
正则化表达式,主要解决字符串的匹配问题,一般用于数据挖掘、或者网络爬虫;正则表达式有完整理论,这里只能粗略介绍,理解这些理论很重要,因为纯粹记忆掌握有些人做不到,有些人做到,但很艰难。因为正则化工具很多,版本不同、符号不同,但来自一个根源,本文尽量通过简单表述,呈现其理论基础。......
在Ubuntu上启动连接WIFI服务器;通常有几个命令可用,这里将其一一列出,以便需要的时候查阅。
强化学习(RL)是机器学习的一个分支,它不同于监督学习和无监督学习。事实上,“强化”一词指的是一种基于奖励的学习方式,它能够解决决策问题,在这种学习方式中,智能体通过反复试错,自主地与所处环境进行交互。
为此,唯一需要做的更改是调整他们的更新公式,以使用不是来自下一个状态的信息,而是来自。,我们还强调了一步式 TD 算法相对于 MC 方法的优势,以及它们如何实现更快的收敛。代理的目标是找到到 X 的最短路径。将一步 TD 和蒙特卡洛方法推广到 n 步算法中,在强化学习中起着重要作用,因为 n 的最佳值通常位于这两个极端之间。在一步 TD 中,我们分析收到的奖励与状态值如何变化之间的差异,从当前状态
在 2024 年暑假假期期间,Tim学习并应用了Q-Learning (一种强化学习形式)来训练神经网络玩简化版的俄罗斯方块游戏。在本文中,我将详细介绍我是如何做到这一点的。我希望这对任何有兴趣将强化学习应用于新领域的人有所帮助!

强化学习(RL)是机器学习的一个分支,它不同于监督学习和无监督学习。事实上,“强化”一词指的是一种基于奖励的学习方式,它能够解决决策问题,在这种学习方式中,智能体通过反复试错,自主地与所处环境进行交互。
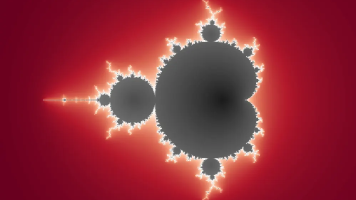
了解混沌,请读詹姆斯·格雷克(James Gleick)的精彩著作《混沌:一门新科学》(Chaos: Making a New Science) ,它让我们领略了混沌的科学原理和美妙之处。理解蝴蝶效应、奇异吸引子、曼德勃罗集等概念。此外,用Python重现书中那些精美的可视化图表也让我们增加参与感,下面将展示其中的一些。
在本文中,您将了解这种类型的 Transformer 模型。你还将学习如何使用 Python、默认 Transformer 模型和 HuggingFace Transformers 库构建自己的对象检测管道。事实上,这将非常简单,所以让我们一起来看看吧!
关于用python抽样,一般我们用均匀分布抽样,高斯分布抽样,但还有许多分布的抽样如何实现?本文针对此类问题,探讨如何用python去实践。