- @gnwu1111


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
2.需要从这么大的文件中做筛选,如果用普通的思维方法,查找速度很慢因此可以从这两个方面着手去思考回答思路。面试官更多的是去考察候选人的技术思维和技术积累,因此大胆一点回答没有关系。进行分割成大小为512KB小文件,总共得到2048个小文件,避免一。,小顶堆中最终得到的100个单词,就是top 100了。另外,对于这类问题,我们可以发散自己的思维去回答。不管怎么变,top k问题的本质是一样的。k问
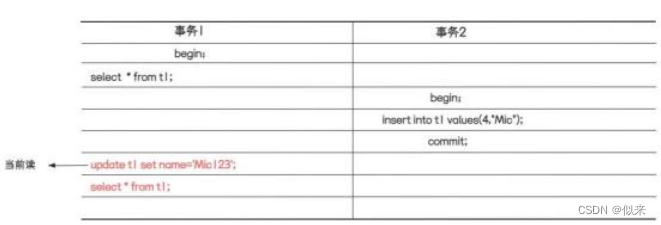
这样一种情况{如图},在事务1里面通过update语句触发当前读的情况下,就。导致幻读的根本原因是,触发的当前读操作,绕过了快照读,从而导致MVCC机制。会导致在该事务中的前后两次查询的数据行数不一致,从而出现幻读的现。所谓的幻读,表示在同一个事务中的两次相同条件的查询得到的。中的RR事务隔离级别,在特定的情况下会出现幻读的问题。RR级别下,具体什么情况下会出现幻读呢?为了避免出现这类的情况,我们
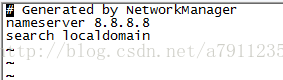
将onboot改为yes,重新启动网络,service network restart,然后ping www.baidu.com如果通了的话,就证明链接成功。这样就可以正常yum update了解决方法::wq保存退出即可,之后再执行yum操作,成功!
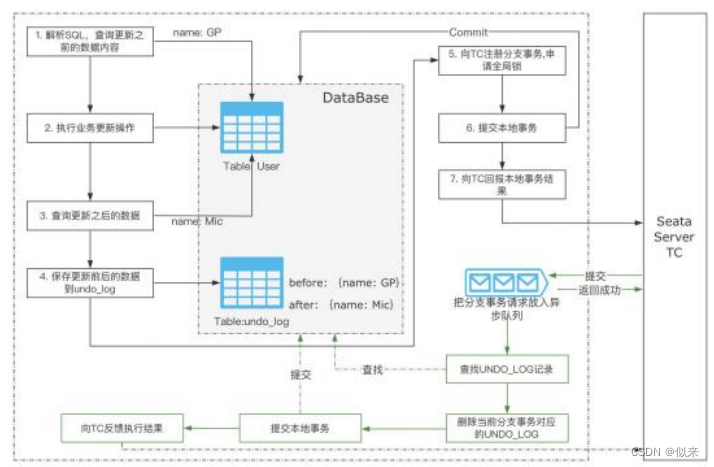
很多面试官都喜欢问一些“谈谈你对xxx技术的理解”,大家遇到这种问题时,是不是完全不知道从何说起.那么我们来看一下,普通人和高手是如何回答这个问题的?问题解答1.在微服务架构下,由于数据库和应用服务的拆分,导致原本一个事务单元中的多个DML操作,变成了跨进程或者跨数据库的多个事务单元的多个DML操作,而传统的数据库事务无法解决这类的问题,所以就引出了分布式事务的概念。2.分布式事务本质上要解决的就
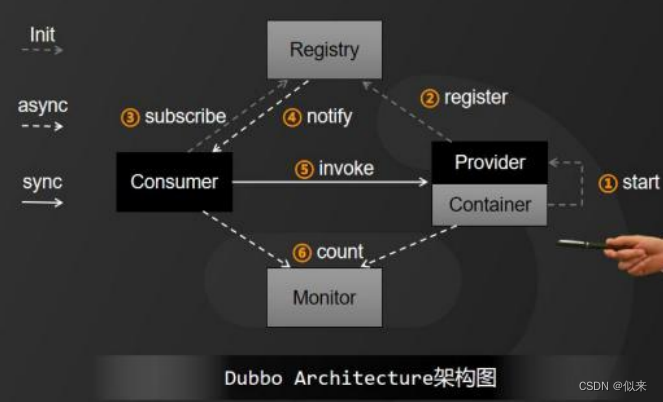
其实个人不太愿意,拿Dubbo和SpringCloud进行对比,因为它俩最初出现并不是为了解决同一类问题。但是国内技术是在太卷,加上微服务的盛行,很多互联网大厂也经常会问到这个问题。那么今天,还是给大家来详细聊一聊。两者对比关于Dubbo和SpringCloud的优缺点,以奈菲(Netflix)版本为例,从以下5个方面来分析:1、从整体架构上来看Dubbo和SpringCloud的模式都比较接近,
3.从业务层面来考虑,限制页数,一般情况下用户去翻 100W 页来找数据,如果让你 们老板去翻 100w 页,估计第二天就把你开除了。我们通常会通过搜索来优化查找过程。以上就是这个问题的回答思路,面试的时候不一定要完全陷入到面试官的逻辑中,也可以跳出来思考。需要注意 id 是索引列 ,通过索引排序后再 limit ,同样减少了计算次数。关于这个问题 ,有多种解决方案 ,大家可以在回答的时候尽可能的
存储过程的优化和维护很麻烦,随着业务的发展,数据库的表结构也许会发生变化,这些变化需要同步给到存储过程,并且有可能原来的SQL语句的执行计划不是最优的,也需要重新维护。2.存储过程的一致性很差,如果从Oracle迁移到MySQL,涉及到部分数据库独有特性的时候,整个存储过程就需要重写,不仅成本高,而且还有可能对上游业务造成影响。3.存储过程的管理比较困难,一旦存储过程的量比较大的时候,就会陷入到一
1.加索引,增加索引是一种简单高效的手段,但是需要选择合适的列,同时避免导致。分库分表,在单表数据量较大或者并发连接数过高的情况下,通过这种方式可以有。分离,针对读多写少的场景,这样可以保证写操作的数据库承受更小的压力,2.避免返回不必要的数据列,减少返回的数据列可以增加查询的效。优化SQL的结构,比如是否走全表扫描、避免子查询等。基本上回答到这个程度得到面试官的认可是没问题,不。过要注意,面试官
解决办法就是可以在instance这个变量上增加一个volatile关键字修饰,volatile底层使用了内存屏障机制来避免指令重排序。会导致其他线程可能拿到一个不完整的对象,也就是这个instance已经分配了引用实。主要还是对线程安全性层面的指令重排序,以及volatile关键字的考察。问题,是在基于双重检查锁设计下的单例模式中,存在不。按照重排序规则,在不影响单线程执行结果的情况下,这个实例
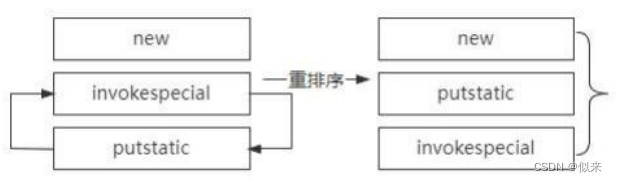
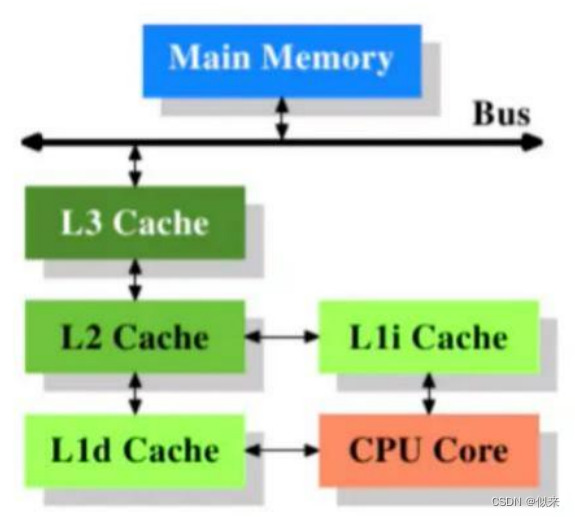
并发编程是每个程序员必须要掌握好的领域,它里面涵盖的设计思想、和并发问题的解决思路、以及作为一个并发工具,都是非常值得深度研究的。(如图)CPU层面的高速缓存,在CPU里面设计了三级缓存去解决CPU运算效。面,针对MESI协议的更进一步优化去提升CPU的利用率,引入了。效率问题,但是带来的就是缓存的一致性问题,而在多线程并行执行。所谓重排序,就是指令的编写顺序和执行顺序不一致,在多线程环境。2、编