


- @franktaoge


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
从0到1配置eslint (所有人一看就懂)
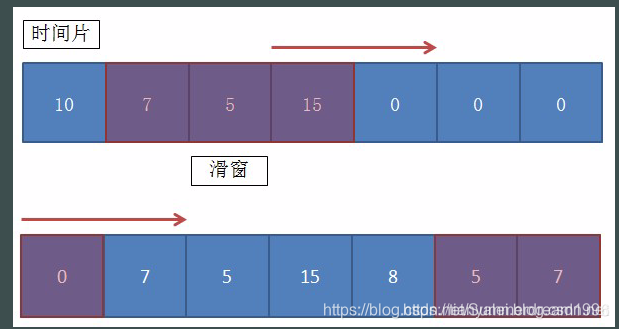
本文将深入探讨高频算法中的双指针、滑动窗口以及二叉树。题目均来源于leetcode。重点关注每种题目的解题思路和总结,通过详尽的解答,包括解答思路和每一步的代码实现,以帮助读者快速理解并掌握这些算法。
一、使用方式1、字面量模式var reg = /is/g全局匹配'is'2、构造函数RegExpvar reg = new RegExp('is','g');二者区别:正则表达式字面量始终共享同一个RegExp实例,而使用RegExp每次创建一个新的实例,如下面的代码:var re=null;for(var i =0;i<4;i++){...
一、前言在系列一中桃子叔叔介绍了使用iview-cli构建项目框架并基于框架进行的相关改造,主要包括:路径规范dev-server配置启用热更新封装axios解决跨域需要温习的小伙伴请点击此处回顾手把手,从无到有带你用vue进行项目实战 系列一(搭建框架篇)二、问题经过以上的改造,已经能够满足基本生产开发的需求了,运行npm run dev便可以查看开发环境...
`React Diff` 算法是 `React` 用于比较虚拟 DOM 树之间差异的一种高效算法。其目的是在更新组件时,尽可能高效地找出真实 DOM 中需要更新的`最小部分`,从而减少不必要的 DOM 操作,提高渲染性能。会将当前组件与该组件上次更新时对应的`Fiber`节点进行比较,将比较的结果生成新的`Fiber`节点

通过以上路线,您可以在12-18个月内完成转型,胜任智能汽车AI视觉算法岗位。如需具体资源链接或进一步调整计划,可随时沟通!:掌握Python和C++基础语法,巩固数学与算法基础。:掌握大模型原理、微调与部署,结合多模态应用。:深入智能汽车行业应用,掌握端到端解决方案。:掌握深度学习框架和计算机视觉核心算法。
摘要 本文系统调研了多模态大模型数据蒸馏的主流方法,首先介绍了多模态模型和知识蒸馏的基础概念,为零基础研究者建立知识框架。随后详细阐述了文献调研方法,包括学术数据库检索策略、关键词组合技巧和严格的文献筛选标准。核心部分分析了四种主流蒸馏技术:基于架构优化的MoE蒸馏、跨模态对齐的语义解耦蒸馏、轻量化高效蒸馏以及特定任务定制蒸馏,通过性能参数对比表直观展示各方法优劣。最后提供了实践指导,包括数据准备
全面解读大模型数据蒸馏---基于架构优化的蒸馏参考论文:LLaVA-MoD: Making LLaVA Tiny via MoE Knowledge Distillation论文地址:https://arxiv.org/pdf/2408.15881github代码地址:https://github.com/shufangxun/LLaVA-MoD这类方法通过优化学生模型的结构来提高知识蒸馏效率,其
摘要: 数据集蒸馏技术通过将海量数据压缩为少量合成样本,使模型获得接近全量数据训练的性能。2025年的前沿方法NCFM和ROME分别解决了效率与鲁棒性问题。NCFM采用极小极大优化框架,利用神经特征函数匹配分布,显著降低资源消耗(显存减少300倍);ROME则首次引入信息瓶颈理论,提升模型抗攻击能力(鲁棒性指标提升至103.09%)。当前主流技术分为元学习、分布匹配和轨迹匹配三类,面临计算成本高、
《MST-Distill:跨模态知识蒸馏的专业化教师混合框架》提出创新方法解决AI模型跨模态学习中的教师选择与知识漂移问题。该框架通过三阶段实现:协作初始化促进模型协同学习,MaskNet模块过滤适配知识,GateNet动态选择最优教师组合。实验表明,相比传统方法性能提升3-8%,在自动驾驶、医疗诊断等领域具有应用潜力。核心贡献在于建立了多教师动态辅导新范式,有效解决了知识传递中的注意力不匹配问题