- @dddddsxh


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
高质量知识库合理的文档切分可靠的向量检索可控的 Prompt模型生成引用溯源安全兜底人工接管支持 Markdown、TXT 和 PDF 文档;支持本地向量索引;支持多轮对话上下文;支持 OpenAI 兼容模型接口;支持答案引用来源;支持低置信度自动兜底;支持敏感请求拦截;支持后续扩展混合检索和重排模型。在实际企业项目中,建议优先完善知识库、权限控制、数据脱敏和评估体系,再考虑更换更大的模型。模型规

大模型开发不是“调参侠”的游戏,而是一套系统工程。微调考验的是对数据和任务的理解——知道什么时候该用LoRA、什么时候该用QLoRA、数据该怎么构造。RAG考验的是对检索系统的把控——文档怎么切、向量怎么存、检索怎么优化、多轮对话怎么处理。推理部署考验的是工程化能力——vLLM怎么配置、TTFT和TPOT怎么优化、量化方案怎么选。这三个环节环环相扣,任何一个环节掉链子,整个系统都无法在生产环境稳定
构建全栈大模型智能体系统,技术栈横跨模型层、数据层、编排层、记忆层和治理层,要求开发者具备从算法思路到工程落地的全链路能力。业务理解力:深刻理解垂直场景的工作流架构设计力:设计高内聚、低耦合的Agent系统编排治理力:让多个Agent协同工作且安全可控从“代码编写者”进化为“智能体编排者”,这不仅是技术的升级,更是思维方式的重塑。当大模型能力逐渐同质化,系统架构能力才是真正的技术护城河。
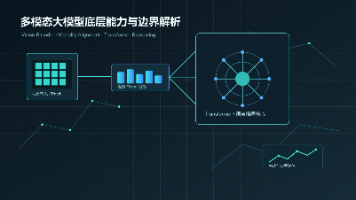
多模态大模型的本质,是将不同模态的数据转换到可以交互的表示空间,再利用Transformer或扩散模型完成理解、推理和生成。高质量的视觉和语言表示;模态之间有效的语义对齐;大规模、多样化且经过清洗的数据。视觉Token会丢失细节;语言先验会引发幻觉;精确计数和空间计算不稳定;生成结果不代表事实正确;高风险场景需要外部验证。真正的工程重点不是简单地“调用一个视觉大模型”,而是围绕输入质量、视觉编码、
Ollama 降低了本地运行大语言模型的门槛。它不仅适合个人开发者进行模型实验,也适合企业搭建内网 AI 应用。Ollama模型服务业务API服务Prompt模板向量数据库日志和监控如果项目只需要简单问答,可以直接调用/api/chat。如果需要企业知识库,则应当结合嵌入模型和向量数据库构建 RAG。如果需要复杂的多步骤任务,还可以进一步接入 LangChain、LangGraph 或 MCP。

状态是图中所有节点共享的数据结构。表示字段可以不是一开始就全部存在。不同节点可以逐步补充状态。LangChain 解决的是大模型应用开发中的组件复用问题,LangGraph 解决的是复杂任务中的流程编排问题。用户输入意图识别流程路由检索 / 工具 / 普通问答结果生成事实校验人工审批或最终输出LangChain 适合封装模型、Prompt、工具和检索器;LangGraph 适合表达条件分支、循环、

统一聊天接口OpenAI 风格响应格式Docker 容器化部署模型懒加载多模型加权调度模型版本固定调用模型别名管理HuggingFace 模型缓存持久化基础健康检查和模型查询在实际项目中,还可以继续扩展流式输出、Redis 限流、Prometheus 监控、日志追踪、请求队列和 GPU 负载均衡等能力,逐步演进为完整的大模型服务平台。

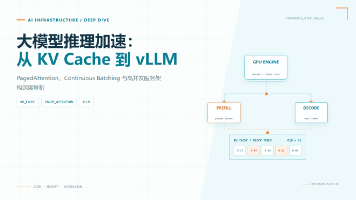
本文探讨了大模型推理中KV Cache的优化机制及其对性能的影响。KV Cache通过缓存历史Token的Key和Value,避免了重复计算,大幅提升推理效率。文章分析了KV Cache的显存占用公式,指出其与模型层数、Batch Size和序列长度成正比。同时介绍了GQA(Grouped Query Attention)通过减少KV Heads数量来降低显存消耗的原理。实验对比显示,启用KV C
摘要:本文探讨了如何构建真正可用的企业知识库系统,指出仅依赖大模型和简单文档处理会导致实际应用中的诸多问题。文章提出Dify与RAGFlow结合的解决方案:Dify负责应用层编排、工作流和模型调用,RAGFlow专注文档解析、知识管理和混合检索。关键实施步骤包括:精细化文档解析(保留结构、表格、版本等元数据)、语义化切片策略、混合检索(结合向量和关键词搜索)及权限前置过滤。通过这种架构,企业可将A
Agent性能优化三要素:降本提速的关键策略 本文从性能地图、Token优化和响应加速三个维度提出Agent优化方案。核心发现: 性能瓶颈集中在LLM推理(60%)和工具执行(30%) Token成本管理策略: 系统提示瘦身可降固定成本 提示缓存技术实现90%成本折扣 动态Token预算管理上下文窗口 响应优化方案: 工具并行执行减少30%等待时间 小模型路由简单请求 流式输出提升用户体验 通过系