


- @Z_suger7


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Selenium是一种用于自动化浏览器的工具,可以用于模拟用户行为,特别是在访问需要进行登录的网站的时候,直接可以使用Selenium和HTTP代理来模拟真实用户行为,绕过网站反爬虫机制,以及保护我们的隐私。看过网上很多关于爬虫的文章中添加代理IP都是使用的requests模块,但是爬虫做久了之发现很多人都在使用selenium,所以这里补充一个selenium添加代理。关于代理的使用这里需要注意
读表三参数中的data_onlyread_onlymin_row,决定了读取的正确性与性能;职责拆分:收集、统计、输出各自成函数,脚本才具备可维护、可交接的工程属性;产出必验:小样本、总量、行数三重对照缺一不可,宁可慢一步,不可错一分。但比结论更重要的,是模板意识。第一次编写合并报表脚本或许需要一小时;可一旦将其沉淀为带完整注释与类型标注的模板文件,下个月、下季度乃至换一批数据源时,往往只需改动数
然而,我们在使用爬虫时经常会遇到一些问题,比如被网站封禁、请求速度慢或频繁的请求可能会给目标网站带来额外的负担,导致我们的请求被拒绝或者引起对我们的反制措施。我们可能无法获取到最新的数据,从而影响我们的业务决策和竞争力。方法一:手动维护User Agent列表 你可以手动创建一个包含多个User Agent的列表,然后在每次请求时随机选择一个User Agent使用。这样可以保证每次请求使用的Us
幸运的是,Python提供了强大的工具和库,可以帮助我们实现办公自动化,从而提高工作效率和准确性。通过使用Python进行数据可视化和报表生成,我们可以实现办公自动化,提高工作效率和准确性。Matplotlib和Seaborn可以帮助我们深入展示数据特征和趋势,Pandas和Openpyxl可以帮助我们处理和生成表格的报表。在Python中实现办公自动化的数据可视化与报表生成时,我们可以使用一些常
在互联网时代,许多网站通过JavaScript动态加载内容,传统的静态网页爬取方法难以应对。本文介绍了如何使用Python爬取JavaScript加载的数据,主要方法包括分析网络请求、使用Selenium模拟浏览器行为以及使用Pyppeteer进行无头浏览器爬取。通过分析AJAX请求,可以直接获取数据;Selenium和Pyppeteer则能模拟浏览器操作,获取动态生成的内容。文章还提供了详细的代
等级特征典型做法L1 探索人工写 Prompt,人工跑 Pandas临时性、一次性分析L2 标准化Prompt 模板化,代码生成 + 自动校验团队内可复用、可测试L3 流水线采集→清洗→计算→解读 全自动,含治理与监控生产级、可观测、可审计Prompt 与 Pandas 的结合,本质是把**“会算”(Pandas 的确定性)与Layer 1:用 Prompt 指挥 AI 生成可验证的 Pandas
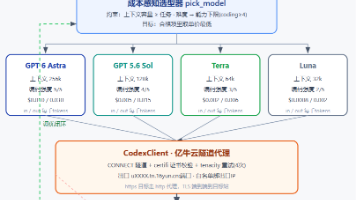
选型不是一个拍脑袋的动作,而是一组可度量的约束。配置收进 dataclass,选型抽成带成本和能力约束的独立函数,跑批效果用 Metrics 回收,代理走亿牛云隧道解决国内访问,整套基本能自治。先把最小可用版本跑通,再拿真实的 p95 和成本往细里调,比一上来追求完美方案实在。Codex 把模型摆在你面前,怎么用省、怎么用稳,才是真功夫。
真人会移动鼠标、滚动、逐字输入。")
选择隧道而非前向代理,原因在于隧道把 IP 轮换和健康度管理收敛到代理侧:业务每次请求都打到固定隧道入口,由亿牛云在后端按策略切换出口 IP 并自动剔除被封节点,代码里不需要维护 IP 池、不需要写健康检查。回调里出现 CPU 密集的同步代码,比如大文档的 XPath 批量抽取、深回溯正则、或者 JSON 反序列化后的字段规整,reactor 就会被这一个回调独占,事件循环无法推进,同进程内其他所
若手动编写中间件伪造指纹、模拟浏览器环境,需要大量额外开发工作,维护成本居高不下。而新一代一体化 Python 爬虫框架从底层重构,内置 Playwright/Chromium 渲染内核,同步静态请求与浏览器渲染能力,原生模拟真实浏览器指纹,无需额外拼接第三方工具,一站式解决动态页面渲染、反爬识别、并发调度三大核心痛点。对于长期受 Scrapy 动态页面渲染、网站反爬拦截困扰的开发人员,切换一体化