


- @JuiceFS


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
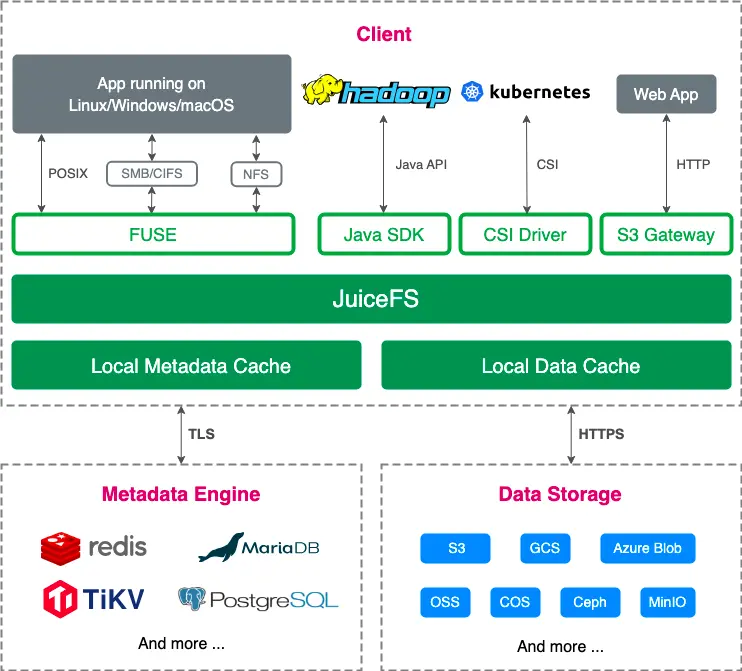
自 2021 年 7 月 JuiceFS CSI Driver 首次推出以来,随着 Kubernetes 用户数量的增长和集群规模的不断扩大,面对的应用场景也愈发复杂。过去三年多的时间里,我们对 JuiceFS CSI Driver 在稳定性、管理权限等关键领域进行了持续的优化和改进,这使得 JuiceFS 能够有效地适应各种复杂的需求,成为 Kubernetes 环境中数据持久化的理想选择。
4 月 7 日,AWS 官方发布了一项新服务——Amazon S3 Files,允许用户无需搬迁数据,即可将 S3 存储桶作为高性能共享文件系统挂载到计算节点上。这不是业界第一次尝试让 S3 以文件系统方式被访问:从早期的 s3fs,到 AWS 后来推出的 Mountpoint for Amazon S3,再到今天的 S3 Files,S3 “像文件系统一样被访问”这条路,其实已经走了很多年。
本文探讨了 JuiceFS 在 Hadoop 环境中的使用方法及其优势,而在部分业务场景下,直接采用 HDFS 或对象存储会是更适配的选择。例如,当业务需要依托数据本地性实现高效快速处理时,建议将数据存储于 HDFS 中;此外,针对访问频率较低的数据,或采用 Iceberg 等专为对象存储优化的数据格式时,直接使用对象存储则更为简便。需在 Kubernetes 与 Hadoop 环境之间实现数据共
在大规模 AI 推理服务中,当集群扩容时,新增推理实例从创建到承接请求,需要经历容器镜像准备、文件系统挂载、运行环境与推理框架初始化、模型权重加载等一系列冷启动过程。随着镜像体积和模型权重规模不断增长,数据准备的耗时日益突出;大规模扩容时,大量实例同时启动,还会进一步增加 Registry、网络和后端存储的并发压力。针对这些问题,行业已经形成了多种优化思路,包括缩小镜像体积、通过 P2P 分发缓解
本文探讨了 JuiceFS 在 Hadoop 环境中的使用方法及其优势,而在部分业务场景下,直接采用 HDFS 或对象存储会是更适配的选择。例如,当业务需要依托数据本地性实现高效快速处理时,建议将数据存储于 HDFS 中;此外,针对访问频率较低的数据,或采用 Iceberg 等专为对象存储优化的数据格式时,直接使用对象存储则更为简便。需在 Kubernetes 与 Hadoop 环境之间实现数据共
在 AI 训练、数据集管理等大规模文件访问场景中,随着文件数量和访问并发增加,元数据层往往更早成为性能瓶颈。无论是删除百万级小文件、克隆大规模数据集,还是高并发目录遍历,元数据引擎的响应能力都会直接影响上层业务效率。
星辰征途是一家聚焦 AI 搜索与电商场景多模态 AIGC 应用的初创公司,成立两年多,业务主要面向海外市场。公司目前的主要产品包括:Gensmo(gensmo.com) 聚焦时尚穿搭,提供虚拟试穿、造型推荐和商品搜索;ZooClaw(zooclaw.ai) 面向更广泛的生活与工作场景,提供 AI Agent 服务。本文将介绍星辰征途业务背后的存储实践,分享我们在统一存储选型、架构设计和性能调优中的
在 AI 训练、数据集管理等大规模文件访问场景中,随着文件数量和访问并发增加,元数据层往往更早成为性能瓶颈。无论是删除百万级小文件、克隆大规模数据集,还是高并发目录遍历,元数据引擎的响应能力都会直接影响上层业务效率。
JuiceFS 社区版 1.4 增强了分层存储能力,支持以单文件或目录为粒度指定对象存储类型,使用户可以在文件系统语义下管理不同数据的存储层级。本文将围绕这一能力,介绍其应用背景、方案演进、使用模型、实现思路以及后续演进方向。
在统一文件存储基座之上,我们将进一步建设面向业务的数据管理能力,帮助用户更清晰地理解数据分布、访问行为和资源使用情况,为后续的数据治理、成本优化和业务决策提供支撑。以上是小米在统一文件存储基座建设中的阶段性实践。我们也期待与业界同行持续交流,共同探索更多技术实践。我们希望本文中的一些实践经验,能为正在面临类似问题的开发者提供参考,如果有其他疑问欢迎加入。