- @AIMing_byte


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
程序员转行 AI 大模型学习第 1 天
本文介绍了注意力机制的三个重要扩展版本。自注意力机制(self-attention)中Q、K、V来自同一序列,通过计算序列内部元素的相关性来捕捉特征。掩码注意力通过添加下三角掩码矩阵,实现只能关注已生成内容的功能,适用于序列生成任务。多头注意力则从多个角度并行计算注意力,将不同视角的特征拼接起来,增强模型的表达能力。文中通过搜索引擎查询的类比解释了这些机制的原理,并提供了对应的实现代码示例,展示了
本文介绍了Transformer模型的整体结构及其实现细节。模型采用Encoder-Decoder架构,包含词嵌入层(wte)、位置编码层(wpe)、Dropout层、编码器(Encoder)和解码器(Decoder)等核心组件。特别讨论了LayerNorm的位置问题,指出实际实现中多采用"Pre-Norm"结构(归一化在Attention层前)而非论文中的"Post
本文介绍了Transformer模型中的位置编码机制。位置编码通过为每个词添加包含位置信息的向量,解决了模型无法识别词序的问题。文章详细解释了正弦位置编码的实现原理,包括其数学公式和参数设置,并展示了位置编码与词向量相加的具体过程。此外,还对比了三种位置编码类型:正弦位置编码(固定公式、无需参数)、可学习位置编码(可优化但需参数)和旋转位置编码(适合长序列)。正弦位置编码因其简单性和可外推性被应用
本文介绍了AI大模型中的Function Calling功能,通过外部工具增强模型能力。文章以获取天气信息为例,展示了完整的实现流程:1)定义函数JSON Schema;2)开发者实现具体函数;3)LLM分析是否需要调用函数;4)开发者手动执行函数;5)将结果返回LLM生成最终回答。重点强调LLM仅负责分析需求和生成请求,不执行具体函数或调用API。文中提供了详细的Python代码示例,帮助理解F
本文介绍了程序员转行学习AI大模型的关键知识点——提示词工程。主要内容包括:模型参数设置(Temperature和Top_p)、提示词四要素(指令、上下文、输入数据、输出指示),以及提示词工程技术(少样本提示、链式思考CoT和自我一致性)。文章强调通过逐步引导和示例训练,可以提升模型处理复杂任务的能力,并推荐了相关学习资源。适合AI初学者构建大模型知识体系。
本文是程序员转行学习AI大模型的第11篇笔记,主要介绍了首次调用AI大模型的完整流程。内容包括:获取API密钥和基础URL、配置环境变量、选择模型名称等关键步骤,并提供了可直接运行的Python代码示例。文章详细说明了OpenAI客户端的使用方法、必需参数和常用可选参数(如temperature)的设置技巧,帮助开发者快速上手AI大模型调用。适合正在从零开始构建AI知识体系的开发者参考学习。
本文介绍了程序员转行学习AI大模型的核心知识点——智能体(Agent)的概念与实现。Agent作为能感知环境、决策执行的智能系统,包含LLM(大脑)、工具调用、记忆存储和任务规划四个核心组件。文章通过查询天气并发送提醒的示例,详细说明了Agent的内部运行流程,并提供了一个简单的Python实现代码,演示了如何构建具有天气查询和计算功能的对话式Agent。文中还推荐了相关学习资源,帮助读者从零开始
本文介绍了RAG(检索增强生成)技术,这是程序员转行学习AI大模型的第14个核心知识点。RAG通过结合LLM和检索技术,利用外部知识库增强大模型生成能力。文章详细阐述了RAG的6个核心流程步骤:问题向量化、向量检索、文档排序、上下文构建、Prompt构建和LLM生成,并提供了Python代码示例。RAG的优势包括减少幻觉、提高准确性、可解释性强、易于更新知识库和成本可控。每个步骤都配有清晰的代码实
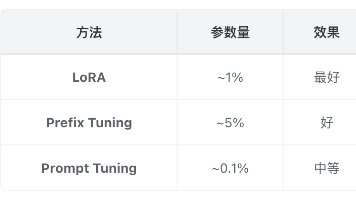
本文系统梳理了AI大模型微调的核心概念与技术路线。首先区分了预训练(通用知识学习)与微调(领域知识训练)两个阶段,将微调方法按数据类型分为监督微调(SFT)和偏好优化(PO),按参数量分为全量微调与PEFT(含LoRA、Prefix Tuning等方法)。重点对比了DPO与PPO两种偏好优化算法的优缺点,并给出问答系统、对话助手等场景的微调方案建议。文章为开发者提供了从理论到实践的完整微调知识框架