
Python后端AI专题03:为什么需要 Transformer:从串行记忆的瓶颈出发
Python后端AI专题03:为什么需要 Transformer:从串行记忆的瓶颈出发
上一篇练习的完整答案
先给出完整表格。分类必须由前三个事实列推导,不能看见“智能客服”之类的产品名称就猜答案。
| 系统 | 是否从样本学习 | 是否使用神经网络 | 是否生成语言 | 分类 | 特有失败模式 | 一个共同后端问题 |
|---|---|---|---|---|---|---|
| 根据金额和国家黑名单拦截支付 | 否 | 否 | 否 | 规则程序 | 两条规则互相冲突,或旧黑名单没有及时发布 | 输入校验:金额、币种和国家代码必须合法 |
| 根据 30 个数值特征预测客户是否流失 | 是 | 否 | 否 | 传统机器学习 | 线上客户分布改变后,训练时的规律不再适用 | 版本记录:请求必须能追溯到具体模型版本 |
| 从发票照片中识别金额 | 是 | 是 | 否 | 深度学习识别 | 图片模糊、旋转或出现训练集未覆盖的版式 | 超时:大图和批量识别不能无限占用推理资源 |
| 根据知识库生成客服回复 | 是 | 是 | 是 | 大语言模型应用 | 资料不足时仍生成听起来合理的错误回答 | 日志与监控:记录耗时、失败类型和引用数量 |
这里的“共同后端问题”不是说每类系统只能选表里那一个。输入校验、超时、日志、监控和版本记录四类系统都需要;表格只是为每行写出一个可以落到代码的例子。
代码动作 1:只改变一个事实,分类为什么跟着变
上一篇让你把“知识库客服回复”的 generates_language 临时改成 False。不必真的破坏源码,也可以复制案例后再修改:
from ai_landscape import CASES, analyze_system

changed_case = CASES[3].copy()
changed_case["generates_language"] = False
print(analyze_system(changed_case))
返回值中的关键部分是:
'category': '深度学习识别'
'reason': '从样本训练神经网络,输出识别或分类结果'
程序只能根据你提供的事实判断。现在它仍然“从样本学习”并“使用神经网络”,但在本案例中不再生成语言,于是落入本课定义的“深度学习识别”。这也暴露了这个教学分类器的边界:现实中的 LLM 还可以做分类和字段抽取,不能仅凭某一次请求有没有生成长文本来识别底层模型。
代码动作 2:矛盾事实必须失败,不能猜
完整代码如下:
from ai_landscape import analyze_system

contradictory_case = {
    "name": "矛盾的语言生成系统",
    "learns_from_examples": True,
    "uses_neural_network": False,
    "generates_language": True,
    "unique_failure": "未知",
}

analyze_system(contradictory_case)
异常最后一行是:
ValueError: 本课讨论的语言生成模型必须使用神经网络
程序不继续分类,是因为“本课讨论的大语言模型应用”和“不使用神经网络”相互冲突。返回一个类别只会掩盖输入错误;抛出异常才能让调用者回头修正事实来源。
完整答案的关键不是背四个类别,而是看见“不稳定的来源不同”:规则坏在人工维护,传统 ML 坏在数据分布,视觉模型坏在输入质量,LLM 还会坏在上下文和生成可信度。
从一句话的歧义开始
看这句话:
小王把文件交给小李,因为他明天要出差。
“他”是谁?人会回看“小王”“小李”“交文件”“出差”之间的关系。早期序列模型处理文本的直觉也很自然:从左到右读,每读一个词就把当前理解压进一个隐藏状态。
小王 → 把 → 文件 → 交给 → 小李 → 因为 → 他 → 明天 → 出差
 h1    h2    h3      h4     h5      h6     h7     h8     h9
RNN 的核心递推可写成:
h_t = f(x_t, h_{t-1})
x_t 是当前词,h_{t-1} 是之前所有信息的压缩,h_t 是新的记忆。问题也在这里:第九步必须等第八步,第八步必须等第七步。GPU 有大量并行计算单元,但时间步之间存在依赖,无法把整句话一次算完。
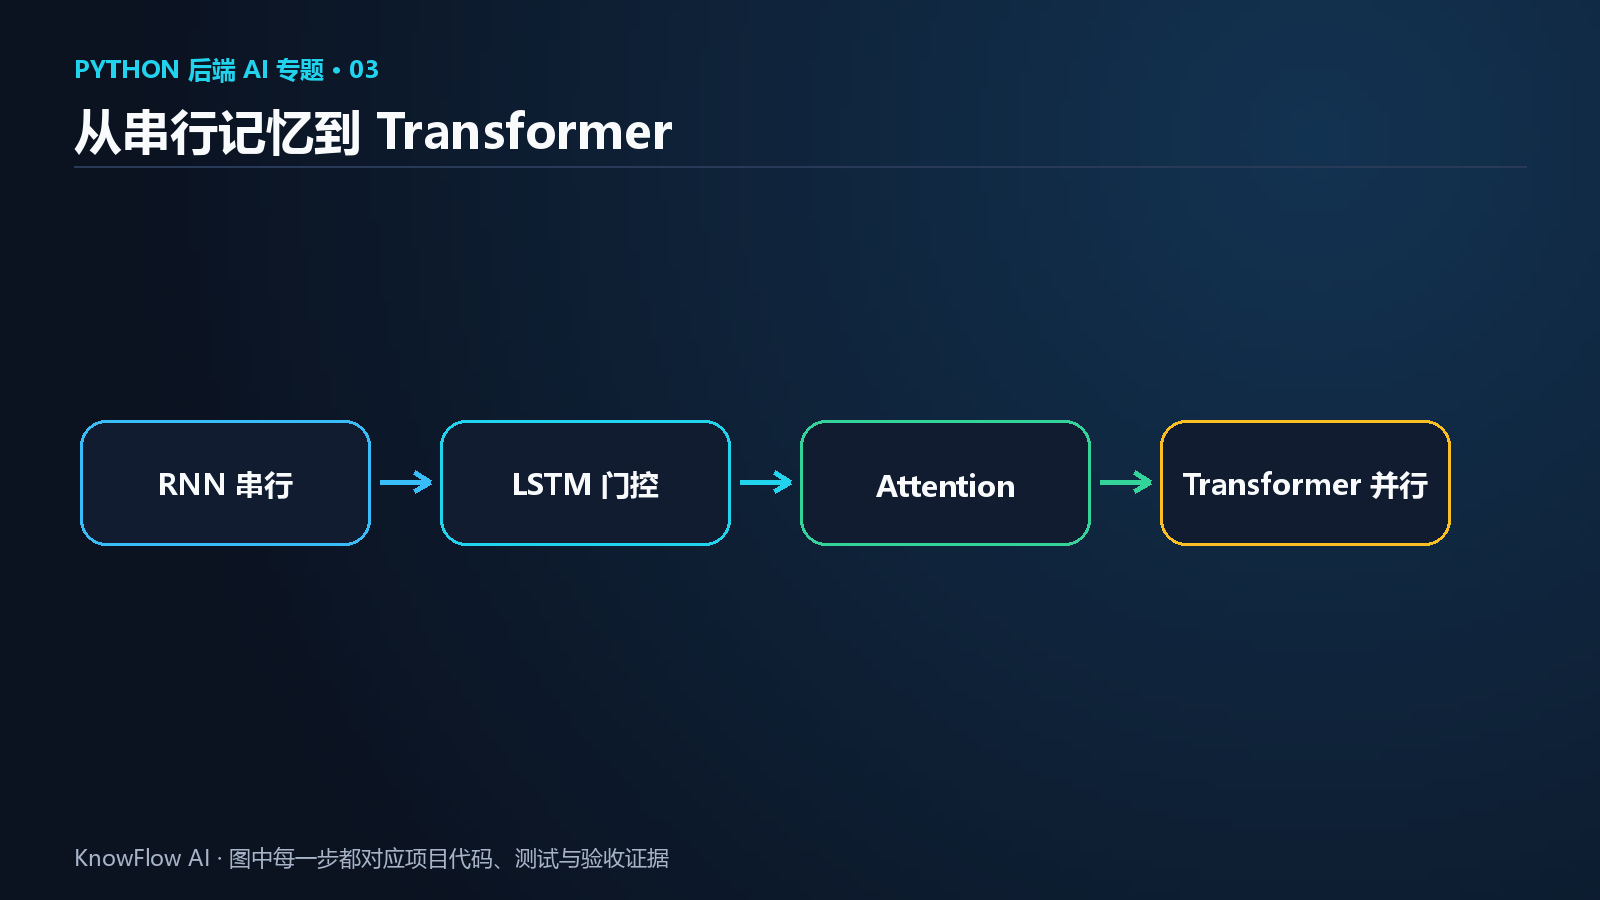
LSTM 修了“忘得太快”,没有修“必须排队”
普通 RNN 在长序列训练时容易梯度消失或爆炸。LSTM 增加遗忘门、输入门和输出门,让网络学会哪些信息保留、哪些丢弃。它确实改善了长距离记忆,却仍然需要从 t=1 串行走到 t=n。
这像一个只有一个窗口的办事大厅:工作人员的记忆能力升级了,但第 1000 个人仍然必须等前 999 个人办理完。
对于后端开发者,串行瓶颈会直接变成:
- 训练吞吐低,模型迭代成本高;
- 长上下文推理慢;
- 很远的两个词之间要经过多次状态传递,信息容易衰减;
- 很难直接解释“当前词主要参考了哪些位置”。
把问题换一个问法:为什么一定要按顺序传纸条?
如果处理“他”时,可以直接查看“小王”“小李”“出差”等所有位置,并为每个位置计算相关程度,就不必让信息沿九个时间步逐个传递。
这就是 Attention 的关键变化:当前位置发出一个查询(Query),每个位置提供一个可匹配的键(Key)和可汇总的内容(Value)。相关位置获得更高权重,最后按权重汇总 Value。
不同位置之间的匹配可以通过矩阵乘法一起计算,这非常适合 GPU。可并行不等于完全没有顺序:模型必须额外加入位置编码,否则“狗咬人”和“人咬狗”只剩同一组词。
Transformer 不是一个 Attention 函数
Transformer 把多头自注意力、前馈网络、残差连接、归一化和位置表示组合成可堆叠结构。
- 多头:不同子空间可以关注指代、语法、主题等不同关系;
- 前馈网络:对每个位置的表示做非线性变换;
- 残差连接:让深层网络保留原信息并改善训练;
- 归一化:稳定各层数值分布;
- 位置表示:补回序列顺序。
原始 Transformer 是编码器—解码器结构;BERT 主要使用编码器,GPT 类模型主要使用带因果遮罩的解码器。后端应用不需要手写训练框架,但必须知道这些差异会影响模型适合“理解/向量化”还是“逐 Token 生成”。
Transformer 解决了什么,又制造了什么
它解决了训练阶段的并行、长距离直接连接和更灵活的上下文交互;它没有免费解决一切。
标准自注意力需要比较序列中每对位置,长度为 n 时注意力矩阵有 n² 个元素。上下文翻倍,相关计算和显存并不只翻倍。这也是为什么上下文窗口很宝贵,RAG 不能把整家公司文档全部塞给模型。
另外,Transformer 的知识仍固化在权重中。训练截止之后的新制度、企业私有数据、需要精确出处的答案,仍需要后面的 RAG 链路。
本篇练习:先用纸笔推翻“平均看所有词”
处理查询“退款”时,有三个 Key:
退款政策:[1.0, 0.0]
退货地址:[0.8, 0.2]
数据库索引:[0.0, 1.0]
查询向量是 [1.0, 0.0]。先计算三个点积,不用 Softmax,回答:哪个 Key 最相关、哪个完全不相关?如果把三个 Value 简单平均,会丢掉什么?
下一篇会给出完整计算、Softmax 权重、Python 实现和测试,还会解释为什么分数要除以 sqrt(d_k)。
更多推荐



 2
 0
- 0


 已为社区贡献7条内容

所有评论(0)