
Transformer在自动驾驶的应用三 —— DETR模型结构解析
要把 DETR(DEtection TRansformer)的网络结构研究透彻,最硬核的方式就是跟着张量(Tensor)的形状变化走一遍全流程。
在深度学习中,无论算法吹得多么天花乱坠,最终都是矩阵形状的变换。
假设我们输入给 DETR 的是一张普通的图片,形状为 3×800×8003 \times 800 \times 8003×800×800 (C×H×WC \times H \times WC×H×W),Batch Size 设为 BBB。
下面将详细拆解数据在 DETR 内部是如何一步步被“揉捏”成最终的检测框的。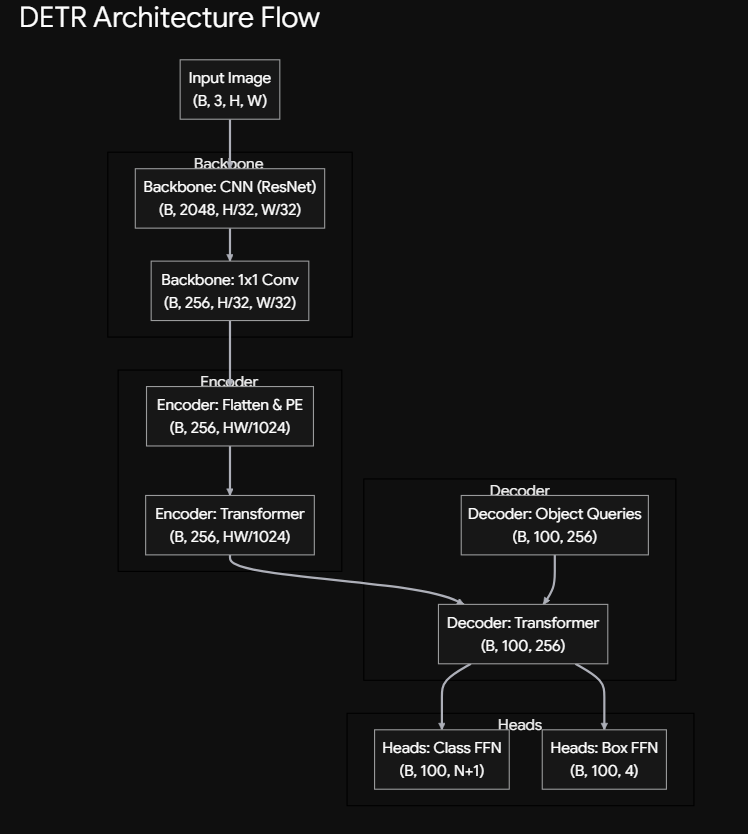
1. 骨干网络 (CNN Backbone)
提取图像特征,Transformer 看不懂原始像素,所以 DETR 第一步是雇佣一个传统的 CNN(通常是 ResNet-50 或 ResNet-101)来做“翻译”。
输入: 原始图像,形状为 (B,3,H,W)(B, 3, H, W)(B,3,H,W)。
处理: 经过 ResNet 的多层卷积和下采样。通常采用 ResNet 的最后一个阶段(Stage 4)的输出,此时特征图的长宽已经被缩小了 32 倍。
输出: 高维特征图,特征成了2048维向量,形状为 (B,2048,H32,W32)(B, 2048, \frac{H}{32}, \frac{W}{32})(B,2048,32H,32W)。
假设原图是 3×800×8003 \times 800 \times 8003×800×800,此时的输出就是 (B,2048,25,25)(B, 2048, 25, 25)(B,2048,25,25)。
2. 降维与序列化 (Neck)
为 Transformer 铺路,Transformer 的计算复杂度与序列长度呈平方关系,2048 个通道太厚了,必须瘦身。
2.1 1×11 \times 11×1 卷积降维:
使用 1×11 \times 11×1 卷积将 2048 个通道压缩到更小的值 ddd(DETR 论文中默认 d=256d = 256d=256)。形状变为:(B,256,25,25)(B, 256, 25, 25)(B,256,25,25)。
2.2 拉平 (Flatten):
Transformer 不认识 2D 矩阵,它只认识“句子”(一维序列)。所以把 25×2525 \times 2525×25 的空间维度拉平,变成长度为 625 的序列。形状变为:(B,256,625)(B, 256, 625)(B,256,625)。
然后在 PyTorch 中通常将特征维度放到最后,即 (B,625,256)(B, 625, 256)(B,625,256)。
这就相当于把一张图片切成了 625 个小块(625是图像长宽2525的结果),每个小块用一个 256 维的向量来表示,这 625 个向量就构成了送入 Transformer 的“词序列”。*
3. 2D 位置编码 (Spatial Positional Encoding)
拉平之后,原图上下左右的物理结构被彻底破坏了。
为了让模型知道第 1 个小块和第 26 个小块在原图上其实是上下紧挨着的(辅助理解图像是25*25,按照行来划分,第一行的第1个和第二行的第1个(拉平之后就是第26个)其实是上下紧邻的),DETR 引入了固定的 2D 正弦位置编码。
它分别对 XXX 轴和 YYY 轴生成位置向量,然后拼接起来,形成与特征等宽的 (B,625,256)(B, 625, 256)(B,625,256) 向量。
核心细节: 这个位置编码在 Encoder 的每一层自注意力计算之前,都会被加到 QQQ 和 KKK 上,确保模型时刻保持空间方向感。
4. 编码器 (Transformer Encoder)
DETR 默认堆叠 6 层标准的 Transformer Encoder。
输入: 图像序列特征 (B,625,256)(B, 625, 256)(B,625,256)。
内部处理: 625 个图像块通过多头自注意力(Multi-Head Self-Attention)互相交换信息。比如“车轮”的特征块会主动去吸取周围“车身”的特征块,形成全局上下文。
输出: 形状保持不变,依然是 (B,625,256)(B, 625, 256)(B,625,256)。但此时的特征已经不再是局部的像素特征,而是融合了全局语义的高级特征。
5. 解码器 (Transformer Decoder)
奇迹发生的地方这是 DETR 脱胎换骨的模块。它不再处理图像,而是处理一组被称作 Object Queries(物体查询) 的学习参数。
Object Queries
这是一个形状为 (B,100,256)(B, 100, 256)(B,100,256) 的随机初始化张量(假设预设 100 个框)。这 100 个向量在训练过程中会被不断优化,它们可以被看作是 100 个“插槽”或 100 个“带有不同偏好的探测器”。
5.1 解码过程(堆叠 6 层)
自注意力 (Self-Attention)
100 个 Query 先互相通信。作用是排他性,比如 Query A 说“我抓住左下角那辆车了”,Query B 听到后就会刻意避开左下角,防止输出重复的框(这就是 NMS 被干掉的原因)。
交叉注意力 (Cross-Attention)
100 个 Query 作为 QQQ,去向 Encoder 输出的 625 个图像特征 (K,V)(K, V)(K,V) 提问。它们像吸盘一样,把各自感兴趣的物体特征从全图中提取出来。
输出
提取完特征的 100 个 Query,形状依然是 (B,100,256)(B, 100, 256)(B,100,256)。
6. 预测头 (Prediction Heads)
解码器吐出的这 100 个包含了目标信息的 256 维向量,会被送入两个并行的前馈神经网络(FFN)进行最终的翻译:网络分支结构输出形状含义
| 网络分支 | 结构 | 输出形状 | 含义 |
| 分类头 (Class Head) | 简单的全连接层 (Linear) | “(B,100,C+1)” | C 是类别数,+1 代表“背景(无物体)”的概率 |
| 回归头 (BBox Head) | 3层 MLP + ReLU + Sigmoid | “(B,100,4)” | 输出归一化后的中心点坐标及宽高 (cx,cy,w,h) |
至此,网络前向传播彻底结束。模型一次性、确定性地给出了 100 个检测结果,没有任何 NMS 后处理。
更多推荐



 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)