


- @zhousiyuan0515


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在求解最优化问题时,面对许多问题,使用动态规划就显得有些杀鸡用牛刀,所以我们可以使用更简单更高效的贪心算法来求解一些最优解问题。贪心算法在每一步都做出当时看起来是最佳的选择,通过这样的选择希望找到全局的最优解,但是难点是在于如何证明贪心算法取得的是最优解而远不是贪心算法本身。活动选择问题...
基于组学和自然语言的大语言模型,框架包含两个部分,左边是上下文特异性特征的提取,右边是上下文无关的特征的提取,左边把基因和细胞系的信息放到提示词的模板里面再交给biomedBERT大语言模型生成表征,组学数据也通过细胞系语言模型生成表征,右边通过知识图谱基因PT自然语言的大语言模型,生成基因的表征上下文无关的;4 深度学习计算方法的深度学习方法:基于图神经网络的方法(GNNs),问题建模:SL预测
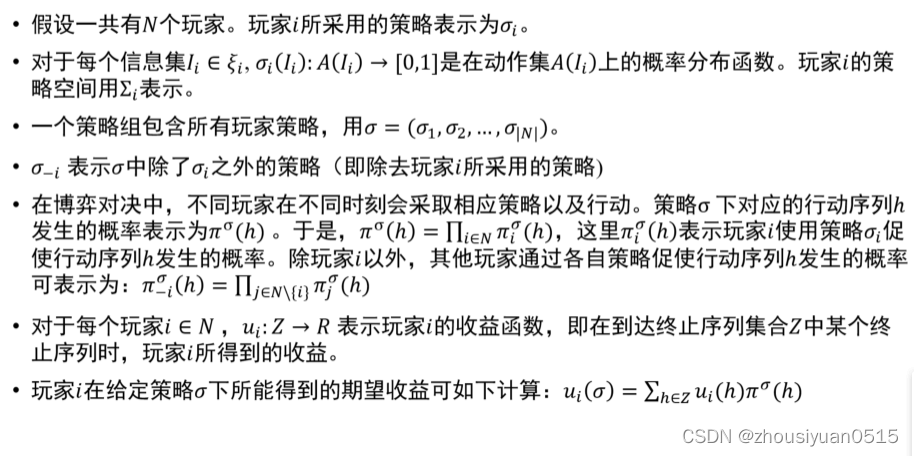
博弈行为:带有互相竞争性质的主体,为了达到各自目标和利益,采取的带有对抗性质的行为。参与者:参与博弈的决策主体。策略:参与者可以采取的行动方案,是一整套在爱去行动之前就已经准备好的完整方案。收益:各个参与者在不同局势下得到的利益(混合策略下的收益为期望收益)规则:对参与者行动的先后排序、参与者获得信息多少等内容的规定。
强化学习:在于环境交互之中进行学习,在智能主体与环境的交互中,学习能最大化受益的行动模式。轨迹长度可以是无限的,也可以有终止状态。有终止状态的问题叫做分段的,否则叫做持续的;分段问题中,一个从初始状态到终止状态的完整轨迹称为一个片段。在机器人移动问题中:状态、行为、衰退系数、起始/终止状态、反馈、状态转移概率矩阵。策略学习:一个好的策略是在当前状态下采取一个行动,该行动能够在未来收到最大化的反馈。
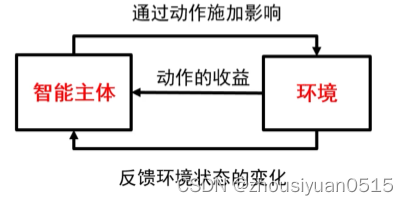
强化学习:在于环境交互之中进行学习,在智能主体与环境的交互中,学习能最大化受益的行动模式。轨迹长度可以是无限的,也可以有终止状态。有终止状态的问题叫做分段的,否则叫做持续的;分段问题中,一个从初始状态到终止状态的完整轨迹称为一个片段。在机器人移动问题中:状态、行为、衰退系数、起始/终止状态、反馈、状态转移概率矩阵。策略学习:一个好的策略是在当前状态下采取一个行动,该行动能够在未来收到最大化的反馈。
基本的图算法主要是两个方面:图的表示和图的搜索。我们主要通过邻接链表和邻接矩阵对图进行表示,但是在图算法更重要的是图的搜索,图的搜索指的是系统化的跟随图中的边来访问图中的每个节点,我们可以通过图的搜索算法发现图的结构。或者换个方面想图的算法就是通过图的搜索得到图的结构,所以图的算法就是对基本的搜索加以优化,因此图的搜索技巧是整个图算法的核心。图的表示对于一个图,我们有两种标准表示方法表示。一种表示
博弈行为:带有互相竞争性质的主体,为了达到各自目标和利益,采取的带有对抗性质的行为。参与者:参与博弈的决策主体。策略:参与者可以采取的行动方案,是一整套在爱去行动之前就已经准备好的完整方案。收益:各个参与者在不同局势下得到的利益(混合策略下的收益为期望收益)规则:对参与者行动的先后排序、参与者获得信息多少等内容的规定。
机器学习:从数据中学习知识;
博弈行为:带有互相竞争性质的主体,为了达到各自目标和利益,采取的带有对抗性质的行为。参与者:参与博弈的决策主体。策略:参与者可以采取的行动方案,是一整套在爱去行动之前就已经准备好的完整方案。收益:各个参与者在不同局势下得到的利益(混合策略下的收益为期望收益)规则:对参与者行动的先后排序、参与者获得信息多少等内容的规定。
