


- @zhousenshan


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
版权声明:本文为博主原创文章,遵循 CC 4.0 by-sa 版权协议,转载请附上原文出处链接和本声明。本文链接:https://blog.csdn.net/zsj777/article/details/808077421、配置方法2、第三方框架整合3、相关API文档4、工具类import java.util.Map;import org.redisson.api....
Redis集群模式:redis集群 应该注意的问题:https://blog.csdn.net/zhang89xiao/article/details/51273970Redis连接池---jedis-2.9.0+commons-pool2-2.4.2:https://blog.csdn.net/wangshuang1631/article/details/54091673jedis连...
**异常检测算法**(如孤立森林、One-Class SVM)- **路径规划算法**(如A*算法、Dijkstra算法)- **聚类算法**(如K-Means、DBSCAN)- **分类算法**(如随机森林、XGBoost)- **回归算法**(如线性回归、随机森林回归)- **回归算法**(如线性回归、随机森林回归)- **强化学习**(如Q-Learning)- **分类算法**(如逻辑回归
可靠消息最终一致性方案是指当事务发起方执行完成本地事务后并发出一条消息,事务参与方(消息消费者)一定能够接收消息并处理事务成功,此方案强调的是只要消息发给事务参与方最终事务要达到一致。此方案是利用消息中间件完成,如下图:事务发起方(消息生产方)将消息发给消息中间件,事务参与方从消息中间件接收消息,事务参与方(消息消费方)和消息中间件之间都是通过网络通信,由于网络通信的不确定性会导致分布式事务问题。

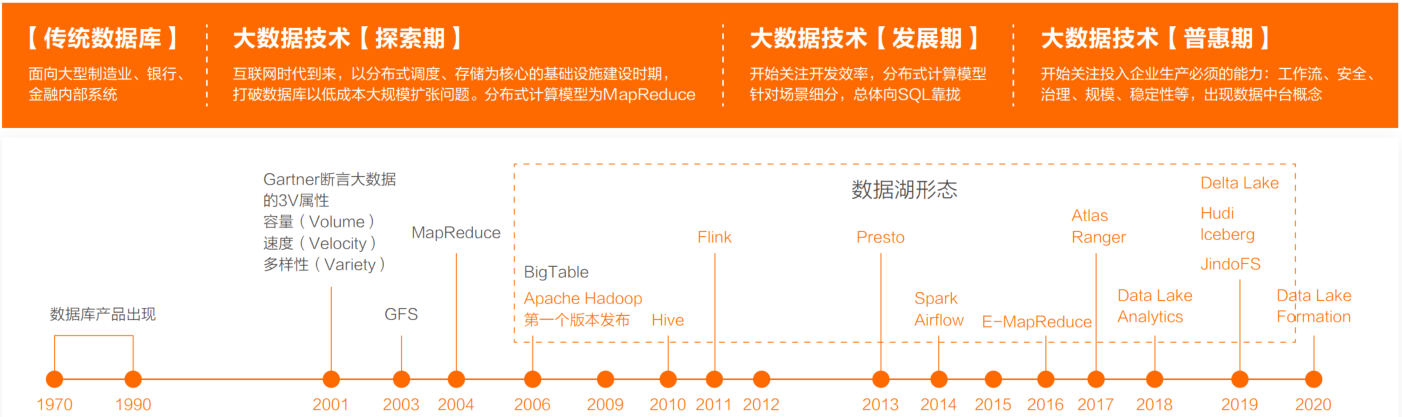
Kappa架构是严重依赖于消息队列的,我们知道消息队列本身的准确性严格依赖它上游数据的顺序,但是,消息队列的数据分层越多,发生乱序的可能性越大。然而,随着越来越多的应用上线,大家发现,其实批处理和流计算配合使用,才能满足大部分应用需求,对实时性要求高的场景,就会使用Flink+Kafka的方式构建实时流处理平台,来满足用户的实时需求。那么有没有这样一个架构,既能够满足实时性的需求,又能够满足离线计
然后排查发现,获取数据是全部获取了,那肯定会内存溢出了。1.4 但是又开始迷惑了,因为在我们的导出系统中,如果是大数据导出的话,会设置fetchSize设置游标查询获取数据,此时是不会获取全部数据在内存中的,如果全部数据都在内存了,那唯一的可能就是游标查询没生效。3、整体来说就是,由于刚才设置了preferQueryMode =simple,就会导致进入了下面的判断,而看QueryExecutor
1. 什么是 okhttp ?okhttp 是由 square 公司开源的一个 http 客户端。在 Java 平台上,Java 标准库提供了 HttpURLConnection 类来支持 HTTP 通讯。不过 HttpURLConnection 本身的 API 不够友好,所提供的功能也有限。大部分 Java 程序都选择使用 Apache 的开源项目 HttpClient 作为 HTTP 客户端。
elasticsearch三个重要的优化 1、内存优化在bin/elasticsearch.in.sh中进行配置修改配置项为尽量大的内存:ES_MIN_MEM=8gES_MAX_MEM=8g两者最好改成一样的,否则容易引发长时间GC(stop-the-world)elasticsearch默认使用的GC是CMS GC如果你的内存大小超过6G,CMS是不给力的,容易出现sto...
创建数据库连接引擎# 格式:数据库类型+驱动://用户名:密码@主机:端口/数据库名。推荐使用SQLAlchemy方式,因为它提供了更好的兼容性和更多的功能选项。# 对于SQLite(Python内置,无需安装额外包):不要在代码中硬编码数据库密码,使用环境变量或配置文件。# 读取SQL查询结果到DataFrame。这是最通用和推荐的方法,支持多种数据库。:对于大数据集,考虑使用分块读取。# 从环
场景:1.在日常生活中,我们肯定收到过不少不少这样的短信,“京东最新优惠卷…”,“天猫送您…”。这种类型的短信是属于推广性质的短信。这种短信一般群发量会到千万级别。然而,要完成这些短信发送,我们是需要调用服务商的接口来完成的。倘若一次发送的量在200万条,而我们的服务商接口每秒能处理的短信发送量有限,只能达到200条每秒。那么这个时候就会产生问题了,我们如何能控制好程序发送短信时的速度昵?于...