- @xzp740813


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在大模型火之前,机器视觉,是近5年来讲AI、用AI最多,最频繁的行业。业内一些公司,也靠AI赚到了真金白银。2023年,GPT横空出世,举世沸腾,海量资金疯狂入场大模型赛道。但和AI纠缠了5年多的机器视觉行业,对大模型,似乎没那么热情。行业很分散,应用很垂直,难通用。中小玩家众多,大模型对中小企业而言,就是奢侈品:一年的利润不够买一台H100(小几百万)。短期看,大模型对行业的影响有限;但长期看(

我想用一句话总结:AI Agent 的未来,不属于最会展示智能的系统,而属于最能可靠交付结果的系统。如果你也在开发 Agent,或者已经尝试将它应用到真实业务中,欢迎在评论区交流:你遇到的最大障碍究竟是模型能力、任务可靠性,还是投入产出比?
本文介绍了AI Agent的重要性,它不仅具备普通LLM的对话能力,更拥有工具使用、任务规划和长期记忆等核心优势。文章提供了AI Agent的学习路线图,分为认知与基础、单体Agent开发、多智能体系统和前沿与落地四个阶段,并推荐了相关的学习资料和避坑指南。通过学习AI Agent,程序员可以实现从“码农”到“架构师”甚至“产品经理”的进阶。如果说 2023 年是“大模型(LLM)元年”,大家都在

本文深入浅出地解释了大模型处理请求的两大核心阶段:预填(一次性读入并理解输入)和解码(逐字生成输出)。通过餐厅备菜与上菜的比喻,阐述了为何将两者分离(PD分离)能显著提升效率,特别是在处理超长输入时。文章详细介绍了分离后如何通过KV Cache的传输(拉取或推送)在不同节点间衔接,并以昇腾平台为例展示了具体实现。对于希望了解大模型内部运作及优化技巧的读者,本文提供了清晰的图解和关键术语解释。开篇:
2022 年的论文《ReAct: Synergizing Reasoning and Acting in Language Models》;然后早期、又出圈的 Agent 的话是 2023 年 3 月的开源项目 Auto-GPT;但国内的话,还是 Manus 的发布给我们打开了 AI 应用新的视野。于是我们团队开始马不停蹄的研究如何实现一个 Manus,经过我们研究和讨论发现,Manus 实现起来
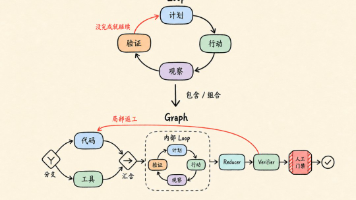
很多多 Agent 流程前面跑得很热闹,最后却把几十份原始结果一次性塞给最强、也最贵的模型。它先要去重、过滤空结果、统一格式、处理冲突,然后才开始推理。最有能力的模型反而成了垃圾整理员。多个 Worker↓代码去重、过滤、排序↓验证冲突和薄弱证据↓强模型综合能由代码稳定处理的工作,不必再消耗一次模型调用。【先压缩,再推理】
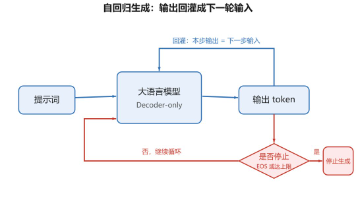
本文深入浅出地解析了大模型(如ChatGPT)的生成机制,核心在于“根据前面的内容预测下一个token”。详细介绍了token的概念、模型推理的预填充和解码过程、主流的Decoder-only架构及其工作原理,以及模型如何通过海量数据预训练和微调来学习语言模式。文章最后还探讨了成为大模型工程师所需具备的工程能力和模型原理理解能力,强调懂应用与懂原理并重的重要性。你肯定跟 ChatGPT、DeepS
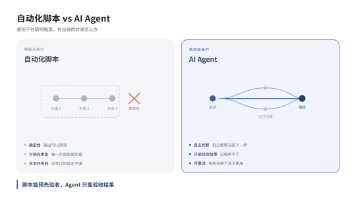
本文探讨了AI大模型从“回答”型向“执行”型转变的趋势,重点分析了OpenAI的GPT-6 Astra、DeepSeek的V4.1-Flash价格降低以及AI公司的大额融资事件。文章阐述了AI Agent与传统自动化脚本的差异,并提出了AI在企业中应用的几种形态。最后,作者以非技术岗的视角,给出了AI应用的第一步实施建议,强调了权限和审计的重要性。9 月第一周,三条新闻撞在了一起:模型开始交付成品
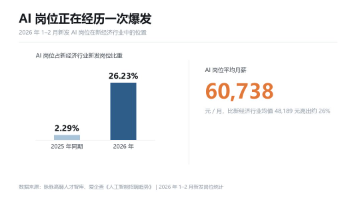
文章分析了AI领域的人才缺口与招聘现状,指出缺的不是想转行的人,而是能直接上手的人。文章详细介绍了AI的五个主要方向(基础设施、大模型与多模态、具身智能、Agent工程化、应用层),并阐述了每个方向的需求、薪资、门槛及风险。同时,文章提出了进入AI领域需要掌握的三道门槛(工程底座、AI原生思维、领域纵深),并提供了一张实用的工具通关地图,帮助读者快速定位自己的优势方向,通过实践项目来弥补经验不足,
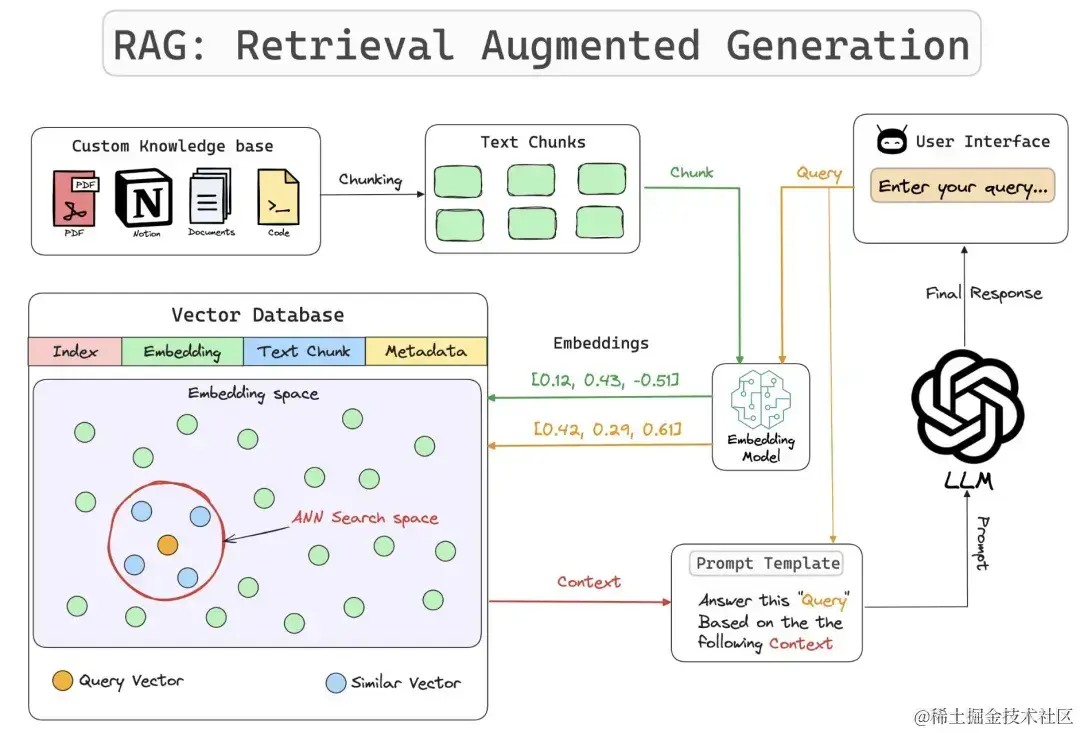
前排提示,文末有大模型AGI-CSDN独家资料包哦!RAG,即检索增强生成(Retrieval-Augmented Generation),是一种先进的自然语言处理技术架构,它旨在克服传统大型语言模型(LLMs)在处理开放域问题时的信息容量限制和时效性不足。RAG的核心机制融合了信息检索系统的精确性和语言模型的强大生成能力,为基于自然语言的任务提供了更为灵活和精准的解决方案。