


- @www_pp_


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
检索增强生成(Retrieval-Augmented Generation, RAG)是一种为大模型提供外部知识源的技术,使它们能够生成准确且符合上下文的答案,同时能够减少模型幻觉。RAG 将生成模型与检索器模块相结合,提供来自外部知识源的附加信息,这些信息可以方便地进行更新和维护。RAG 对于 LLM 来说就像学生的开卷考试一样,测试的重点是模型的推理能力,而不是它记忆特定信息的能力。容器:轻量
本文详细介绍了如何利用YOLOv5进行分布式训练和混合精度训练,以加速深度学习模型的训练过程。YOLOv5作为一种高效的单阶段目标检测算法,通过分布式训练(使用PyTorch的DistributedDataParallel)和混合精度训练(使用NVIDIA Apex的amp模块),能够显著提升训练速度和模型性能。文章涵盖了环境配置、代码实现、数据加载与预处理、损失函数与优化器、学习率调度器以及训练
通过本项目的实现,我们成功搭建了一个基于OpenCV与深度学习模型的实时人脸性别与年龄识别系统。在项目过程中,我们详细介绍了人脸检测、性别与年龄识别以及结果展示等关键模块的实现原理与代码实现,并探讨了项目优化与改进的方向。希望本文能够为对计算机视觉与深度学习感兴趣的读者提供一定的参考与启发,大家可以在实际项目中根据具体需求对代码进行修改与拓展,探索更多有趣的应用场景。未来,随着技术的不断发展,相信
人脸关键点检测是指在人脸图像中定位特定的特征点,例如眼睛、鼻子、嘴巴的轮廓等。这些关键点可以用于进一步的分析,如面部表情识别或面部对齐。Dlib 是一个开源的 C++ 库,它提供了强大的机器学习工具,包括人脸检测和关键点检测功能。OpenCV 是另一个广泛使用的计算机视觉库,它提供了丰富的图像处理功能。通过结合 Dlib 和 OpenCV,我们可以轻松实现人脸关键点检测。通过结合 Dlib 和 O

本文介绍了如何使用 Python 和 PaddleOCR 实现从摄像头实时捕获视频流并进行英文文字识别,最终将结果显示在 PyQt5 界面中。技术栈包括 PaddleOCR(用于文字识别)、OpenCV(用于视频流处理)和 PyQt5(用于创建图形用户界面)。实现步骤包括创建 PyQt5 界面、初始化 PaddleOCR、捕获摄像头视频流、进行 OCR 识别并将结果实时显示在界面中。通过该方案,用

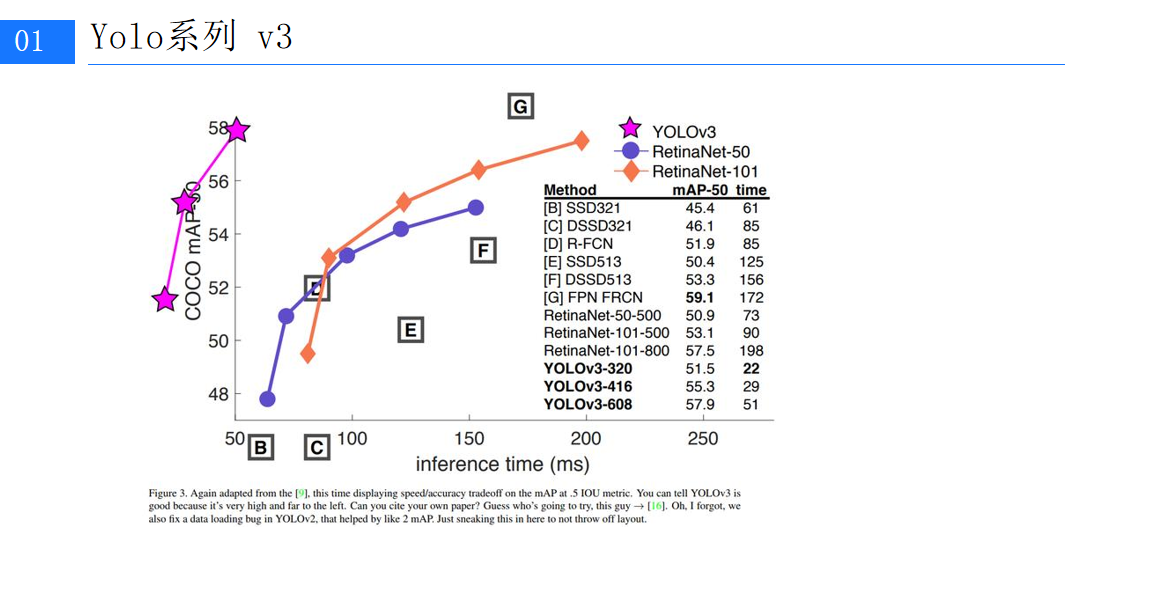
在计算机视觉领域,目标检测是一项核心任务,它涉及到识别图像或视频中的物体,并确定它们的位置。随着深度学习技术的快速发展,目标检测算法也在不断进步。YOLO(You Only Look Once)系列算法以其速度快、易于实现而受到广泛关注。本文将深入探讨YOLOv3,这是YOLO系列中的一个重要版本,它在准确性和速度之间取得了很好的平衡。
在数据分析和机器学习领域,模型的构建和预测是核心任务之一。然而,将这些模型转化为用户友好的应用程序,可以极大地提高模型的实用性和可访问性。本文将介绍如何使用Python的PyQt5库构建一个简单的图形用户界面(GUI)应用程序,该程序可以加载一个预训练的模型,并允许用户输入数据以获取预测结果。

本文介绍了一个基于 OpenCV 的运动目标检测系统。通过背景减除、形态学操作和轮廓检测等步骤,我们能够从视频中实时检测出运动目标,并将其标记出来。该系统可以应用于简单的监控场景,例如检测进入某个区域的行人或车辆。然而,该系统仍有一些可以改进的地方。例如,目前的背景减除器对光照变化较为敏感,可能会导致误检测。此外,系统只能检测到运动目标的位置,而无法跟踪目标的运动轨迹。未来,我们可以探索更多先进的

通过这篇文章,我们展示了如何使用 Flask 部署一个深度学习模型,并通过客户端与服务端进行通信。我们详细解释了服务端和客户端的代码,并提供了运行和测试的步骤。希望这能帮助你理解如何将深度学习模型部署为 Web 服务,并处理可能遇到的网络问题。

OpenCV(Open Source Computer Vision Library)是一个开源的计算机视觉和机器学习软件库,它提供了大量的图像和视频处理功能。其中,人脸识别是 OpenCV 的一个重要应用领域。通过 OpenCV,我们可以轻松地实现人脸检测、识别等功能,而无需深入了解复杂的底层算法原理。通过上述代码示例,我们详细介绍了如何使用 OpenCV 实现人脸识别,从图像处理与数据准备,到
