


- @weixin_73593530


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
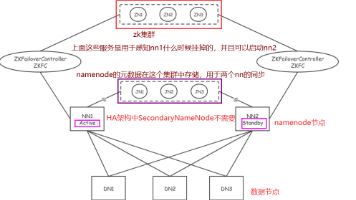
脑裂:同一时刻出现两个 Active NN,导致元数据错乱。解决:ZK 分布式锁,只有一个能抢到主fencing 机制(sshfence /shellfence)强制杀掉旧主NN HARM HA。
本文以 Flink 1.12 版本为核心,以 WordCount 案例手把手讲解了flink源码正确下载、编译、模块结构与调试方法。清晰区分了手写 WordCount、官方流式 WordCount、批处理 DataSet 三者的本质区别,解决了新手找错源码、看不懂架构的问题。
全局最大时间直接拉高到 11:15:11,触发水印更新推送,水位同步涨到 11:15:11;水位 11:15:11 > 匹配片段结束时间 11:14:11,阻塞的匹配结果瞬间释放,控制台打印输出。此时水印还没推送到 11:14:11,水位没超过匹配结束时间 11:14:11,结果阻塞。一条消息的事件时间 < 当前全局水印时间 −5 秒 → 这条消息直接被丢弃,连 CEP 算子都进不去。全局最大时间
最近在做反欺诈项目实时数据流搭建,需求是通过 Flink MySQL-CDC 抓取交易表增删改数据,同步投递到 Kafka 供下游风控引擎消费。本以为复制模板就能一键跑通,结果接连踩了三处典型大坑:initial全量模式跑完存量不切实时、print()直接阻塞流式任务数据投递 Kafka 格式不对无法识别。把排查过程、根源、最终修复方案完整记录下来,给同样做 CDC 同步的同学避坑。
布隆过滤器是空间利用率极高的概率型二进制数据结构,底层本质是一个超长 bit 位数组,数组内元素只有01两种值。方案一 HashSet:窗口等待所有数据齐了再遍历迭代器统计,超大流量下迭代器积攒海量对象,堆内存暴涨极易 OOM;方案二 Redis 布隆过滤器:依然依赖窗口攒齐全部数据再统一遍历计算,迭代器数据积压问题没有解决;同时逐条落地 MySQL 频繁创建关闭连接,IO 压力大、写入性能极差。
在 Flink 流式开发中,大多数开发者日常使用mapfilterflatMapkeyBy+ 聚合等高阶 API,这些 API 简洁易用,但能力存在局限性:无法精细管控流处理的时间机制、无法灵活使用状态、不支持自定义定时触发逻辑。而是 Flink专属的底层核心 API,堪称 Flink 按键流处理的「万能工具箱」。它打破了高阶 API 的能力壁垒,同时整合了状态编程、定时器机制、上下文精准操控三大
TTL 全称 Time To Live,即状态存活有效期,是 Flink 专为键控状态(Keyed State)设计的过期淘汰机制。简单来说,就是为 Flink 任务中存储的每一个 key 状态,设置一个固定的存活时间。当某个 key 的状态数据,超过设定的 TTL 时间未被更新、未被访问时,该条状态数据会被 Flink 自动标记为过期,并在后续的状态清理流程中被清除,释放对应的内存、磁盘资源。T
在 Spark 大数据计算体系中,Shuffle 是整个作业的性能命脉,也是 90% 数据倾斜、任务卡顿、磁盘 IO 爆满、作业超时失败的核心元凶。不管是日常生产调优、大厂面试深挖,还是底层原理进阶,Spark Shuffle 都是绕不开的核心重难点。很多人只会死记硬背「Hash Shuffle、Sort Shuffle」的区别,却根本不懂 Shuffle 完整流转链路、演进逻辑、性能瓶颈根源,导
在大数据实时计算领域,数据积压是所有开发、运维工程师绕不开的核心痛点。日常生产中,我们经常遇到这些经典问题:Kafka 消息分区堆积持续上涨、Flink Task 背压告警、消费延迟分钟级甚至小时级递增、实时报表数据滞后、数据流雪崩导致任务重启失败。多数团队解决积压只停留在「治标不治本」的层面:盲目调高并行度、增大批次大小、重启任务临时救急。但这种方式只能短暂缓解问题,流量峰值到来后,积压会再次爆
1. 高精度 Numeric/Decimal 一律字符串透传,禁止 Flink 自动数值转换,杜绝精度丢失;2. 时间类型严格区分 TIMESTAMP/TIMESTAMP_LTZ,统一上海时区,保留微秒级精度;3. PG 所有复杂类型(JSONB、数组、枚举、二进制)全部采用字符串模式传输;4. 强制快照与增量共用 Debezium 解析逻辑,从根源消除格式差异;5. 表结构 DDL 变更后,务必