

写文章


- @weixin_65350212


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
bert文本分类任务单卡训练VS使用deepspeed框架进行多卡训练(自用、未完结)
在上面三个文件的基础上,再加上一个多机器的配置文件(假设文件名为abc),文件内写上机器的ip地址,以及可用的显卡数量。2.2 需要准备的三部分文件:1.项目文件(例如:main.py)2.deepspeed的配置文件(deepspeed.json)3.运行deepspeed的脚本文件。其次,还要修改脚本文件(run.sh)中的内容,让它识别到多机器的配置文件。2.3.1 使用deepspeed前

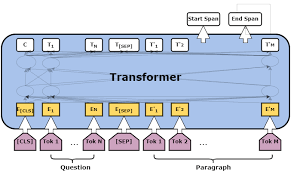
基于Transformers的机器阅读理解(Machine Reading Comprehension)
详细解释什么是机器阅读理解,基于transformers的解决方案,以及机器阅读理解的代码实战。
预训练模型的加载,保存模型,模型的修改(迁移学习)
深度学习基础之预训练模型的加载,保存模型,模型的修改
元学习笔记(自用,更新)
元学习分为训练阶段和测试阶段。假设我们在训练阶段有10个类别的点C1-C10,每个类别有30个标注的结点。如果支持集设置5 way 5 shot,查询集设置为5 way 15 shot。那么从10个类别中随机挑选出5类,每类挑选20个结点,组成一个task。其中每类的5个结点组成support set,剩下的15个结点组成query set。MAML的输入是一个个的task,并不是一条条的数据,这
查看模型、查看模型参数的方法(主要针对迁移学习)
深度学习基础之查看模型结构和模型参数
load_dataset()的使用
load_dataset()的快速入门
到底了