- @weixin_55939638


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本篇博客将详细介绍如何在centos上安装并配置nginx,步骤详细,希望能帮助到刚接触nginx的伙伴。
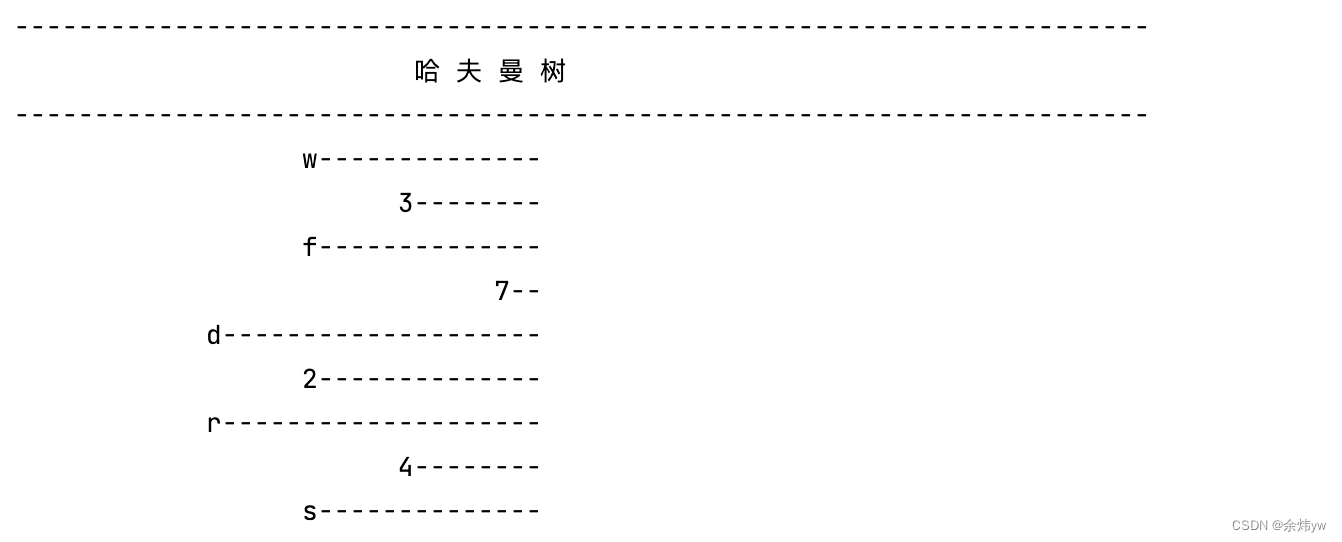
本文介绍了哈夫曼树的创建和如何编码,希望本文能帮助到正在学习哈夫曼树的读者。
摘要: Transformer架构通过自注意力机制(Self-Attention)革新了深度学习模型设计,解决了传统RNN/CNN的长距离依赖问题。其核心包括: 自注意力:通过Q(查询)、K(键)、V(值)向量直接计算词间关联,如“天气”与“不错”的高权重匹配; 多头注意力:并行多组注意力头,分别捕捉语法、语义等不同维度信息; 残差连接与层归一化:保留原始输入并稳定数据分布,支持深层模型训练。 T
通过Knife4j + OpenAPI 自动生成请求代码后端接口文档与前端请求代码的强一致性。前端开发者零手写请求函数,只需关注业务逻辑。类型安全,IDE 智能提示,减少低级错误。接口变更时,一键同步,极大提升协作效率。在 AI 辅助编程越来越普及的今天,这种自动化工具依然有着不可替代的价值——它保证了代码的确定性和可控性。当你需要快速迭代、多人协作时,这套方案能让团队如虎添翼。赶快在你的项目中试
摘要: Transformer架构通过自注意力机制(Self-Attention)革新了深度学习模型设计,解决了传统RNN/CNN的长距离依赖问题。其核心包括: 自注意力:通过Q(查询)、K(键)、V(值)向量直接计算词间关联,如“天气”与“不错”的高权重匹配; 多头注意力:并行多组注意力头,分别捕捉语法、语义等不同维度信息; 残差连接与层归一化:保留原始输入并稳定数据分布,支持深层模型训练。 T
神经网络的训练过程实际上是通过重复前向传播和反向传播这两个关键步骤来调整神经网络中的权重。在前向传播中,数据从输入层经过各个隐藏层逐层计算,最终得到输出结果;在反向传播中,计算损失值并反向传播回每一层,计算每个权重的梯度,最终更新权重。通过不断地迭代训练,神经网络能够从数据中学习模式和规律,提高预测精度。如果有任何疑问或建议,欢迎在评论区留言,我们一起讨论。

随着人工智能技术的不断进步,特别是大模型在自然语言处理领域的广泛应用,使得越来越多的人开始积极学习自然语言处理(NLP)。本文将为你揭示大模型在NLP领域的核心代码,这些代码是NLP应用的基石,没有涉及过多的复杂理论知识。我们将通过具体的示例和代码来解释这些大模型的工作原理和实现方式,让你轻松掌握NLP的实践技能。
通过Knife4j + OpenAPI 自动生成请求代码后端接口文档与前端请求代码的强一致性。前端开发者零手写请求函数,只需关注业务逻辑。类型安全,IDE 智能提示,减少低级错误。接口变更时,一键同步,极大提升协作效率。在 AI 辅助编程越来越普及的今天,这种自动化工具依然有着不可替代的价值——它保证了代码的确定性和可控性。当你需要快速迭代、多人协作时,这套方案能让团队如虎添翼。赶快在你的项目中试
前端:vue3后端:spring 框架
时间过的真快,转眼之间一个学期即将结束,想必这个时候大家都在准备各科的课设作业,本期内容是我的数据结构课设,希望能给大家带来帮助,如果有任何不足或需要改进的地方,欢迎各位提出宝贵的意见。屏幕录制2023-12-24 13.43.01。