


- @weixin_55252589


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
pass策略模式是一种行为型设计模式,通过定义一系列算法并将每个算法封装起来,使它们可以互相替换,从而实现算法的独立变化和复用。策略模式可以提高代码的灵活性和可维护性,适用于算法需要在运行时选择或消除条件语句的场景。合理使用策略模式,可以显著提高代码的质量和设计水平。
pass解释器模式是一种行为型设计模式,通过定义一个语言的文法表示,并建立一个解释器来解释语言中的句子。解释器模式适用于简单文法的解释、领域特定语言和可扩展的文法规则的场景。合理应用解释器模式,可以提高系统的灵活性和可维护性。理解并掌握解释器模式,有助于在实际开发中构建高效、灵活的系统,特别是在需要动态解释或运行时解释的场景中。
推导卡尔曼滤波(Kalman Filter)最直观的方法不是直接去啃复杂的矩阵公式,而是从 “如何融合两份不完美的证据” 这个直觉出发。我们可以通过递归贝叶斯估计的思想,分三步完成推导。假设你要测量一个物体的温度。你现在想要得到一个最接近真实的融合估计值 x^new\hat{x}_{new}x^new。最合理的做法是做加权平均:x^new=w1x^1+w2z2\hat{x}_{new} = w_
深度Q学习(DQN)通过结合深度神经网络和Q学习,能够在复杂和高维度的状态空间中进行有效的强化学习。关键技术包括经验回放和目标网络,这些技术显著提高了训练的稳定性和效率。尽管面临一些挑战,但DQN在许多强化学习任务中表现出色,特别是在游戏和模拟环境中。
本书之前的章节讲解了基于值函数的方法(DQN)和基于策略的方法(REINFORCE),其中基于值函数的方法只学习一个价值函数,而基于策略的方法只学习一个策略函数。那么,一个很自然的问题是,有没有什么方法既学习价值函数,又学习策略函数呢? 答案就是 Actor-Critic。Actor-Critic 是囊括一系列算法的整体架构,目前很多高效的前沿算法都属于 Actor-Critic 算法,本章接下来

投票法(Voting)是一种集成学习技术,它结合了多个不同的模型来提高整体模型的性能。这种方法基于一个简单的前提:多个模型的集体决策比单一模型的决策更可靠。投票法通常分为两种类型:硬投票(Hard Voting)和软投票(Soft Voting)。硬投票(Hard Voting)在硬投票中,每个模型对于每个样本都给出一个预测类别(即最终的输出标签)。整体模型的预测结果是基于“多数投票”的原则得出的
假设我们要画一段从x0y0(x_0, y_0)x0y0到x1y1(x_1, y_1)x1y1的直线,斜率0k10 < k < 10k1。我们可以将直线方程表示为隐式方程Fxy0Fxy0yΔyΔxxByΔxΔyxBFxy2Δy⋅x−2Δx⋅y2Δx⋅B0Fxy2Δy⋅x−2Δx⋅y2Δx⋅B0。
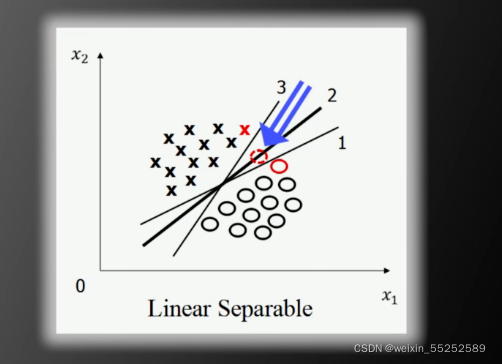
首先区分一对概念:线性可分:存在一条直线或一个平面或超平面,可以将样本集分开。非线性可分:不存在......这里我们假设中间那条直线的方程为:权重(weight):偏置(bias):值得注意的是:在直线的两侧,直线方程分别 大于零 和 小于零,这个规定可以是人为的。接着用数学严格定义训练样本以及他们的标签:假设:有个样本和他们的标签。其中规定:如果,则反之,线性可分的严格定义:一个训练样本集在线性
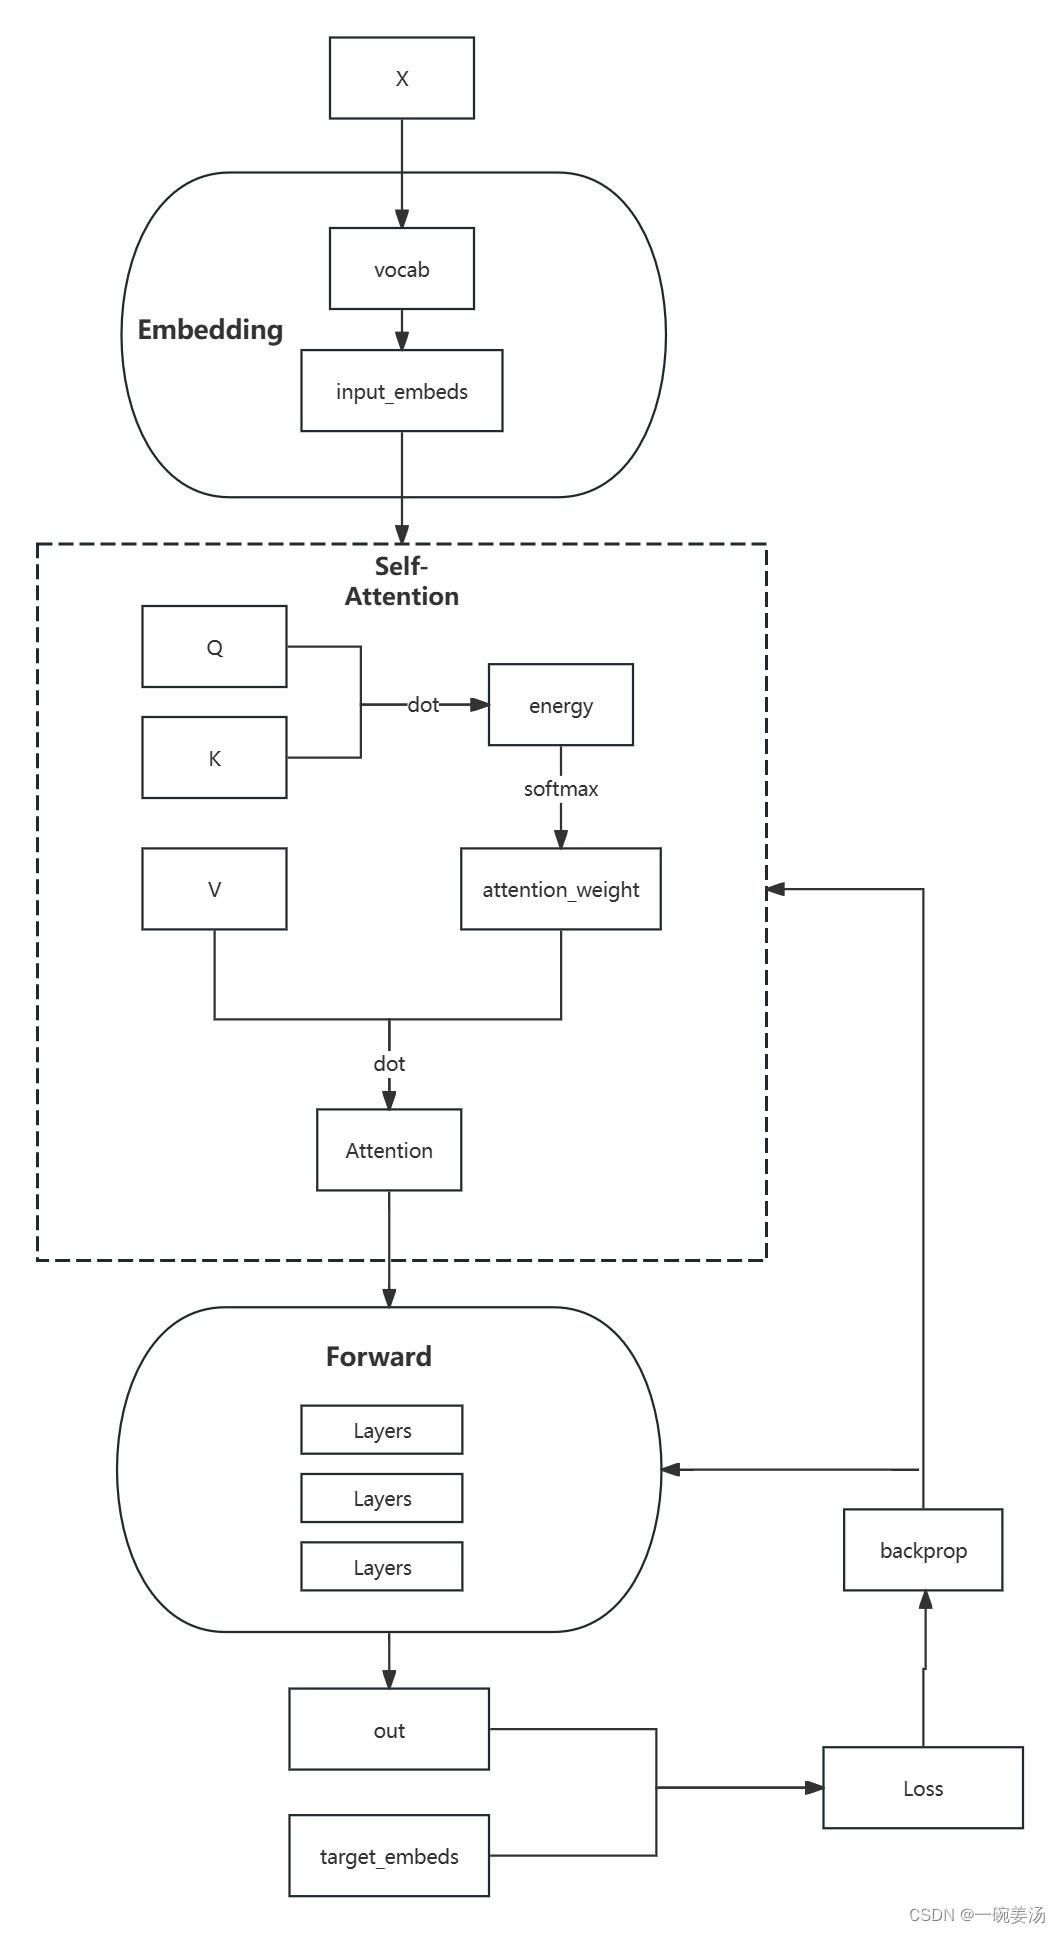
自注意力机制可以理解为学生在课堂上做笔记时,不仅关注当前的讲课内容,还结合之前的所有笔记来理解新的信息。通过查询、键和值向量的计算,模型能够灵活地整合和理解复杂的信息。
REINFORCE 算法是策略梯度乃至强化学习的典型代表,智能体根据当前策略直接和环境交互,通过采样得到的轨迹数据直接计算出策略参数的梯度,进而更新当前策略,使其向最大化策略期望回报的目标靠近。这种学习方式是典型的从交互中学习,并且其优化的目标(即策略期望回报)正是最终所使用策略的性能,这比基于价值的强化学习算法的优化目标(一般是时序差分误差的最小化)要更加直接。它的含义是,目标函数的梯度可以通过
