


- @weixin_51213906


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
如图,最后一位都为A,那么A前的子序列的最大公共子序列则为dp[i-1][j-1]这样放眼到完整子序列中,长度便是dp[i-1][j-1]+1这样便可以得到递推公式dp[i][j-1]字符串 ( S_1 ) 的前 ( i ) 个字符和字符串 ( S_2 ) 的前 ( j ) 个字符的最长公共子序列长度。
但不同的是,动态规划是自底向上分解,并且会保存子问题的解,在需要时可直接拿过来使用,这一点是区别于分治的。这类问题存在大量重叠子问题,即子问题的解可以被多次重复利用,而这些子问题的结果依赖于更小的子问题结果。子问题划分: 为了找到最优的合并顺序,我们需要考虑如何将区间 [i, j] 划分为更小的子区间 [i, k] 和 [k+1, j],并递归地计算它们的最优解。例如,如果我们有三堆石子 [4,

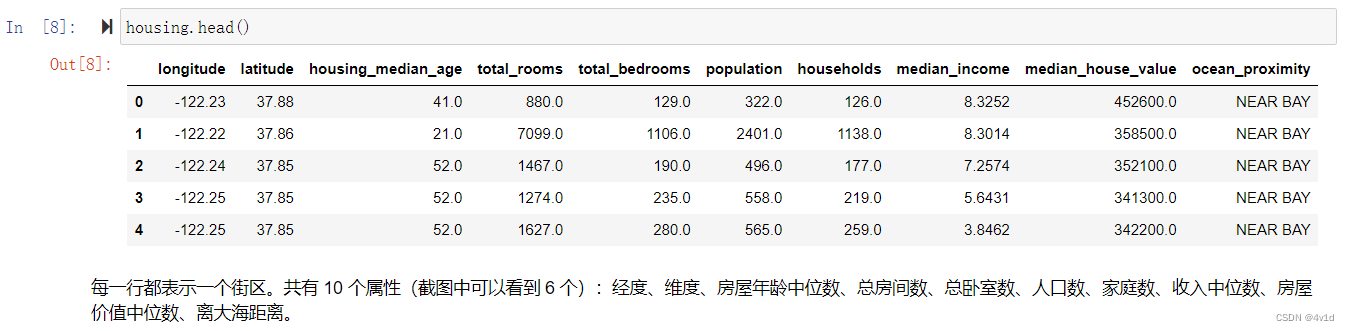
参考链接:https://hands1ml.apachecn.org/2/设计好系统后,要开始在工作区编写代码来解决问题了。
NumPy reshape()函数详解 本文深入讲解了NumPy中reshape()函数的核心概念和使用方法,特别适合编程基础薄弱的学习者。主要内容包括: shape属性的本质:表示数组元素的排布方式而非数值本身 reshape()的核心作用:改变数组维度而不改变元素总数 特殊参数-1的含义:自动计算该维度的大小 不同reshape方式的区别:如(-1,1)与(1,-1)的差异 机器学习中的典型应

尽管时间序列预测取得了重大进展,但现有的预测器常常忽视长期和短期时间序列之间的异质性,导致实际应用中的性能下降。在这项工作中,我们强调需要针对不同范围制定不同的目标。我们指出,时间序列可以分解为全局模式和局部变化,这应该在长期和短期时间序列中分别解决。为了实现这些目标,我们提出了一种多尺度混合 MambaTransformer 专家模型 (SST)。
要解决这个问题,一个常见的方法是给每个分类创建一个二元属性:当分类是<1H OCEAN,该属性为 1(否则为 0),当分类是INLAND,另一个属性等于 1(否则为 0),以此类推。现在,你就可以使用这个“训练过的”imputer来对训练集进行转换,将缺失值替换为中位数,结果是一个包含转换后特征的普通的 Numpy 数组。通过前面的工作,你应该注意到了属性total_bedrooms有一些缺失值,
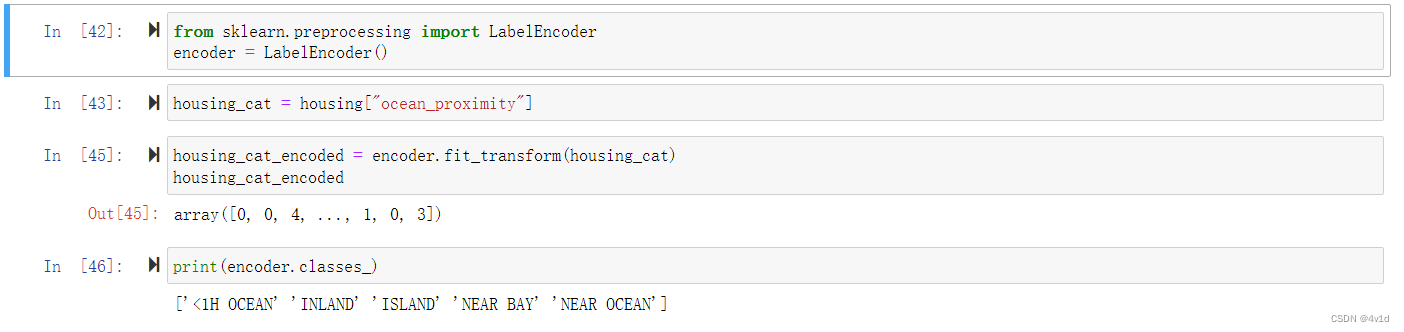
参考链接:https://hands1ml.apachecn.org/2/#_11。

本文是一份面向代码基础较弱学生的中文教学材料,介绍如何使用LSTM模型检测化工过程网络中的传感器攻击。文章详细讲解了多标签分类问题的特点(一个样本可能对应多个攻击标签),分析了输入数据的结构(640个样本,每个样本5个时间步,8个特征),并逐步指导数据加载、标签构建、模型训练和评估过程。特别强调了数据预处理、多标签分类与普通分类的区别,以及如何正确构建输出标签(4维向量表示4个传感器是否被攻击)。

谨以此篇,作为留恋

参考链接:https://hands1ml.apachecn.org/2/#_11。