- @weixin_48827824


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
人工神经网络(Artificial Neural Network, ANN)中的单个人工神经元是对生物神经元的高度抽象、提炼和简化,模拟了后者的若干基本性质。得益于误差反向传播算法,网络权重可根据设定的目标函数得到有效地调整,ANN在视觉、文本、语音等领域都取得了巨大的成功,各种新奇的网络结构、训练策略层出不穷,ANN获得了蓬勃发展,大量科研及工程人才投入之中,强力推动了学术研究及工业应用。
音之家-AI工匠学堂推出《WeNet语音识别实战》, WeNet是目前工业界最流行的开源端到端语音识别系统之一,也是学习端到端语音识别的最佳实践项目。语音识别的学习者和从业者,可以通过学习这门课程高效全面的掌握WeNet的基本原理和实战方法,降低自己摸索的成本,快速构建出高性能的语音识别系统。...
值得一提的是,在需要歌词识别能力的场景中,FireRedASR-LLM 也表现出极强的适配能力,CER 实现了 50.2%~66.7% 的相对降低,这一成果进一步拓宽了 FireRedASR 的应用范围,使其不仅能胜任传统语音识别需求,还能在创新性的多媒体场景中大放异彩。FireRedASR-AED(右下):基于经典的 Attention-based Encoder-Decoder 架构,Fire

更令人无语的是,关于这个漏洞的代码修改,其实去年就在开源社区的上有分支修复了,但由于没有被打上安全补丁的标签(未分配CVE编号),导致下游无数操作系统和软件根本不知道这件事!这就是现代互联网的脆弱性缩影:正如那幅著名的xkcd漫画所嘲讽的,所有现代数字基础设施,都摇摇欲坠地建立在某个不知名程序员维护的、满是漏洞的小型开源库之上。普通企业能凭借这种攻击成本门槛获得安全。因为要把一个理论上的内存损坏漏
然后对于任务交互,CTC分支为AR任务提供了对齐的文本,而从我们的AR模型中提取的口音嵌入整合到ASR分支的编码器和解码器中。具体地,对于一个带口音的语句,映射其相应的对齐文本向量到口音相关空间作为一种基准,然后通过评估输入的声学嵌入和该基准的点积相似度,实现对口音偏移的度量。通过比较D1和D5可以看出,如去掉从CTC分支中获得的对齐文本,将会对LASAS AR分支的准确性有重大不利影响,这一结果
论文利用低质量的众包口音数据集KeSpeech,将低质数据中的各种普通话地方口音迁移到标准普通话口音的目标说话人DB1 [2] 上,实现保留DB1音色带有各种口音的语音合成系统。

中国移动研究院首席科学家冯俊兰博士带领人工智能与智慧运营中心语音团队共同撰写的文章《Meta Auxiliary Learning for Low-resource Spoken Language Understanding》被语音国际顶会Interspeech2022接收。
本文由哈工程智能信号处理组与悉尼科技大学、萨里大学合作,发表于IEEE信号处理学会期刊IEEE Signal Processing Letters,论文一作为2020级硕士研究生肖飞扬。
然后对于任务交互,CTC分支为AR任务提供了对齐的文本,而从我们的AR模型中提取的口音嵌入整合到ASR分支的编码器和解码器中。具体地,对于一个带口音的语句,映射其相应的对齐文本向量到口音相关空间作为一种基准,然后通过评估输入的声学嵌入和该基准的点积相似度,实现对口音偏移的度量。通过比较D1和D5可以看出,如去掉从CTC分支中获得的对齐文本,将会对LASAS AR分支的准确性有重大不利影响,这一结果
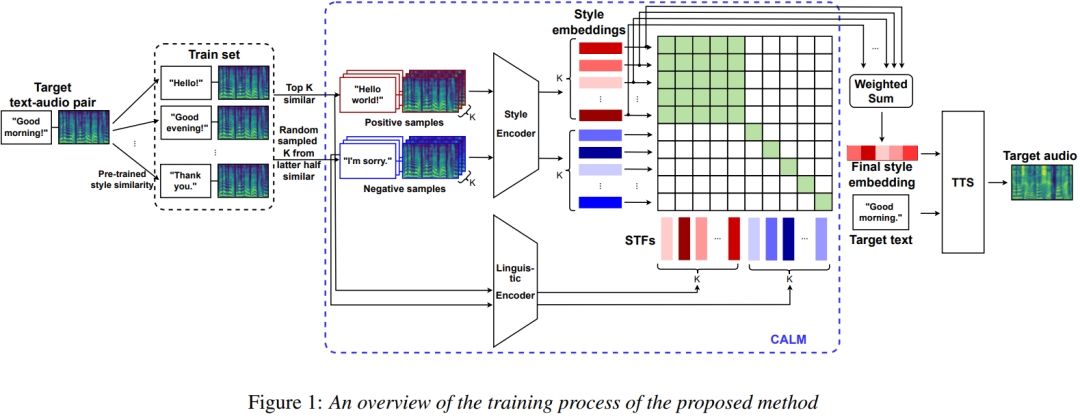
本文由清华大学与腾讯科技有限公司和香港中文大学合作,并 在腾讯公司落地应用 。 说话风格建模对于表现力语音合成具有重要作用。