- @weixin_47520540


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
ESM是用于蛋白质序列建模的深度学习模型。它属于蛋白质语言模型家族,通过对大量的蛋白质序列进行训练,能够学习到序列中的进化信息

摘要:本文介绍了Python虚拟环境创建的两种常见方法,venv和Conda,并比较它们之间的不同之处。文章旨在帮助开发者根据项目需求和偏好选择适合的虚拟环境工具。无论您需要轻量级的Python环境还是跨语言支持和更强大的包管理,本文提供了创建和配置虚拟环境的简明指南。

这篇论文通过使用进化模型(EVcouplings)和优化算法(Gibbs采样)设计出了一系列带有多重突变的蛋白质变体。

ESM3:一个多模态的生成型语言模型:即除了语言模型外,还包括蛋白质的序列结构和功能信息。

本文介绍了一种融合MoE多专家扩展能力和LoRA轻量化优势的MOELoRA方法,用于在消费级显卡上高效微调视觉语言模型(如Qwen3-VL)。该方法借鉴DeepSeekV3的无损耗负载均衡策略,仅通过可学习路由偏置实现专家均衡调用,无需额外损失项。文章详细阐述了MOELoRA的核心实现,包括配置类扩展、MOELoraLayer设计以及与Peft库的集成,并以Qwen3-VL-4B为例展示了在8G显
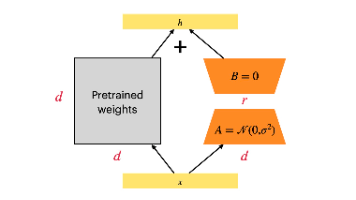
FSFP(Few-Shot Learning for Protein Fitness Prediction)是一种专为蛋白质工程设计的少样本学习策略。它通过结合元迁移学习(MTL)、排序学习(LTR)和低秩适应(LoRA)技术,有效提升了蛋白质语言模型在极少量标记数据下的性能。FSFP通过在相关蛋白质的辅助任务上进行元训练,获取能够快速适应新任务的初始模型参数,然后在目标蛋白质的少量数据上进行微调

本文系统介绍了交叉熵损失在深度学习中的应用,重点分析了其在LLM预训练中的核心作用。文章从数学原理出发,详细推导了交叉熵与熵、KL散度的关系,阐述了其作为分布差异度量的本质。
梳理深度学习优化器的演进历程及其在LLM训练中的应用
进阶:C++算法第二篇
C++算法题第三部分