


- @weixin_45755332


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
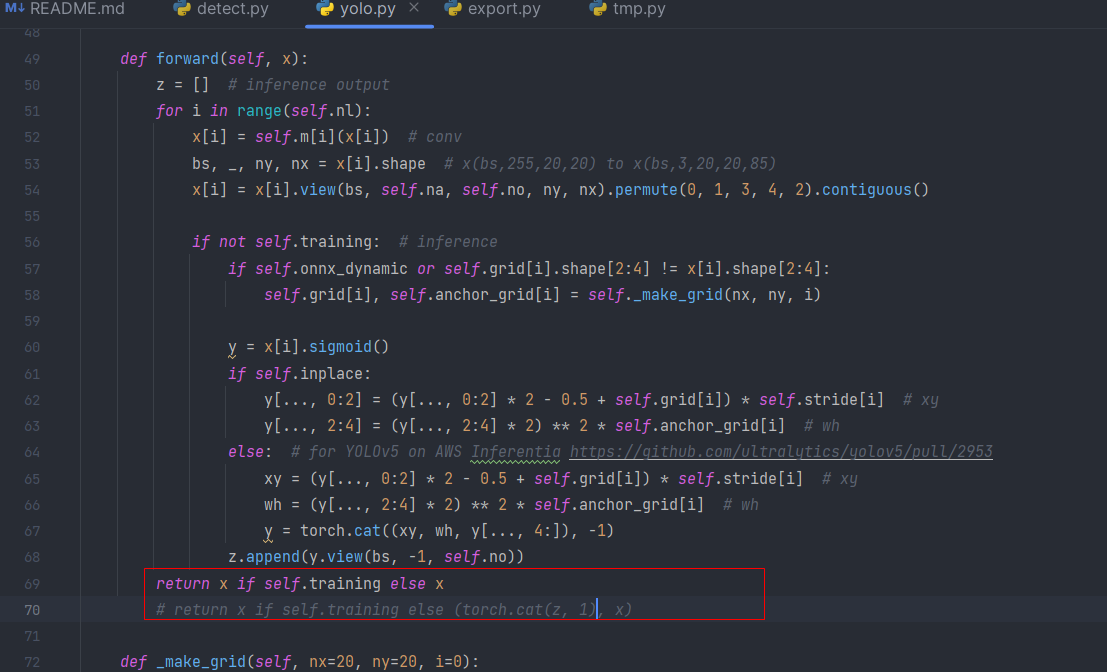
yolo后处理就是模型的输出进行处理,得到我们想要的坐标框的xywhxywhxywh以及confidenceconfidenceconfidence学习笔记这是yolov1的模型,他将图像划分成了7x7个网格,每个网格负责预测两个边界框,每个边界框都有5个信息$x、y、w、h、confidence $ ,(这个confidence是该区域有目标框的概率),共预测20个类,每个类都有一个置信度信息(

如上图所示,我们的目标是切割出所有的盘子,没个盘子单独储存为一张图片,并且里面的水果也还在该盘子的对应位置。类似于这样因为都标注了,有位置信息了,通过大目标框和小目标框的相对位置完全可以切出来。若再标注那工作量就太大了。

毕竟是小白,从小白视角看可能不会太深,但应该都能看懂。这篇博客就是也是写给新手的,希望大家都能学懂学好,嘿嘿,写的不好还望大佬勿喷。
当你的pycharm试用一个月后是不是很崩溃,没钱买正版,又要拒绝盗版,很好的一个思路就是再装一个,继续试用一个月,这样的确有点麻烦,那就试试下面这个插件吧!!!首先,下载这个文件解压后运行一下重启pycharm或者idea就可以再使用一个月了文件可能上传不了,想要的话,可以私聊我...
模型坍塌,在siamese中主要是输入数据经过卷积激活后收敛到同一个常数上,导致无论输入什么图像,输出结果都能相同。而He提出的simple Siamese networks在没有采用之前的避免模型坍塌那些方法:实验表明对于损失和结构确实存在坍塌解,但stop-gradient操作在防止坍塌方面起着至关重要的作用。如图为simsiam 的结构,输入是训练集中随机选取的一个图像,使用随机数据增强生成

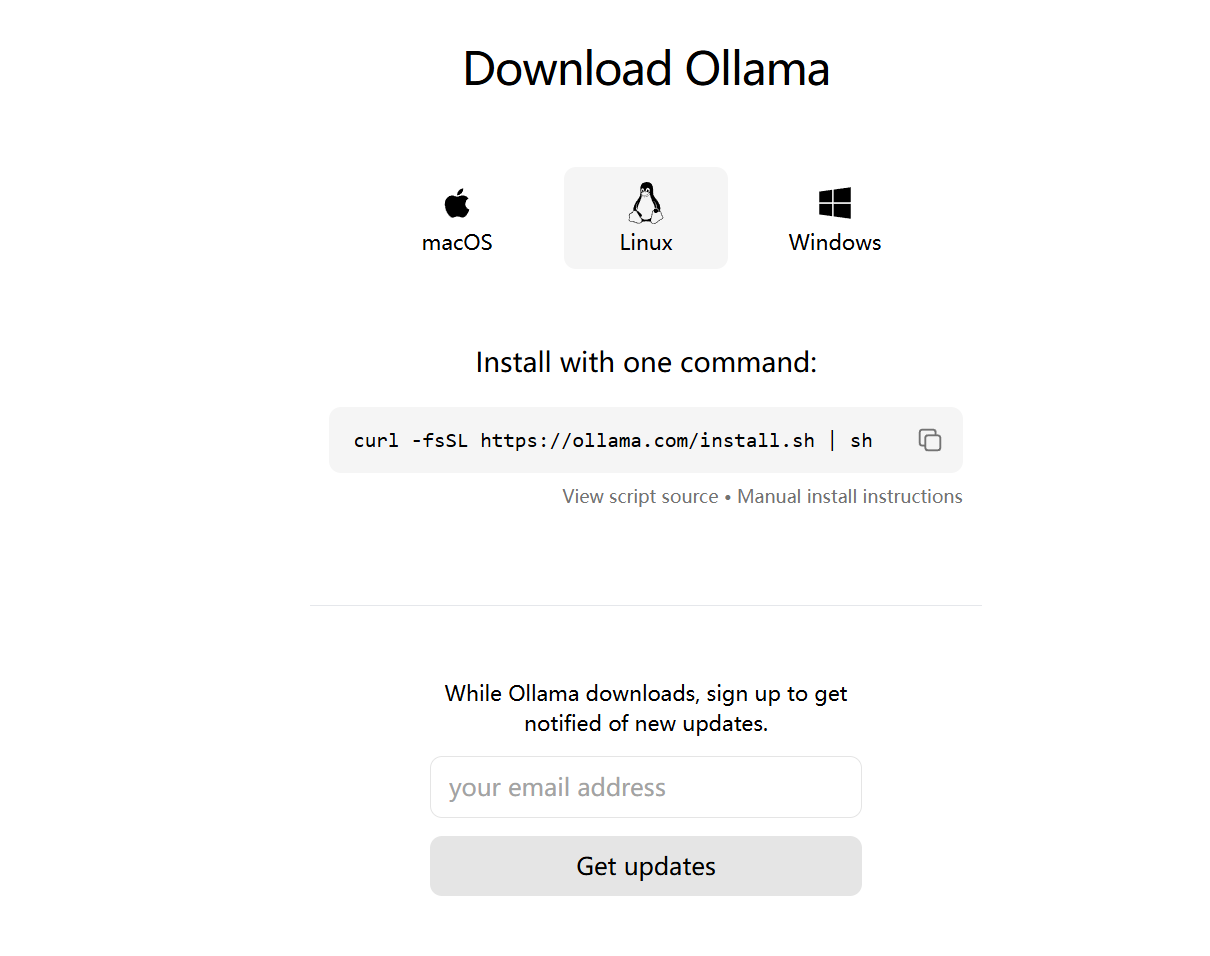
我是Ubuntu系统,NVIDIA 3070 8G显存 16G运行内存,全用cpu也行,运行内存要大一些。第一次进入会让你注册,注册一个即可。点击models即可进入模型列表,比如我们选择deepseek-r1。这里除了deepseek,其他模型也都是在ollama官网下载的。即可安装,安装失败的话就创建个虚拟环境,再pip装。在设置里,这样选择,记得修改你的ip,端口不用改。可以选择不同的模型,
我们属于SoC模式,即我们在x86主机上基于tpu-nntc和libsophon完成模型的编译量化与程序的交叉编译,部署时将编译好的程序拷贝至SoC平台(1684开发板/SE微服务器/SM模组)中执行。注:以下都是在Ubuntu20.04系统上操作的,当然Ubuntu18和22也是可以的,因为我们主要是用的官方 docker 环境进行配置。
Milvus 创建于 2019 年,其目标只有一个:存储、索引和管理由深度神经网络和其他机器学习 (ML) 模型生成的海量嵌入向量。作为专门设计用于处理对输入向量的查询的数据库,它能够对一万亿级的向量进行索引。与现有的关系数据库主要按照预定义的模式处理结构化数据不同,Milvus 是自下而上设计的,用于处理从非结构化数据转换而来的嵌入向量。向量相似性搜索是将向量与数据库进行比较以查找与查询向量最相
香橙派Aipro提供的案例完美的执行成功了,学习起来很适合企业开发者用户。往外继续延伸,如果单纯的使用香橙派Aipro做模型的测试也是很可以的,可惜了我这边内存不太够,没办法做太多太消耗内存的东西。需要自己扩展下存储空间就很完美了,运行大模型肯定也不在话下。跑这个yolov8模型时,从拉下来代码,到搭建环境,再到运行结果,都比较顺利。延迟感觉还是稍慢满打满算一张图需要800ms。不知道跑上多路流然
Milvus 创建于 2019 年,其目标只有一个:存储、索引和管理由深度神经网络和其他机器学习 (ML) 模型生成的海量嵌入向量。作为专门设计用于处理对输入向量的查询的数据库,它能够对一万亿级的向量进行索引。与现有的关系数据库主要按照预定义的模式处理结构化数据不同,Milvus 是自下而上设计的,用于处理从非结构化数据转换而来的嵌入向量。向量相似性搜索是将向量与数据库进行比较以查找与查询向量最相