


- @weixin_44386956


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
使用Python中的selenium库进行微信公众号文章爬取
零样本学习是针对预测未见类别的研究,它可以解决在训练时未预见到的类别问题以及缺乏标记数据集的问题。零样本目标分类的方法之一是使用知识图谱,这是一组显性知识。由于识别限于知识图谱中包含的类别,并且随着图谱大小的不同,类别之间的关系在数量和质量上都有望变得更加丰富,因此处理一个包含尽可能多类别的大规模知识图谱是可取的。我们使用的知识图谱包含的类别数量大约是现有研究中主要使用的知识图谱的七倍,以实现对更

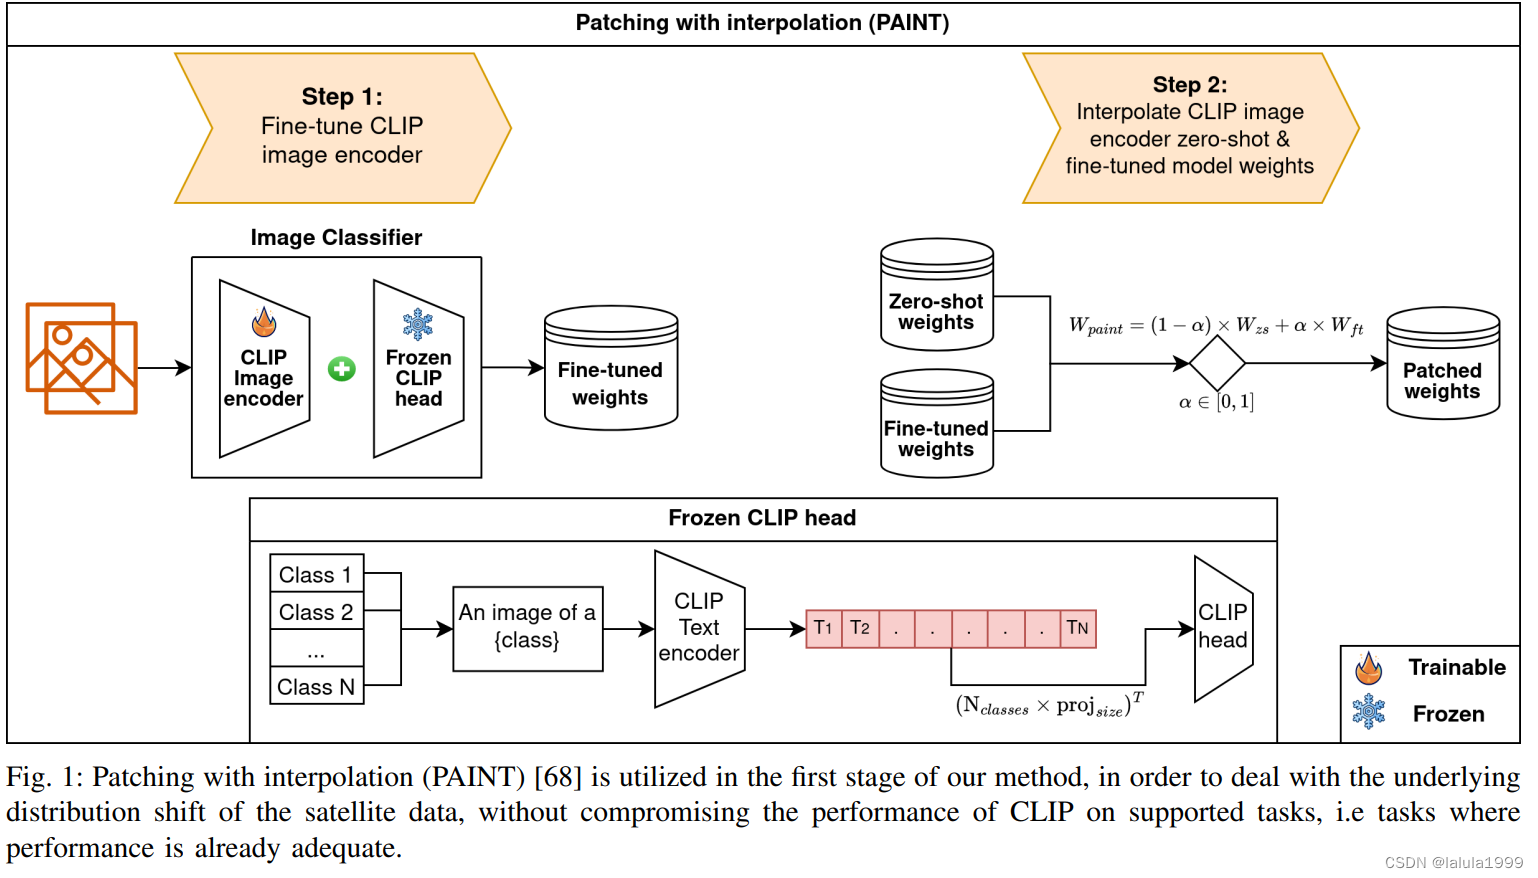
深度学习(DL)正在经历一场范式转变,随着基础模型的出现,这些基础模型被称为关键但不完整的模型。在这项工作中,我们专注于对比语言-图像预训练(CLIP),这是一个开放词汇基础模型,可以在许多图像分类任务中取得很高的准确率,并且通常与完全监督的基线竞争性能而无需显式训练。然而,仍然存在一些域,其中零样本CLIP性能远非最佳,例如遥感(RS)和医学图像。这些领域不仅与自然图像相比具有根本不同的分布,而
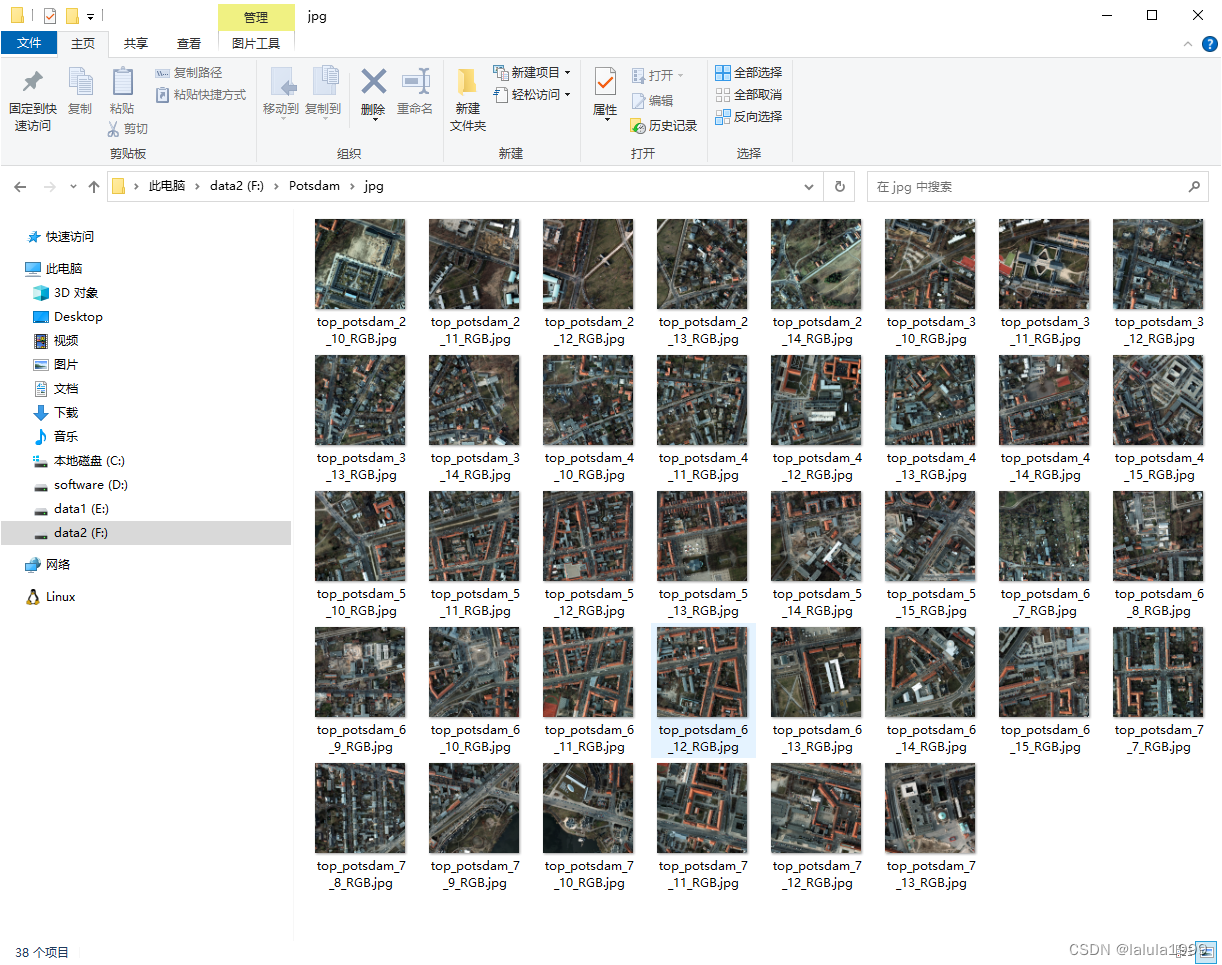
遥感图像不同于一般的自然图像,由于波段数量、图像位深度等原因,TIF图像数据不能使用简单的格式转换方法。本文以Potsdam数据集为例,制作能够直接用于深度学习的数据集。Potsdam数据集的内容如下:本文使用2_Ortho_RGB(图像数据RGB通道顺序)和5_Labels_all(标签数据)作为示例进行数据集制作。
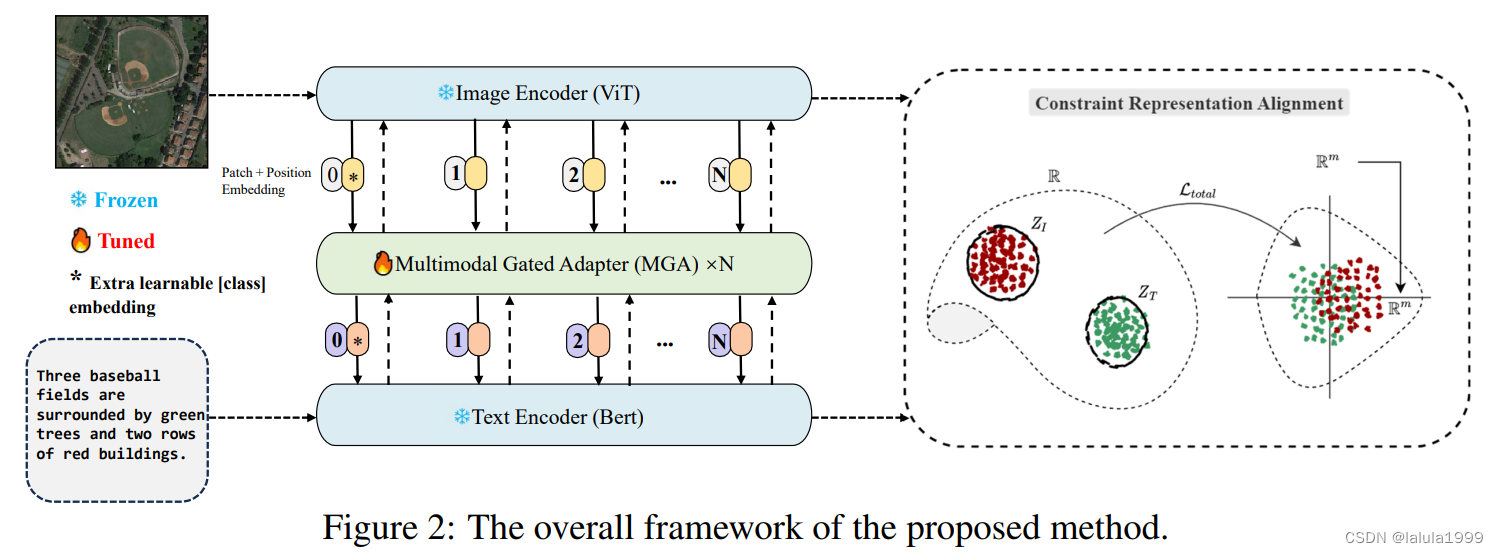
随着视觉和语言预训练(VLP)的兴起,越来越多的下游任务采用了先预训练后微调的范式。尽管这一范式在各种多模态下游任务中展示了潜力,但在遥感领域的实施遇到了一些障碍。具体来说,同模态嵌入倾向于聚集在一起,阻碍了高效的迁移学习。为了解决这个问题,我们从统一的角度回顾了多模态迁移学习在下游任务中的目标,并基于三个不同的目标重新考虑了优化过程。我们提出了“Harmonized Transfer Learn
遥感图像不同于一般的自然图像,由于波段数量、图像位深度等原因,TIF图像数据不能使用简单的格式转换方法。本文以Potsdam数据集为例,制作能够直接用于深度学习的数据集。Potsdam数据集的内容如下:本文使用2_Ortho_RGB(图像数据RGB通道顺序)和5_Labels_all(标签数据)作为示例进行数据集制作。