


- @weixin_41544125


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
关键词:vLLM、Ubuntu、CUDA、Docker、LLM 推理vLLM 是目前社区里最快、最省显存的大模型推理框架之一。本文把官方文档、踩坑经验整理成一篇可落地的技术博客,给出——无论你手里是 A100、4090 还是纯 CPU 服务器,总有一款适合你。
本文详细介绍了如何在 Ubuntu 系统上配置 Nginx 以支持视频文件(如 MP4)的播放。通过逐步说明 Nginx 的安装、配置以及故障排查,本文旨在帮助读者解决视频文件无法播放的问题,并确保视频能够通过浏览器顺利播放。在 Web 开发和服务器管理中,通过浏览器播放视频文件是一个常见的需求。Nginx 作为一款高性能的 Web 服务器,支持多种视频格式的流媒体传输。
量化 + 缩小 KV-Cache + CPU offloading三板斧砍完,70 B 也能在单卡 40 G 上优雅跑。把low_mem.sh拷走改改就能上线,祝显存自由!
实例:2个量子比特对应4种基础状态(00、01、10、11),其状态向量[0.2,0.3,0.3,0.2],代表粒子在这4种状态的分布占比,就像一束光同时透过4个滤镜,每个数值是对应滤镜的亮度,无需手动存储赋值,是粒子本身的状态呈现。本文结合全程深度探讨的核心知识点,摒弃虚头巴脑的话术,全程搭配实例拆解,从程序员视角出发,讲透量子计算的底层原理、运算逻辑、现实困境与破局方案,让你彻底告别玄学,看懂
Crawl4AI不仅仅是另一个爬虫框架,它更像是"LLM时代的wget",重新定义了网页数据提取的工作流程。通过将复杂的浏览器控制、内容提取和LLM优化封装成简单易用的API,Crawl4AI大大降低了高质量数据获取的门槛,使开发者能够将更多精力放在AI应用本身,而不是数据准备上。如果您厌倦了"Scrapy + Splash + 清洗脚本"的繁琐组合,不妨尝试Crawl4AI,它可能会彻底改变您处
通过这个项目,我们不仅掌握了OpenCV的强大图像处理能力,还学会了如何与深度学习模型无缝集成。这种传统计算机视觉与现代AI技术的完美结合,为图像处理领域开辟了新的可能性。无论是创建艺术效果,还是进行智能分类,这套方案都能为你提供强大的技术支持。现在,就让我们一起开启计算机视觉的奇妙之旅吧!💡 小贴士:记得在实际使用时,根据你的具体需求调整参数,创造出属于你的独特视觉效果!关注我,获取更多计算机
量化 + 缩小 KV-Cache + CPU offloading三板斧砍完,70 B 也能在单卡 40 G 上优雅跑。把low_mem.sh拷走改改就能上线,祝显存自由!
定义:爬虫是一种自动化的工具,用于从互联网上抓取数据。应用场景:新闻采集、数据挖掘、搜索引擎等。比喻:爬虫就像一个在互联网上“爬行”的机器人,按照设定的规则找到我们想要的信息。定义:SpiderFlow 是一个基于 Java 的开源爬虫框架,提供了简单易用的接口和强大的功能。特点:高效、灵活、易于扩展。高效:支持多线程和分布式架构。灵活:支持多种解析工具和存储方式。易用:提供简单易用的接口。
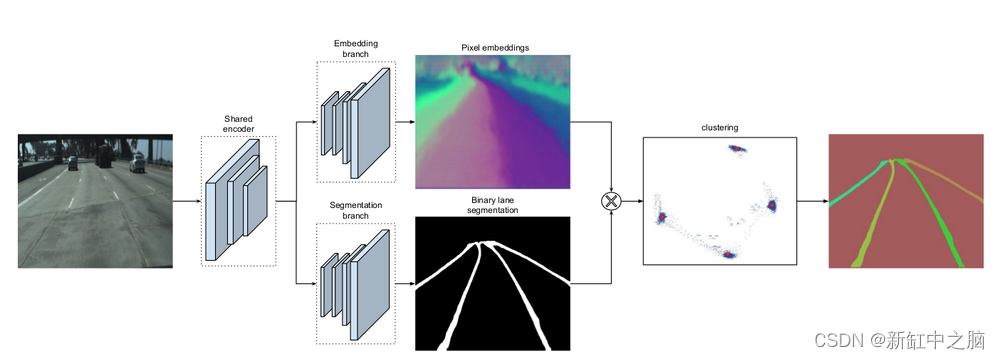
在目标检测中,锚框是预定义的边界框,用于表示可能的目标位置和形状。类似地,在基于锚点的车道线检测中,锚点是预定义的线段,用于表示可能的车道线位置和形状。锚生成:在图像上生成预定义的锚点。这些锚点可以是直线或曲线,具体取决于车道线的形状和方向。通常,会根据数据集的统计信息来设计锚点,以便它们能够覆盖各种可能的车道线形状。锚“移位”/偏差:模型预测锚点的调整,使其与实际车道线对齐。这包括调整锚点的位置
本次时间同步服务部署,核心解决了"依赖源失效"“服务配置冲突”"网络链路拦截"三大核心问题,最终实现了稳定可靠的跨系统时间同步。沉淀出两点关键经验:内网服务优先本地化:对于无外网权限或外网源不稳定的场景,启用本地时钟源、采用离线包安装等方式,可大幅提升服务可靠性。脚本化提升运维效率:将网络检测、双方案同步、日志记录等功能集成到脚本中,不仅降低操作门槛,更能实现故障快速追溯。后续可基于此方案,扩展至