- @weixin_40359938


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
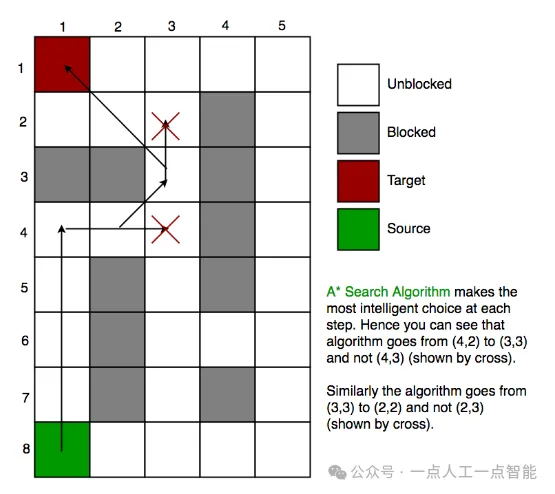
A*搜索算法是一种用于路径搜索和图遍历的效果很好、主流的技术之一。
本文提出了一种折中方案:利用MuJoCo物理引擎的高效仿真能力,结合迭代线性二次调节器(iLQR)算法,构建一种简单但高效的全身模型预测控制框架。该方法的核心优势在于标准化工具链(MuJoCo + iLQR)的采用,显著降低了模型预测控制的实现门槛。
该论文提出了一种分层全身控制框架HWC-Loco,旨在解决人形机器人在复杂环境中的鲁棒运动控制问题。摘要部分明确指出,现有基于强化学习的方法虽在仿真环境中表现优异,但面临仿真与现实(Sim2Real)的动力学差异,且传统鲁棒优化方法常导致策略过于保守。HWC-Loco通过分层策略设计,动态协调目标追踪与安全恢复的平衡,并通过人类行为模仿提升运动自然性。作者指出,经典模型驱动方法依赖精确动力学建模,

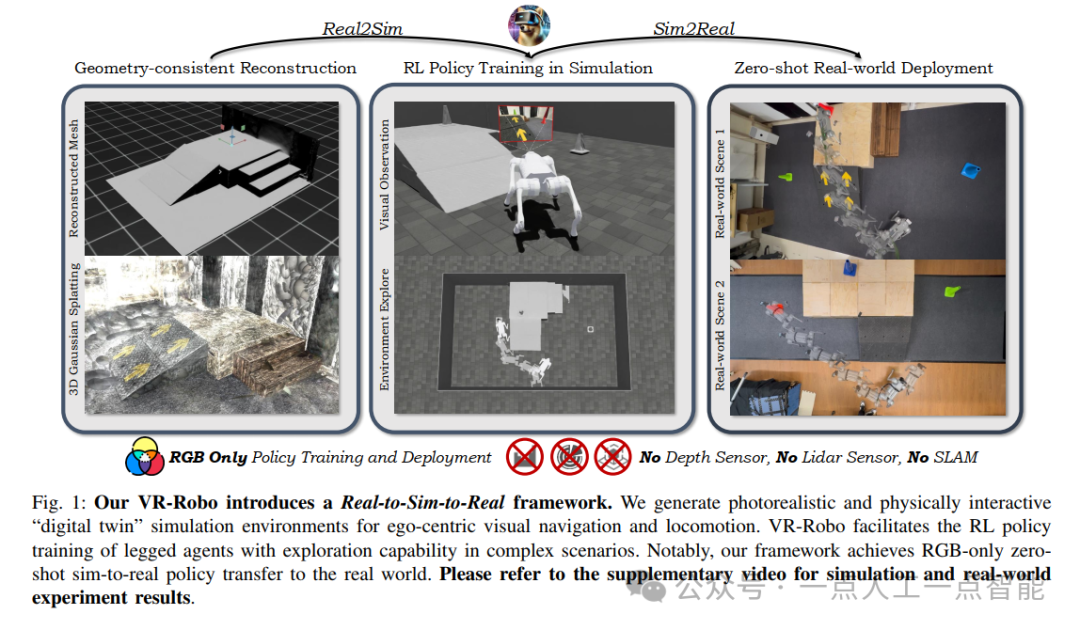
该论文的主要创新点在于提出了VR-Robo系统,实现了机器人在仿真环境与真实世界之间的快速转换。本文介绍了一种名为VR-Robo的框架,该框架能够为视觉导航和机器人运动学习提供真实感强、物理交互性强的数字孪生仿真环境。该方法利用多视图图像进行基于3DGS的场景重建,并将这些环境整合到支持自我中心视觉感知和网格基物理交互的模拟器中。
基于知识图谱构建python代码知识库
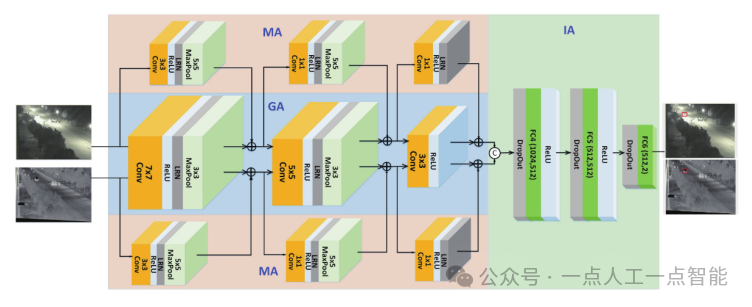
智能融合视角下的RGBT单目标跟踪综述RGBT视觉跟踪技术通过结合可见光与红外模态,有效应对低光环境、遮挡和伪装等复杂场景,显著提升跟踪性能,在多个领域展现出广阔的应用前景。
多模态融合是自动驾驶系统感知的一个基本任务,最近引起了许多研究者的兴趣。然而,由于原始数据的噪声、信息的未充分利用以及多模态传感器的未对齐,实现相当好的性能并不是一件容易的事情。在本文中,我们对现有的自动驾驶多传感器融合感知方法进行了文献综述。整体上,我们对50多篇论文进行了详细的分析,其中包括使用激光雷达和相机尝试解决目标检测和语义分割任务的方法。与传统的融合模型分类方法不同,我们提出了一种创新

收集了17篇点云处理的综述文章,方便大家全面了解三维点云处理的技术发展、了解其发展路线,便于咱们自己的学习规划及学术方向研究。
ChatVLA框架,其核心创新在于分阶段对齐训练和混合专家架构(MoE)。前者通过先掌握控制任务再逐步引入多模态数据的策略保留对齐能力,后者通过共享注意力层与独立MLP层的设计减少任务干扰。
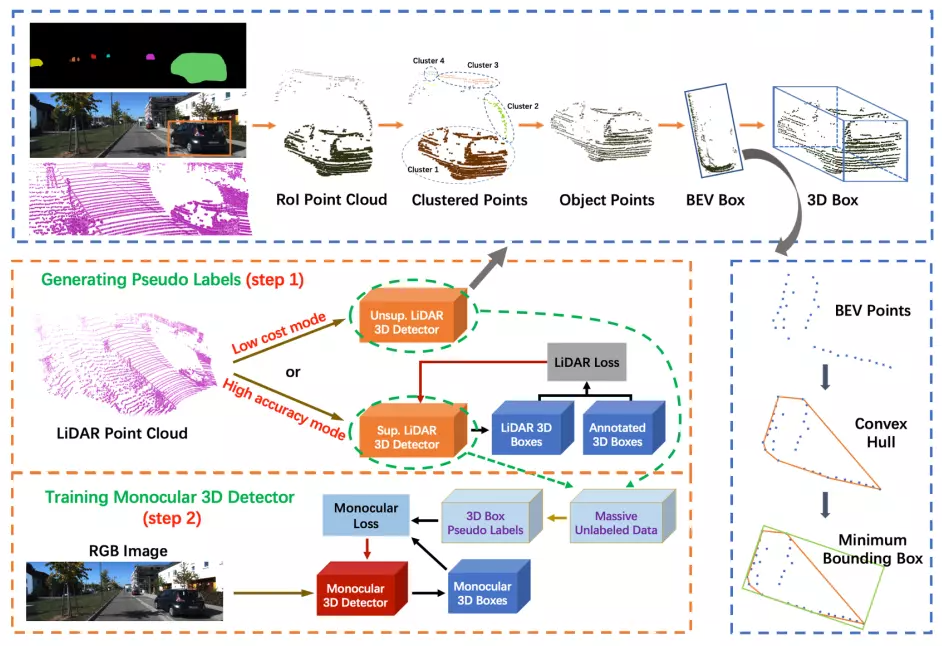
因此,作者团队提出了一个框架(LCPG),在未标记的LiDAR点云上生成伪3D box标签,以扩大单目3D检测器的训练集。有趣的是,对于基于LiDAR的3D检测器,使用不同的训练设置,作者团队根据经验发现,由生成的伪标签训练的单目3D检测器显示出接近的性能。由于精确的3D位置测量,基于LiDAR的3D探测器预测的伪标签相当准确,可以直接用于单目3D检测器的训练。受上述结论的启发,并考虑到激光雷达3