


- @w_2345678


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
通过这个案例,新手可以掌握以下核心价值点步骤掌握的核心概念与技能价值体现数据加载DatasetDataLoader, 数据预处理(transforms理解如何将原始数据组织成模型可用的批量张量,这是所有深度学习项目的第一步。模型定义nn.Modulenn.Linearnn.ReLUforward方法学会像搭积木一样构建神经网络,理解前向传播的流程。训练循环损失函数(criterion)、优化器(o
学术研究与快速原型PyTorch是首选。其动态图特性、简洁的API和活跃的研究社区能极大提升探索效率。大规模生产与部署TensorFlow及其生态(尤其是tf.keras)更为成熟,从训练到服务的工具链完整,适合大型团队和复杂系统。入门学习:从Kerastf.keras)开始最佳。其高度抽象的API能让你快速理解深度学习概念,而不必陷入底层细节。特定需求:若需极致分布式性能或多语言支持,可考察MX
注:这个接口不稳定(因为是第三方镜像站),仅测试用,自己用的话可以换一个稳定的接口,明天出教程。
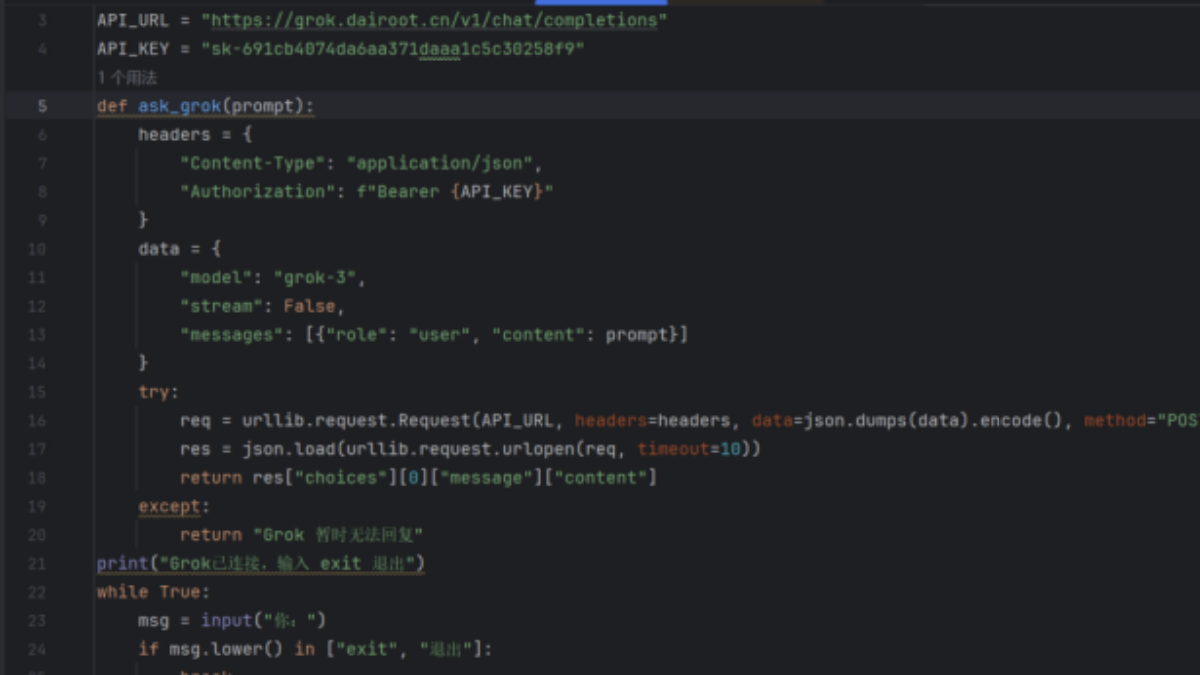
在Python中调用API创建AI聊天窗口,核心是,实现用户输入、API请求、响应展示的完整闭环。以下是两种主流、可立即运行的实现方案,涵盖从环境搭建到代码部署的全过程。
提升AI机器人调用稳定性的根本在于。
通过这个案例,新手可以掌握以下核心价值点步骤掌握的核心概念与技能价值体现数据加载DatasetDataLoader, 数据预处理(transforms理解如何将原始数据组织成模型可用的批量张量,这是所有深度学习项目的第一步。模型定义nn.Modulenn.Linearnn.ReLUforward方法学会像搭积木一样构建神经网络,理解前向传播的流程。训练循环损失函数(criterion)、优化器(o
PyTorch是一个基于Python的开源深度学习框架,以其和直观的编程接口而广受研究人员和开发者欢迎。其核心设计理念是和,使得从快速原型设计到大规模生产部署的流程变得高效。
的闭环,而YOLO因其开源、高效、社区活跃的特性,成为众多科研新手和资深学者验证新想法的首选平台。
学术研究与快速原型PyTorch是首选。其动态图特性、简洁的API和活跃的研究社区能极大提升探索效率。大规模生产与部署TensorFlow及其生态(尤其是tf.keras)更为成熟,从训练到服务的工具链完整,适合大型团队和复杂系统。入门学习:从Kerastf.keras)开始最佳。其高度抽象的API能让你快速理解深度学习概念,而不必陷入底层细节。特定需求:若需极致分布式性能或多语言支持,可考察MX
LeetCode 264题“丑数II”要求找出第n个丑数。丑数定义为只包含质因数2、3、5的正整数(1通常被视为第一个丑数)。核心挑战在于高效生成有序的丑数序列,避免对每个数进行质因数分解判断(效率极低)。:高效解法主要基于动态规划与三指针技术。思路是每个丑数都可以由之前的某个丑数乘以2、3或5得到。使用三个指针p2p3p5分别记录下一个可能乘以2、3、5的丑数位置,每次取生成值的最小值作为新丑数