


- @u010026928


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
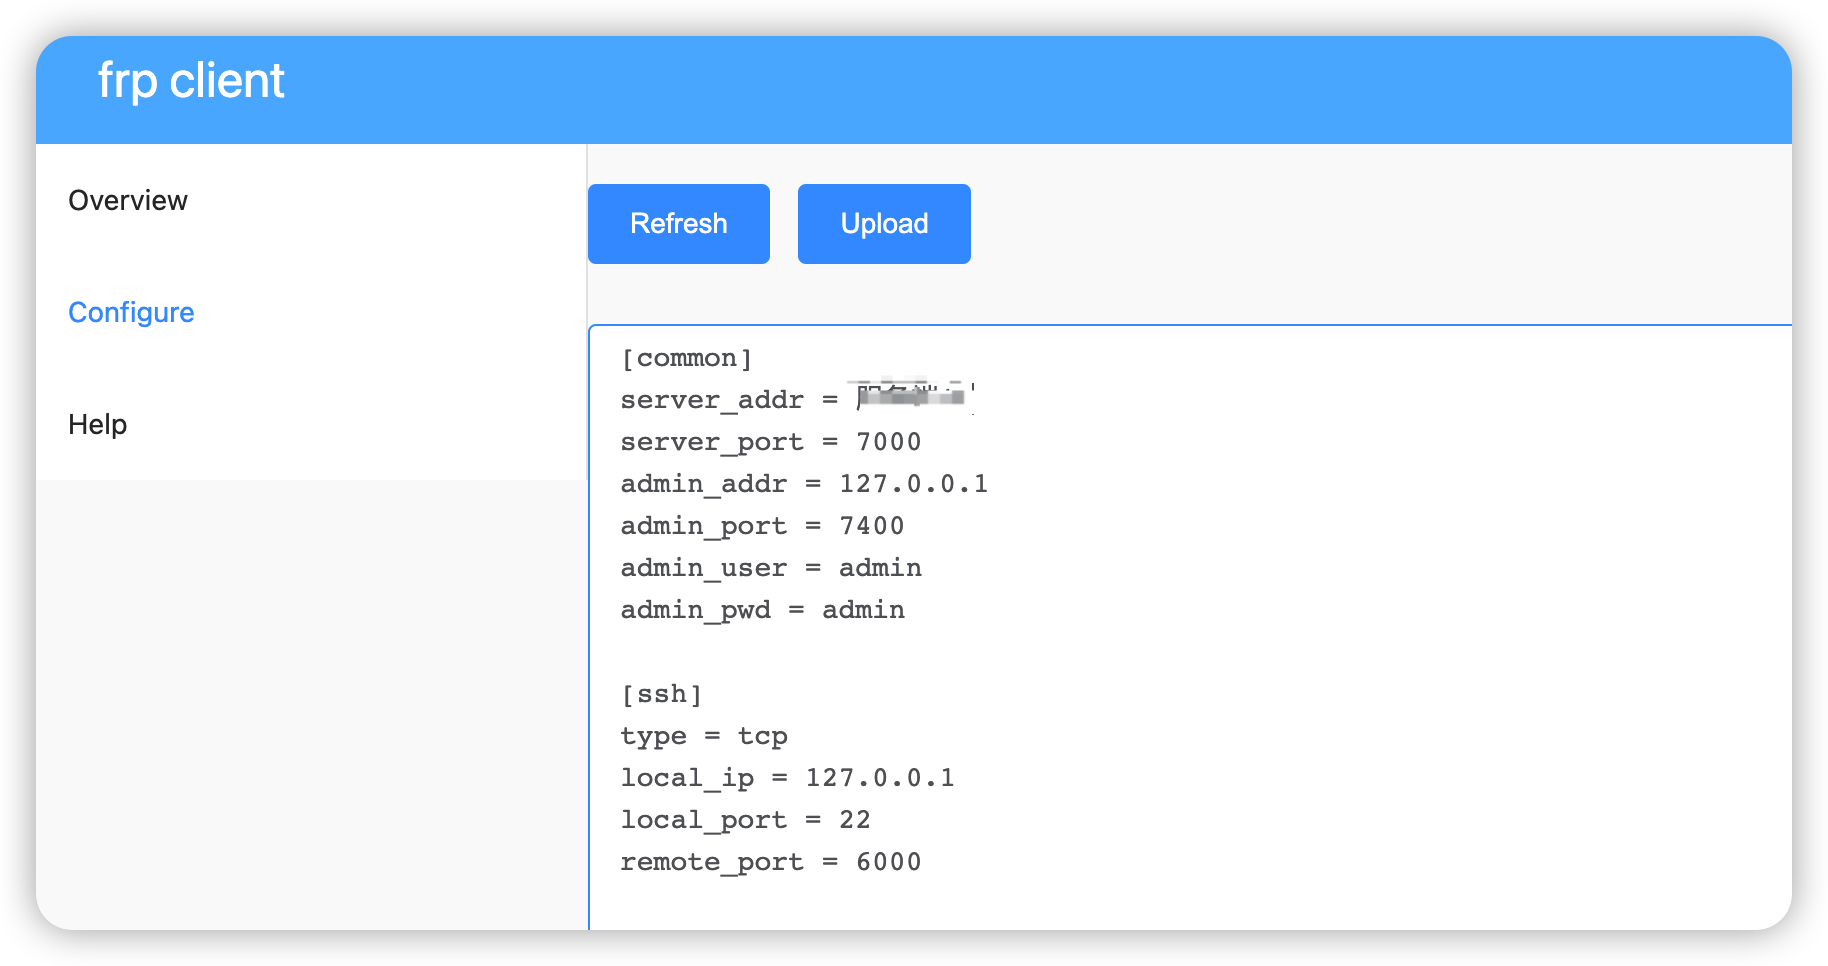
反向代理服务frp客户端,frpc 安装,自启动和使用
Harbor是构建企业级私有docker镜像的仓库的开源解决方案,它是Docker Registry的更高级封装,它除了提供友好的Web UI界面,角色和用户权限管理,用户操作审计等功能外,它还整合了K8s的插件(Add-ons)仓库,即Helm通过chart方式下载,管理,安装K8s插件,而chartmuseum可以提供存储chart数据的仓库【注:helm就相当于k8s的yum】
摘要:本文介绍在NVIDIA DGX Spark(GB10芯片)上部署Qwen3.5-35B-A3B-FP8量化模型的最佳实践。该MoE架构模型(35B参数/3B激活)通过FP8量化将模型大小从65GB降至37.5GB,精度损失<0.5%,同时避免了NVFP4的兼容性问题。部署采用vLLM 0.16.1rc1容器化方案,支持262K上下文长度和自动工具调用功能。关键配置包括:FlashAtt
摘要:OpenClaw 2026.2.x迁移vLLM服务后出现Connection error问题,排查发现models.json优先级高于openclaw.json导致请求仍指向旧服务器。通过strace确认请求被本地拦截,系因连续失败触发cooldown保护机制。解决方案为更新~/.openclaw/agents/main/agent/models.json中的IP并重启gateway。建议使
摘要:本教程详细讲解如何在 Mac(Apple Silicon)上本地部署智谱 AutoGLM-Phone-9B 多模态大模型,实现完全离线、隐私安全的手机 AI 助理。内容涵盖环境配置、模型部署、实战操作和性能优化,适合开发者、隐私敏感用户和 AI 爱好者。通过 ADB 工具和 MLX 框架,用户可在 Mac 上高效运行 9B 参数模型,实现自动化手机操作,如点外卖、发消息等,所有数据处理均在本
僵尸容器的清理需要在每个受影响的节点识别并杀死旧容器的进程停止 containerd清理容器元数据重启 containerd诊断:识别僵尸容器和异常进程清理:杀死进程 → 停止 containerd → 清理元数据 → 重启 containerd验证:确认容器和进程已清理,Pod 恢复正常预防:调整配置,避免再次发生。
该文档基于我们在 NVIDIA Jetson Orin Nano (8GB) 上的实战经验,详细记录了如何将一个庞大的 Fara-7B 模型(原始约 15GB)通过量化压缩到 4.5GB,以便在边缘设备上流畅运行。
随着 NVIDIA Blackwell 架构的问世,将桌面级 AI 算力推向了新的巅峰。这台怪兽级设备搭载了GB200/GB10级别的 GPU 和,并运行在最新的CUDA 13环境下。然而,“最强硬件"往往伴随着"最难环境”。由于 Grace CPU 采用架构,且 CUDA 13 过于前沿,传统的 PyTorch 安装方法极易失败。本文将手把手教你如何在这台超级计算机上部署,并利用其128GB 海
摘要:本文展示了在NVIDIA DGX Spark环境下使用Wan 2.2 Animate 14B模型的工作流程,包含视频预处理、SAM2模型加载、图像缩放控制等关键节点。完整工作流文件支持视频输入处理和结果预览功能。
摘要:本文详细介绍了在NVIDIA DGX Spark服务器(ARM64架构)上部署Kubernetes集群的全过程,重点解决四大技术难题:1)ARM64架构适配问题,2)Grace Blackwell GB10芯片的CDI配置,3)DGX OS驱动兼容性问题,4)国内网络环境下的镜像拉取问题。通过优化containerd配置、使用Helm国内源部署Cilium网络插件,以及关键性地禁用GPU O