


- @sundehui01


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
elasticsearch-head 是用于监控 Elasticsearch 状态的客户端插件,包括数据可视化、执行增删改查操作等。elasticsearch是通过API方式进行管理的,因此也可以使用postman等工具操作elasticsearch。
检查环境是否安装了 Java 的 JDK,因为 Jenkins是用Java 语言写的,要想安装 Jenkins 之前,必须安装 JDK。在CentOS上部署Jenkins有多种方式。
分布式锁:在分布式的部署环境下,通过锁机制来让多客户端互斥的对共享资源进行访问。锁是互斥量。信号量:本质也是一种数据操作锁,它本身不具有数据交换的功能,而是通过控制其他的通信资源来实现进程间通信,从而负责数据操作的互斥与同步。区别:互斥量值只能为0/1,信号量值可以为非负整数。互斥量用于线程的互斥,信号线用于线程的同步。应用场景:通常用于限定能够同时使用的资源数量,如库存、限流等。关注公众号,发送
pgvector 并非独立的向量数据库,而是 PostgreSQL 的向量扩展插件,其核心优势是能复用 PostgreSQL 的现有生态,无需额外部署新数据库,同时也存在超大规模场景下性能不足等局限。
其中,Transformer架构是当前大模型的主流基础架构,由Google于2017年提出,其核心是自注意力机制,能够动态关注输入序列中的不同部分,高效处理长距离依赖关系,同时支持高度并行化计算,为模型的规模化扩展奠定了关键基础。不同于传统AI模型依赖人工定义规则,大模型如同一个通过“阅读”海量数据成长的“超级学习者”,通过自主挖掘数据中的潜在模式与深层规律,实现从“机械执行”到“智能涌现”的跨越
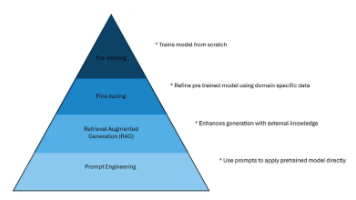
本文系统阐述了人工智能技术的四个关键发展阶段:提示工程(Prompt Engineering)通过优化输入提示引导大语言模型生成精准输出;智能体(AI Agent)作为整合LLM能力的自主系统,通过感知-决策-执行闭环完成复杂任务;微调(Fine-tuning)使预训练模型适应特定领域任务;预训练(Pre-training)则通过海量无监督学习构建基础语言理解能力。这四个技术层级由浅入深,共同推动
大模型对应的英文是Large Language Model(LLM),即大语言模型,简称大模型。技术层面讲,大模型是一种基于深度学习技术的机器学习模型。为什么叫大模型呢?它是相对于小模型而言的。传统的机器学习算法一般是解决某个特定领域的问题(例如文本分类),使用的训练数据集规模较小,参数也比较少。而大模型一般是基于互联网上的海量数据训练而成的,模型参数可达数十亿至数万亿。这些参数就像大脑中的神经元
Ollama 是一个开源的本地大模型部署工具,旨在简化大型语言模型(LLM)的运行和管理。通过简单命令,用户可以在消费级设备上快速启动和运行开源模型(如 Llama、DeepSeek 等),无需复杂配置。它提供 OpenAI 兼容的 API,支持 GPU 加速,并允许自定义模型开发。
所有项目均支持「视觉识别 + ADB 操作」,核心差异在于是否依赖大模型、是否支持跨平台、稳定性 / 易用性 Trade-off。:如需 AI 驱动,集成 GPT-4o 到 Airtest/Appium,实现自然语言指令→脚本生成→执行;多模态大模型(GPT-4V/Qwen-VL)驱动,支持跨 App 复杂任务规划;纯视觉 + 控件双驱动,支持「录制操作→生成脚本」,开箱即用;
大模型对应的英文是Large Language Model(LLM),即大语言模型,简称大模型。技术层面讲,大模型是一种基于深度学习技术的机器学习模型。为什么叫大模型呢?它是相对于小模型而言的。传统的机器学习算法一般是解决某个特定领域的问题(例如文本分类),使用的训练数据集规模较小,参数也比较少。而大模型一般是基于互联网上的海量数据训练而成的,模型参数可达数十亿至数万亿。这些参数就像大脑中的神经元