


- @qq_53256193


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
file.csv生成的file1.csv2,B3,C4,D。

comment_counts = soup.select('.info .detail-state .data-box:nth-of-type(2)') # 评论量。play_counts = soup.select('.info .detail-state .data-box:nth-of-type(1)')# 播放量。up_names = soup.select('.info .up-name
1,安装selenium-- 命令:-- 网络不稳的请换源安装:1.查看谷歌浏览器版本打开谷歌浏览器——点击左侧三个点——点击帮助——点击关于Google chrome2.下载谷歌浏览器webdriver驱动打开百度,输入chrome webdriver,下载谷歌浏览器webdriver驱动或者点击https://www.cnblogs.com/aiyablog/articles/17948703
re.findall():在text字符串中查找所有匹配的内容,如果找到 ,则返回所有匹配的字符串列表;re.search():扫描整个字符串并返回第一个成功的匹配。re.match():从字符串的开始位置匹配一个模式,如果不是起始位置匹配成功的话,match()就返回none。re.finditer():在字符串中找到正则匹配的所有子串,并返回一个迭代器,该迭代器生成match对象。:...):
1.打开电脑属性(对此电脑右键选择属性即可或者直接通过桌面的导航栏底部的搜素)——找到系统高级系统设置——点击环境变量——找到系统变量下的path。3.验证环境变量是否配置成功,win+r打开终端输入cmd,然后输入python即可。4.如果安装过程中选择勾上了添加环境变量(path),后续过程一般可以省略。2.将python解释器安装所在位置复制下来,如图所示。

print('==========', '当前是第{}页'.format(i))该网站属于异步加载网站——直接网页中拿不到,需要借助fidder抓包工具拿取。因为该网页不是常规的josn源码数据,所以需要进行一些处理。3.利用jsonpath解析数据。2.爬取所有数据(翻页参数)利用josnpath解析数据。1.爬取该新闻网站——()的数据,包括标题和链接。可以看到第一页请求网址。首页地址为第一页
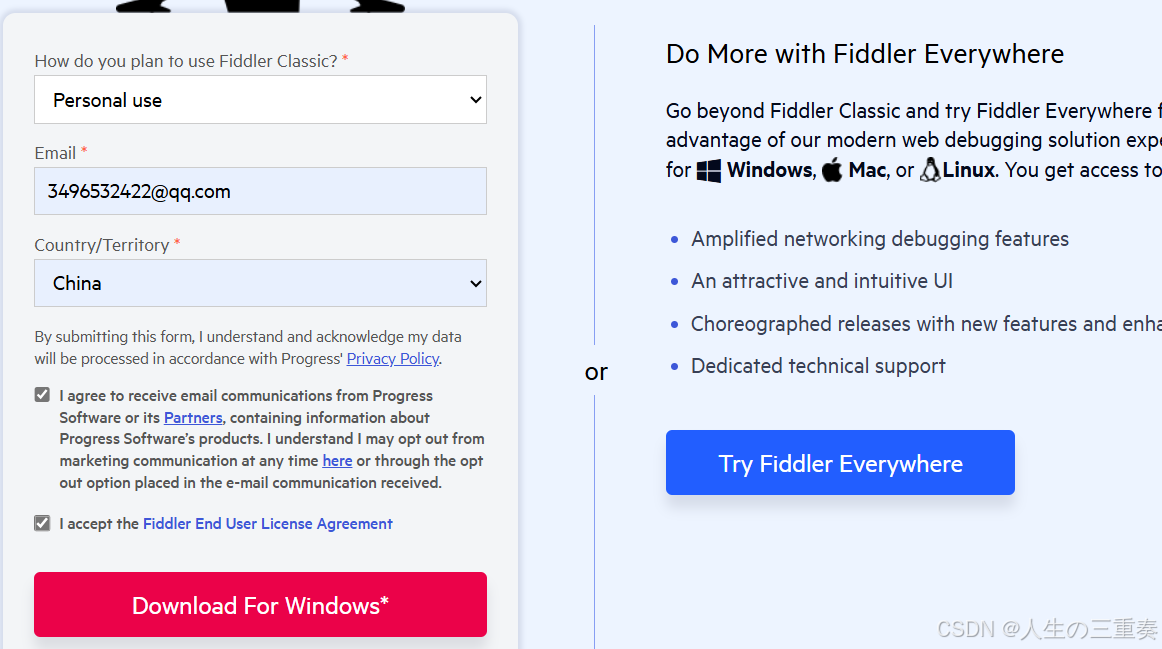
Headers —— 显示客户端发送到服务器的 HTTP 请求的 header,显示为一个分级视图,包含了 Web 客户端信息、Cookie、传输状态等。查看你的本机IP地址,在Fiddler的右上角有一个Online按钮,点击一下会显示你的IP信息。打开你的手机,找到你所连接的WIFI,长按选择修改网络,输入密码后往下拖动,然后选择wifi。XML —— 如果请求的 body 是 XML 格式,
price = s.find_all('span',{'class':'content__list--item-price'})#价格。content = s.find_all('p',{'class':'content__list--item--des'})#地址。print('==========','当前是第{}页'.format(i))包括租房标题、标题链接,价格和地址。refere参数:

网络爬虫(又被称为网页蜘蛛,网络机器人)就是模拟客户端发送网络请求,接收请求响应,一种按照一定的规则,自动的抓取互联网信息的程序。⼀句话——Requests是一个Python代码编写的HTTP请求库,方便在代码中模拟浏览器发送http请求a。http/https 协议 是一种无状态的协议,对事物处理无记忆功能,所以每次请求都是一个独立状态。原则上,只要是浏览器(客户端)能做的事情,爬虫都能够做,也

admin.register(LoginUser)#注册方式2#自定义列表页#注册方式1展示多对多则不是如此应当然后在admin.py将这个改为中文user_name=models.CharField('用户名',max_length=20)desc=models.CharField('描述',max_length=20)age=models.CharField('年龄',max_length=2
