- @qq_44491709


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
使用IDEA直接运行Hadoop项目,有两种方式,分别是本地式:本地安装Hadoop+IDEA;远程式:远程部署Hadoop,本地安装IDEA并连接, 本文介绍第二种。文章目录一、安装配置Hadoop(1)虚拟机伪分布式(2)云服务器分布式二、配置IDEA1、安装配置Maven2、新建Maven项目三、设置连接Hadoop1、Linux中操作2、IDEA中操作四、可能出现的问题一、安装配置Hado

区别:1、ln创建硬链接;ln -s 创建软链接2、硬链接的两个文件指向同一个inode(inode:存放着文件的目录、权限、block块编号等信息);软链接的目标文件指向源文件,目标文件内存储的是源文件的目录3、硬链接删除源文件或者目标文件,打开不受影响;软链接删除源文件后打开目标文件则报错硬链接无法跨区链接,也无法链接目录;软链接不仅可以跨区,还可以链接目录4、由于硬链接是指向同一inode,

思路:读取文件并遍历foreach ($line in Get-Content -path .\test.sql)正则匹配if ($line -match ‘bdw_\w*.\w*’)这个匹配会输出True或False,需要使用$matches输出输出{write-output $matches[0]}}Tips1:如果有需要,灵活修改正则匹配的方式即可。修改这个 -> ‘bdw_\w*.\w*’

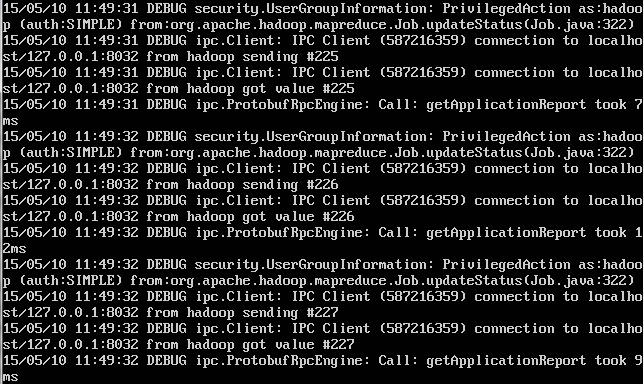
第一种:配置问题这是别人的图片,据楼主排查解决是因为hosts配置问题???我想知道hosts没配置好,Hadoop是怎么撑到MR的…现象:各种无法运行、启动解决办法:1、修改日志级别export HADOOP_ROOT_LOGGER=DEBUG,console查看下详细信息,定位到具体问题解决第二种:服务器问题**现象:**运行到job时卡住不动**原因:**服务器配置低下,内存小或磁盘小**解
https://api.openai.com/v1/chat是openAI的API接口地址,因为长城的原因,23年年初一次更新后便无法访问,访问接口会提示Error: connect ETIMEDOUT等网络相关的问题。解决办法有三种。

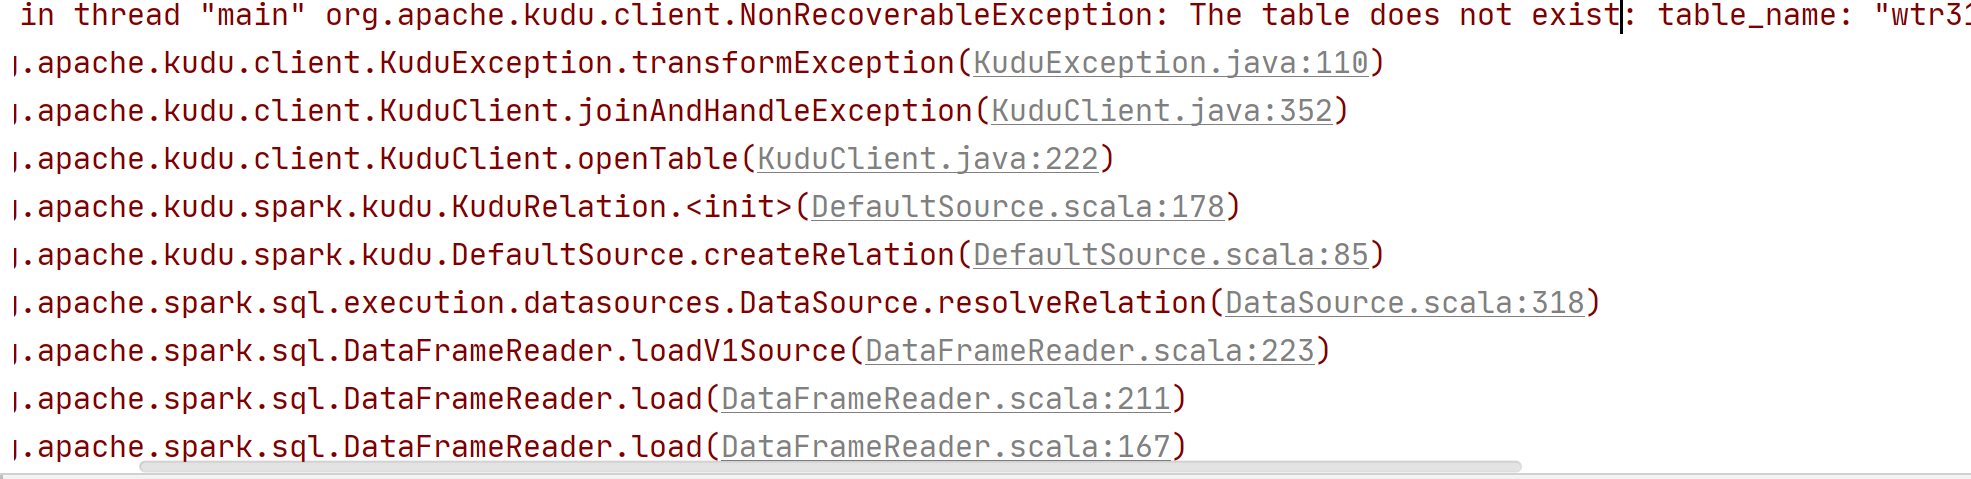
报错:原因:没有指定库解决方式:在kudu master ui查看添加到代码中:// 读取kudu// 获取tb对象val kuduTb = ss_kudu.read.format("org.apache.kudu.spark.kudu").option("kudu.master", "10.168.1.12:7051").option("kudu.table", "impala::realtim
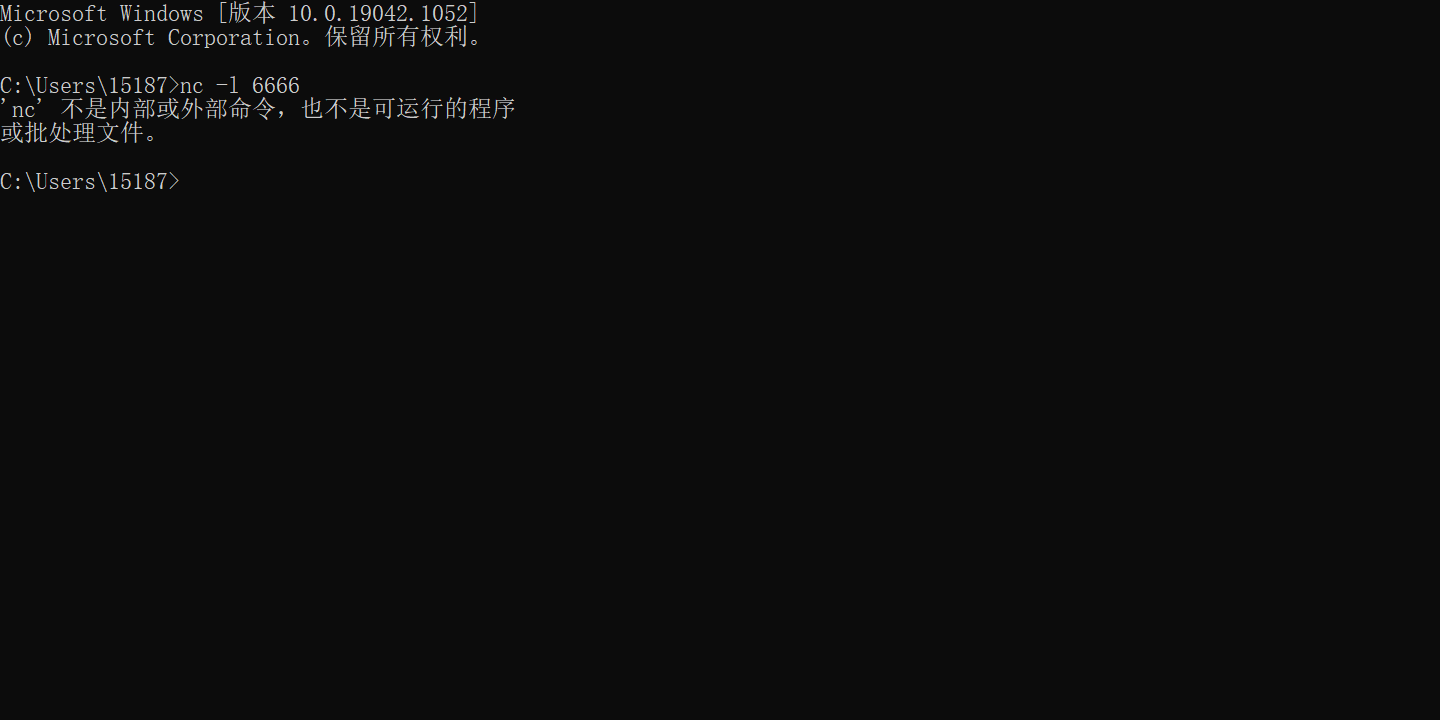
== ‘nc’ 不是内部或外部命令,也不是可运行的程序?==点击链接地址,下载压缩包。完成后解压使用方式(三种):1、直接双击exe使用2、把这个exe放到cmd启动的默认路径下放到默认路径下,使用nc,会自动运行那个软件3、把解压路径添加到环境变量添加到环境变量后,无论是在哪个路径,只要使用nc命令,都能启动那个软件。Tips:如果杀毒软件报错,请退出杀毒软件。...