- @qq_42066648


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
动态规划动态规划的三要素重叠子问题、最优子结构、状态转移方程明确「状态」 -> 定义 dp 数组/函数的含义 -> 明确「选择」-> 明确 base case。第⼆个凑零钱的问题,展⽰了如何流程化确定「状态转移⽅程」,只要通过状态转移⽅程写出暴⼒递归解,剩下的也就是优化递归树,消除重叠⼦问题⽽已。计算机解决问题其实没有任何奇技淫巧,它唯⼀的解决办法就是穷举,穷举所有可能性。算法设
在此,我们基于上述思想提出两种实用的策略优化算法,它们分别采用前一节中的单路径采样或藤蔓采样方案。这些算法重复执行以下步骤:使用单路径或藤蔓采样过程收集一组状态-动作对及其蒙特卡洛估计的QQQ值。通过对样本求平均,构建式(14)中的目标函数和约束的估计。近似求解此约束优化问题以更新策略的参数向量θ\thetaθ。我们使用共轭梯度算法,随后进行线搜索,总体计算成本仅略高于梯度本身的计算。详见附录C。
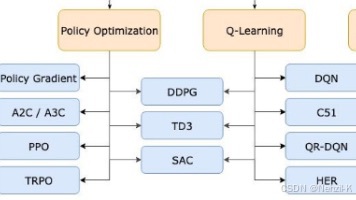
我们提出了一种新的神经网络架构,该架构在深度$Q$网络中解耦价值和优势,同时共享一个公共的特征学习模块。这种新的竞争架构与一些算法改进相结合,在具有挑战性的Atari领域中,相对于现有的深度强化学习方法取得了显著的改进。本文所呈现的结果是该热门领域的最新技术水平。
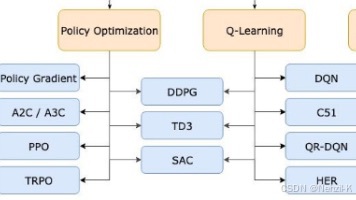
摘要 TD3算法针对Actor-Critic方法中的函数近似误差问题提出了三重改进方案。该算法通过Twin Critic网络结构(使用两个独立Critic并取其最小值)有效减少了Q值高估偏差;采用延迟策略更新机制(Actor更新频率低于Critic)降低误差累积;引入目标策略平滑技术(在目标动作上添加噪声)防止过拟合。实验证明,这些改进使TD3在连续控制任务中显著优于DDPG等现有方法,其中Twi
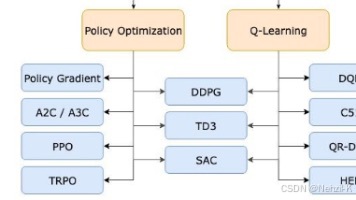
本文提出了一种轻量级的深度强化学习框架A3C(Asynchronous Advantage Actor-Critic),通过异步并行训练来稳定深度神经网络控制器的学习。该方法无需经验回放机制,而是利用多个并行智能体-学习器在不同环境实例中异步收集经验并更新全局网络。A3C结合了n步回报和优势函数估计,有效解决了传统在线强化学习中的数据相关性和非平稳性问题。实验表明,A3C在Atari游戏、连续控制
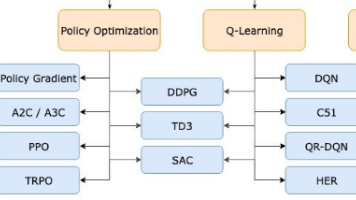
本文提出了一种基于动态Voronoi图与未知连通区域质心的新型多机器人自主探索方法CURE。与现有方法相比,本文的关键新颖性体现在两点:1)**<u>动态Voronoi分区 + 参数不敏感效用函数</u>**:利用质心信息评估探索增益,引导机器人探索未知区域;2)**<u>全局/局部分层窗口的质心检测机制</u>**:当局部窗口未检测到质心时触发全局窗口,以补足目标并提升覆盖。
本文档描述了牵引-挂车系统的轨迹跟踪控制算法实现。该控制器采用模型预测控制(MPC)方法,通过离散化牵引-挂车运动学模型预测未来状态,并优化控制输入使系统跟踪参考轨迹。控制输出为牵引车速度v和转向角δ。状态向量包含牵引车位置、航向角及各挂车航向角。控制器从后端规划器获取参考轨迹,截取预测窗口进行误差计算,并考虑速度、转角和控制增量约束。误差计算采用直接状态跟踪方式,通过参考状态与预测状态相减实现。
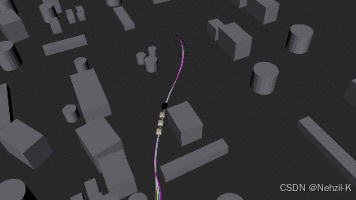
本文介绍了一个基于深度强化学习的车辆横向控制项目RL-DQN-Vehicle。该项目实现了完整的车辆控制系统,支持10种强化学习算法(DQN、DDQN、DDPG等)和4种赛道类型(圆形、正弦等),提供从训练到评估的全流程功能。系统基于自行车运动学模型,具有模块化设计、详细注释和可视化功能,适用于教学、研究和工程应用。项目支持离散/连续动作空间,提供训练曲线、轨迹动画和性能指标等可视化输出。环境要求
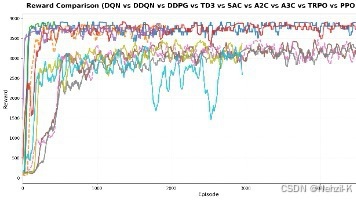
模型预测轮廓控制(MPCC)在车辆极限避障中的应用 摘要 本文提出一种基于非线性单轨车辆模型的模型预测轮廓控制(MPCC)方法,用于解决自动驾驶车辆在极限工况下的避障控制问题。该方法创新性地将运动规划、路径跟踪和车辆稳定性控制集成到统一框架中,采用笛卡尔坐标系和轮廓误差概念克服了传统Frenet坐标系的距离高估问题。控制器使用非线性单轨车辆模型结合Fiala轮胎模型精确描述极限工况下的车辆动力学,
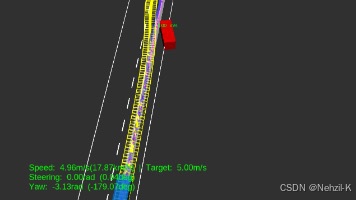
CILQR算法摘要(≤150字): CILQR是一种约束优化算法,结合iLQR高效性和约束处理能力,适用于自动驾驶轨迹规划。算法核心为:1)采用运动学自行车模型描述车辆状态演化;2)构建包含轨迹跟踪、控制平滑和约束满足的代价函数;3)通过迭代线性化求解,每次迭代计算状态/控制雅可比矩阵,执行后向传播获得反馈增益,前向传播更新轨迹,辅以线搜索确保收敛。算法优势在于高效处理多种约束(道路边界、障碍物等