- @qq_32682301


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
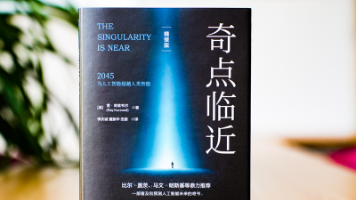
人工智能飞速迭代的今天,大模型不断刷新我们对机器智慧的认知。很多人好奇:AI 的边界到底在哪里?未来人类与机器会是什么关系?十几年前,未来学家雷・库兹韦尔就在《奇点临近》这本书里,给出了一套大胆又震撼的推演。这本书是人工智能未来预测的经典之作,也得到比尔・盖茨等行业大佬推荐。当下大模型爆发,其实已经部分印证了书中的预言:机器开始学习语言、创作、推理,向着人类认知靠近。我们正在一点点走进库兹韦尔笔下
这次环保项目的迁移结果,说实话比我预期的好很多。我一开始的预期是"性能不比SQL Server差太多就行",结果实际测出来复杂查询场景反而快了一个数量级。100并发TPS提升60%,响应时间压缩到十分之一,BI报表从两秒变两百毫秒——这些数据不是实验室理想环境跑出来的,是真实业务系统上的压测结果。当然了迁移过程中也有踩坑的地方。比如SQL Server的一些特殊系统存储过程迁移过来不能直接用,得用
推荐系统中的冷启动分为物料冷启动和用户冷启动。用户冷启动主要是针对新用户,但有时候也用于低活用户拉活。物料冷启动主要是让优质物料得到快速下发,让模型可以迅速捕获到用户对该物料的关注。本文将详细讲解用户冷启动和物料冷启动。

这次环保项目的迁移结果,说实话比我预期的好很多。我一开始的预期是"性能不比SQL Server差太多就行",结果实际测出来复杂查询场景反而快了一个数量级。100并发TPS提升60%,响应时间压缩到十分之一,BI报表从两秒变两百毫秒——这些数据不是实验室理想环境跑出来的,是真实业务系统上的压测结果。当然了迁移过程中也有踩坑的地方。比如SQL Server的一些特殊系统存储过程迁移过来不能直接用,得用
这又是一种新的同步需求——不只是数据库到数据库,还得支持数据库到消息队列(Kafka、RocketMQ)、到大数据平台(Hadoop、Hive、ClickHouse)、到搜索引擎(ElasticSearch)的同步。等全量搬迁完成后,再启动数据加载,把缓存的增量数据追上去。主要讲了KFS的整体架构、异构数据同步的难点、数据初始搬迁的方案、同步拓扑的灵活性、目标端入库的几个核心优化(批量提交、小事务
│ 第一层:systemd托管 ││ → 负责进程崩溃后的快速重启 ││ 第二层:systemd timer健康检查 ││ lac-healthcheck.timer - 每5分钟 ││ → 深度检查:进程状态、日志错误、license时效 ││ → 发现问题自动重启服务 ││ 第三层:告警通知 ││ 健康检查脚本 → webhook → 钉钉/企微/邮件 ││ → 恢复事件通知、失败升级通知 │

我查了资料,金仓数据库(KES)对PL/SQL的支持是分层的,想知道KES到底有多兼容,可以从基础语法、复杂逻辑处理和系统包依赖这三方面看,先说基础语法,KES和Oracle的数据类型、控制语句支持得很像,特别是集合类型,VARRAY的声明和初始化语法跟Oracle一模一样,原来怎么定义数组现在还怎么定义,一行代码都不用改!这种兼容性不但省钱省力,而且保证代码逻辑不变,我觉得这点很好。
合合信息 “大模型加速器 2.0” 的推出,无疑为大模型应用领域带来了新的曙光。其在文档解析、图表处理、溯源功能以及知识库构建等方面的创新与升级,切实解决了行业内诸多痛点问题。从技术实力上看,无论是对复杂版面的精准解析,还是图表数据的 “逆还原”,都展现出其强大的处理能力,有效降低了大模型的 “幻觉” 风险,为数据的可靠性提供了坚实保障。而溯源功能更是让大模型的黑箱操作变得透明,增强了用户对大模型

在人工智能(AI)技术的浪潮下,尤其是AIGC(如ChatGPT、Midjourney、Claude等)大语言模型的崛起,程序员的工作领域正经历着翻天覆地的变化。AI辅助编程工具不仅革新了编码实践,还引发了关于AI是否会取代程序员角色的广泛讨论。然而,更现实的视角是,AI应被视为提升工作效率和创造力的伙伴,而非对手。在此背景下,程序员如何保持并提升自身的核心竞争力,成为了一个值得深入探讨的话题。
AI虚拟数字人:商业模式+形象创建+视频直播+案例应用》一书以实战案例为主,通过以下4篇内容,帮助读者完成AI虚拟数字人从入门到精通的学习。商业模式篇:介绍了AI虚拟数字人的前景、价值、原理、应用、产业链、商业模式等内容。形象创建篇:介绍了生成虚拟数字人的工具和平台,以及使用主流软件剪映和腾讯智影生成与设置数字人的过程。视频直播篇:介绍了数字人的视频直播素材和效果的制作与剪辑,丰富画面的各类效果。