- @milu_ELK


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这个子树是怎么得到的呢,首先在图1中我们可以看到a到bcd都有路径,在树中每个结点旁边的数字即为它的下界,比如b的下界是3=1+2,即入度+最小出度。对应的,c是7,d是11。接下来按广度优先遍历第三层,同理我们发现abc这条路径上,c的下界是6,而ac路径上c的下界是7,也就是说abc优于ac,因此我们舍弃了ac的子树不再遍历。而我们对于重复遍历的结点,仅仅保留最短路径的子树,即aeq和bg两个
假设n可以拆分成a+b,要求ab最大值,n2=a2+2ab+b2,n2-(a2+b2)=2ab,两边同时加上2ab得n2-(a2-2ab+b2)=n2-(a-b)2=4ab,n不变,a-b的绝对值越小,ab越小,反之 a-b的绝对值越大,ab越大。例题用贪心算法,从2开始依次从n中拆出自然数,使得乘积尽可能大,a[k]数组代表第几个因数,其值代表这个因数的数值,直到n
再看上图b的图形,假如要在这个图形中得到最优子结构,即权值和最小,那么如果把这个n边形分成两个子多边形+一个三角形,那么这两个子多边形各自所划分的结构也应当是最优子结构,因为整体最优那么部分一定也是最优,否则如果部分有更优结构,整体就不会是最优结构。t[i][k]代表Vi-1~Vk的图形,t[k+1][j]代表Vk~Vj的图形,w(Vi-1VkVj)代表它们分出的三角形,三者之和正好为我们所求的划
对象池技术是老生常谈的一个概念了,很简单,无论是软件开发还是编程语言的学习中,我们都经常接触到池化技术。池化技术指的是将一些常用的变量或对象存储到一个公共池中,当我们需要调用这些变量或对象的时候,直接引用公共池中的对象而无需new一个新对象。例如管理socket的连接池,管理string的Intern字符串池,还有管理GameObject的对象池等等等等。在Unity中,如果你想要实现发射子弹的功
最近在学习Unity游戏设计模式,看到两本比较适合入门的书,一本是unity官方的,另一本是这两本书介绍了大部分会使用到的设计模式,因此很值得学习本专栏暂时先记录一些教程部分,深入阅读后续再更新。
此外还有改进算法,在已知s存储最优子结构的根节点的情况下,用i1,j1区分[i][j]的左右子树期望代价数组m[i][i1],m[j1][j],其中当s[i][j-1]>i,说明i一定在s[i][j-1]的左子树内那么求m[i][j]的期望代价实际就是求左右区间m【i】【s[i][j-1]】和m【i】【s[i+1][j]】的期望代价之和,直接使得i1=s[i][j-1],反之i1=i,j1亦然。如
即减少最后一个作业的时间,p(i-ak,j,k-1)代表A不处理这个作业,但B的用时仍然相同,p(i,j-bk,k-1)代表B不处理这个作业,但A的用时仍然相同。这种题目只能遍历来查找,如果我们将7视作a[1][1],5视作a[5][2],用m[5][2]代表a[5][2]到a[1][1]的最大路径,那么m[5][2]的途径最大路径中一定有max{m[4][1],m[4][2]}即两条分支路径到a
求最大字段和的方法很简单,对于给定范围的字段,累加就行了,比如给出了例题的 a1~a6,那么直接累加计算,max(a1,a6 )=max(a1,a5)+a6,以此类推,如果用动态规划的思想,那么我们在每一次扩大相加的子段范围的时候都应该保存其累加值,比如b[2]=9,b[3]=5,5
上一章——监督学习与无监督学习回到上一章的第一个例子,依旧是卖房子所有的数据点都拥有Price和Size两个属性/特征,我们根据它的属性制作了一个数据表我们将上面这些数据的集合称之为数据集,而若用它来进行机器学习训练便称其为训练集而机器学习的目的就是通过给出的训练集来学习如何预测房价其中m代表训练集的数据量x代表训练集的输入的特征y代表训练集的输出的目标变量用(x(i),y(i))x^{(i)},
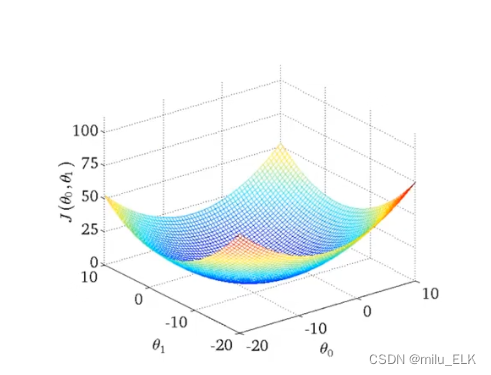
在整个神经网络模型的选择上我们也是这样测试的,例如这三个模型的隐藏层,我们计算得到二号模型的参数对应的验证误差较小,那么我们就可以使用第二个神经网络训练的参数,如果想要得到泛化误差的估计值,我们就可以用这个参数带入计算测试误差。较低,代表了训练误差低,这是必然的,因为我们是基于训练集的数据来最小化代价函数进行参数选择的,因此拟合出来的函数的训练误差一定是较小的。那么假如,我们按照刚才的模型评估的步