


- @m0_73426012


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
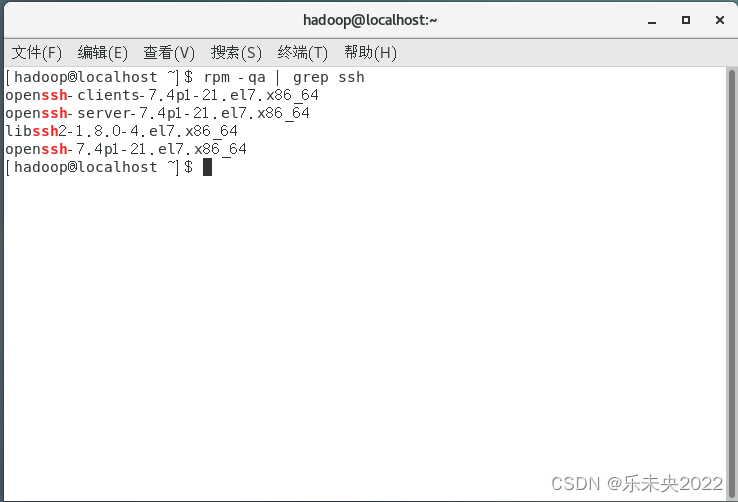
本教程主要参考厦门大学林子雨老师的安装过程,使用VMware Workstation Pro、centos7,配置一个主节点(master),两个从节点(slave01,slave02)的全分布式hadoop集群安装教程,主要记录一下本次实验完成过程,大家有疑问之处欢迎在留言区评论~在此奉上林子雨老师的原安装教程,本教程具体代码完全参考林老师的,重在流程,故不再赘述代码,大家在安装过程中若发现不确
map任务的shuffle writer过程完成后,增加了一个额外的操作push-merge,将数据复制 份推到远程shuffle服务.上magnet shuffle service是一个强化版的ESS。目前在各个引擎中shuffle都是优化的重点,在spark框架中,shuffle 是支撑spark进行大规模复杂数据处理的基石。如果magnet上的block因为重复或者冲突等原因,没有正常完成m
本文背景:第一次远程使用实验室的服务器进行跑代码,面对师兄给的教程,还是不太清楚总体的步骤,因此想和大家分享一下第一次应该秉持什么样的安装思路。其实具体到每一步,都可以搜到很多详细的教程,所以我也就不具体展开了,大家有什么不懂的地方欢迎在评论区交流,我们小白群体一起加油!5.在安装好anaconda以后,使用mkdir命令创建data文件夹用来存放数据集和代码,用xftp工具与服务器连接,把本地的

这些信息的查看可通过“ifconfig"命令以及“左上角选项卡-编辑-虚拟网络编辑器”查看,DNS1设置为与网关相同,DNS2设置为谷歌的公共DNS服务器8.8.8.8即可。许久未用虚拟机,在连接网络时发现上不了网,苦苦挣扎了两个小时,终于解决,在此记录一下~最后希望我们以后不要再在网络这里栽跟头了[笑哭][祈祷]5.测试:ping一下网关和百度,显示连接成功。3.修改resolv.conf配置文

3.重新检查现在cuda是否可用,返回True即解决。

很详细,但只有单机和伪分布的,所以笔者在此记录一下全分布式的安装教程,希望对读者有帮助!安装并配置HBase2.4.1安装通过查找网上资料得知,hadoop2.10.1版本与2.4.1版本的hbase兼容。1.1解压安装包至路径/usr/localcd ~下载。

这些信息的查看可通过“ifconfig"命令以及“左上角选项卡-编辑-虚拟网络编辑器”查看,DNS1设置为与网关相同,DNS2设置为谷歌的公共DNS服务器8.8.8.8即可。许久未用虚拟机,在连接网络时发现上不了网,苦苦挣扎了两个小时,终于解决,在此记录一下~最后希望我们以后不要再在网络这里栽跟头了[笑哭][祈祷]5.测试:ping一下网关和百度,显示连接成功。3.修改resolv.conf配置文
