


- @m0_57280180


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
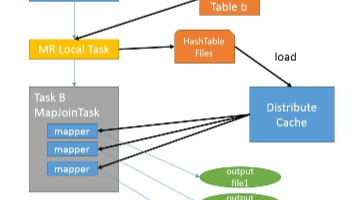
摘要:本文对比了Hive中三种Join方式的应用场景和原理。Map Join适用于小表(默认<25M)关联大表,通过将小表加载到内存HashTable实现高效查询,优化后从72分钟降至7分钟。Reduce Join包含map、shuffle、reduce三阶段,适合大表间关联但性能消耗较大。SMB Join则针对预先排序分桶的大表,能避免shuffle直接完成关联。文中用SQL示例和原理图说
现代数据仓库的复杂性和规模正以前所未有的速度增长,这主要是由于数据量、种类和产生速度的急剧增加所致。传统的数据仓库技术在应对这些现代数据需求方面显得力不从心,这催生了对更先进解决方案的需求。数据工程师在手动优化存储和计算过程(例如在MapReduce中)时面临诸多挑战3。这一过程不仅需要专业的知识,而且非常耗时,可能会阻碍创新。人工智能(AI)和机器学习(ML)的出现为自动化和增强这些优化过程提供
XTuner是由上海人工智能实验室开发的大语言模型微调工具库,具有轻量易用、配置驱动、高效灵活等特点。它支持多种微调算法(如LoRA、QLoRA)和主流大模型,通过简单的命令行操作和配置文件即可完成微调流程。XTuner集成FlashAttention等优化技术,与LMDeploy、OpenCompass形成完整解决方案。用户可通过内置配置快速上手,如使用QLoRA微调InternLM2-1.8B
尝试体验了下,非常丝滑,在功能基本完善之后,还可以上传至自己的github仓库,实现版本管控,如果后续丰富功能,可以继续与它互动,生成的新版本,继续保存上传即可。最近学习Flink,为了快速掌握它,使用了Google AI Studio的build创建了一个APP,用于测试Flink的掌握程度。我的流程是这样的,使用Gemini 2.5 Pro帮我生成提示词。

构建统一、规范、可共享的全域数据体系,避免数据的冗余和重复建设,规避数据烟囱和不一致性,充分发挥阿里巴巴在大数据海量、多样性方面的独特优势核心 :从业务架构设计到模型设计,从数据研发到数据服务,做到数据可管理 、可追溯、可规避重复建设定位: 建设统一的、规范化的数据接入层(ODS)和数据中间层(DWD和DWS),通过数据服务和数据产品,完成服务于阿里巴巴的大数据体系建设,即数据公共程建设。
OneData是数据整合及管理的方法体系和工具,在这一体系下,构建统一、规范、可共享的全域数据体系,避免数据的冗余和重复建设,规避数据烟囱和不执行,充分发挥阿里巴巴在大数据海量、多样性的独特优势。从计算频率角度:数仓分为离线数仓和实时数仓从数据加工链路角度:ODS\DWD\DWS\ADS元数据模型整合及应用: 数据源元数据、数据仓库元数据、数据链路元数据、工具类元数据、数据质量类元数据等 元数据应

消费场景知晓数据加工过程卡点校验风险点监控质量平衡[[《大数据之路1》笔记1:总述和数据技术篇]][[《大数据之路1》笔记2:数据模型]]

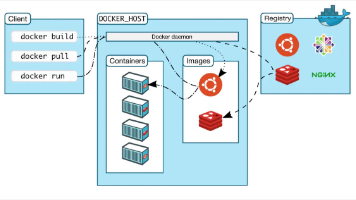
数据卷是一个虚拟目录,是容器内目录和宿主机目录之间映射的桥梁。卷是虚拟的,但是对应的宿主机的目录是真实的,容器的目录跟数据卷之间挂载,这样桥梁就搭建起来了,实现宿主机和容器目录之间的双向绑定,容器内的目录更改,宿主机的目录也会更改,宿主机上有非常高级的编辑器,所以在宿主机上进行更改就方便多了镜像就是包含了应用程序、程序运行的系统函数库、运行配置等文件的文件包。构建镜像的过程其实就是把上述文件打包的
Spark与Pandas在数据类型系统上存在本质差异,导致使用applyInPandas方法时容易出现类型冲突问题。核心矛盾在于Spark的强类型系统与Pandas的灵活类型系统之间的转换,而Arrow作为中间桥梁会严格校验类型。常见冲突包括时间戳、字符串和空值处理等。解决方案应从数据修正、显式类型声明和配置调整三方面入手,建议优先使用Spark原生算子处理数据。版本一致性检查和分批次处理也是避免
Spark与Pandas在数据类型系统上存在本质差异,导致使用applyInPandas方法时容易出现类型冲突问题。核心矛盾在于Spark的强类型系统与Pandas的灵活类型系统之间的转换,而Arrow作为中间桥梁会严格校验类型。常见冲突包括时间戳、字符串和空值处理等。解决方案应从数据修正、显式类型声明和配置调整三方面入手,建议优先使用Spark原生算子处理数据。版本一致性检查和分批次处理也是避免