- @m0_55834564


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
6.hadoop02,hadoop03重复3-5的步骤配置就可以。1.上传hadoop-2.7.3.tar.gz到指定位置。2.hadoop02,hadoop03重复步骤配置就可以。在这里hadoop-2.7.3.tar.gz,官网下载。3.创建配置CentOS-DVD.repo。1. 配置mapred-site.xml。4.配置mapred-site.xml。在esc状态下:set nu显示行号

【代码】基于Python的北京天气数据可视化分析。

一、行转列1.函数说明concatCONCAT(string A/col, string B/col…):返回输入字符串连接后的结果,支持任意个输入字符串;concat_wsCONCAT_WS(separator, str1, str2,...):它是一个特殊形式的 CONCAT()。第一个参数剩余参数间的分隔符。分隔符可以是与剩余参数一样的字符串。如果分隔符是 NULL,返回值也将为 NULL。
1.什么是分桶表?创建分桶表: 把一个大文件拆分小文件来处理分桶表是对列值取哈希值的方式,将不同数据放到不同文件中存储。对于 hive 中每一个表、分区都可以进一步进行分桶。2.创建数据[root@hadoop dool]# vim data.txt #创建文本#导入数据1,zhang,122,lisi,343,wange,234,zhouyu,155,guoji,566,xiafen,487,y
hiveserver2启动不了端口号被占用,lsof -i:10000查看端口号占用情况,kill -9 10000杀掉端口号重新启动hiveserver2;问题:[root@hadoop ~]# hiveserver2which: no hbase in (/usr/local/sbin:/usr/local/bin:/sbin:/bin:/usr/sbin:/usr/bin:/usr/soft
传统的互联网与商业数据的存储和处理主要使用关系型数据库技术,数据库企业巨头 Oracle 是这一时期的代表企业。随着大数据时代的到米,传统关系数据库在可扩展性方面的缺陷遂渐暴露出来,即使采用并行数据库集样,最多也只能管理百台左右的机器.而且这种并行数据库要求高配置的服务器才可正常运转,其管理海量数据成本之高可以想象。对于很多应用场景,尤其是互联网相关应用,并不像银行业务等对数据的一致性有很高的要求

解决方案:http://t.csdn.cn/yBu9Z输入命令service iptables stop,就可以访问了就能打开端口连接不上mysql也用这个方法
本文详细介绍在 Ubuntu 22.04 LTS 系统上从零开始安装、配置、部署 OpenClaw AI 助手框架的完整流程,包含环境准备、安装步骤、服务配置、故障排查等内容。
本文详细介绍在 Ubuntu 22.04 LTS 系统上从零开始安装、配置、部署 OpenClaw AI 助手框架的完整流程,包含环境准备、安装步骤、服务配置、故障排查等内容。
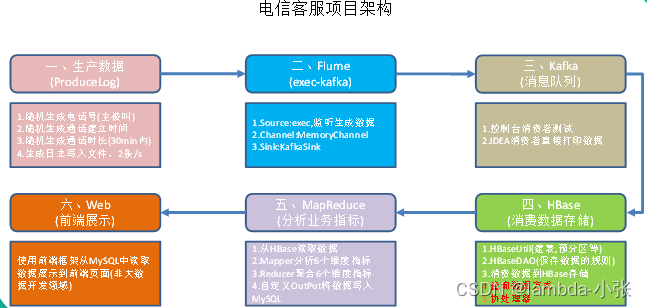
数据量如此巨大,除了要满足用户的实时查询和展示之外,还需要定时定期的对已有数据进行离线的分析处理。例如,当日话单,月度话单,季度话单,年度话单,通话详情,通话记录等等+。此情此景,对于该模块的业务,即数据生产过程,一般并不会让你来进行操作,数据生产是一套完整且严密的体系,这样可以保证数据的鲁棒性。但是如果涉及到项目的一体化方案的设计(数据的产生、存储、分析、展示),则必须清楚每一个环节是如何处理的