


- @m0_45101613


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
运维不只是命令堆砌,而是系统认知与自动化落地的结合;脚本是工具,思维才是核心;容器与云,是新一代运维的必修课;从执行者转型为“保障者”与“服务者”;最终目标是让系统“稳定、高效、可持续”运行。
知识蒸馏是 Hinton 教授等人在 2015 年提出的模型压缩技术,其核心思想是:用一个大型、性能优秀的“教师模型”(Teacher)去指导一个小型“学生模型”(Student)学习,从而使学生模型在保持小体积的同时,获得与教师相当的性能。这种思想就像我们在学校的学习过程:教师不仅传授“标准答案”,更传授“做题思路”、“知识体系”;学生通过模仿教师的“理解方式”而不仅仅是死记硬背,才能成长为一个
传统的监督学习中,标签是 one-hot 编码的,只有一个维度为 1,其余为 0。例如:真实类别是猫(第3类):label = [0, 0, 1, 0, 0]但这并没有告诉模型其它类别之间的“相似度关系”。
小规模数据可用mysqldump迁移,大数据建议用XtraBackup;分库分表需考虑分片键、路由策略与查询代价;分区表可解决部分大表场景,但不适用于高频跨分区操作;多表多库方案建议配合中间件,简化业务改造。
8.解耦知识蒸馏的训练过程,先训练教师网络,保存教师网络权重,再训练学生网络,loss=0.5*hard_loss+0.5*soft_loss表明在训练学生网络的过程中同时进行了交叉熵损失与KL散度损失。在解耦知识蒸馏中超参数较多,需要手动测试合适的超参数。7.学生网络训练函数,在知识蒸馏中学生网络同样要经过交叉熵损失训练,是占一定比例的训练。4.定义蒸馏损失,本文采用解耦知识蒸馏的方法实现知识蒸
本篇你掌握了:数据库中间件高可用架构的设计思路多节点部署、服务注册与健康检查机制容灾机制应对不同异常场景跨机房/跨云部署的灾备架构方案实际部署中的工程实践建议与注意事项。
主从复制是 MySQL 高可用架构的核心;异步复制适合读多写少的业务场景;多从库可构建读写分离集群,提升性能;配合中间件与监控系统可实现自动化运维。
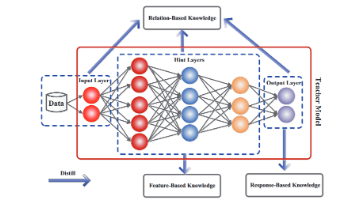
相较于上一篇介绍的 Soft Target(输出蒸馏),Feature-based 蒸馏强调的是:让学生模型模仿教师模型中间层的特征表示。这就好比学生不仅要学会“答对题”(预测分类),还要“思考方式一样”(中间表示一致)。✅ Step 2:定义 AT 损失函数✅ Step 3:提取中间特征(hook 方式)# Hook 中间层✅ Step 4:训练流程五、特征蒸馏技巧汇总项建议蒸馏层选择可选 sh
3.打开打印选项,选择福昕打印机,打开打印机属性,选择高质量,分辨率选最大。经过以上操作回到打印界面直接选择打印。下面给出一个简单的方法来解决这一问题。2.在选项中选择高级进行如图的勾选。这一方法导致论文中的图片被压缩。最近在写论文时发现直接使用。1.打开文件找到选项。
这是一种基于马尔可夫链的扩散模型,由 Ho 等人在 2020 年提出,是扩散模型领域的奠基性工作。它的结构:使用固定的噪声计划 β_1,β_2,...,β_T通过一系列高斯加噪的方式构造正向过程通过神经网络拟合逆向过程中的去噪操作DDPM 提出了一个令人惊讶的发现:👉只要神经网络学会预测加到图片上的“噪声”,就能一步步地生成高质量图像!扩散模型是基于“逐步加噪/去噪”的生成模型DDPM是最经典的