- @hjs314159


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在双栏排版场景下,为实现图片/表格跨栏展示并保证信息清晰可读,可通过WPS高效完成:选中目标图片/表格及其图名/换行符后,在菜单栏切换为“一栏”模式,系统将自动插入分节符并保持前后内容格式稳定,避免传统Word操作中复杂的分节符手动调整问题。该方法无需代码或复杂设置,既能突破双栏尺寸限制实现跨栏展示,又能确保文档修改过程中跨栏元素的格式独立性,显著提升学术图表在双栏模板中的排版效率与视觉效果。
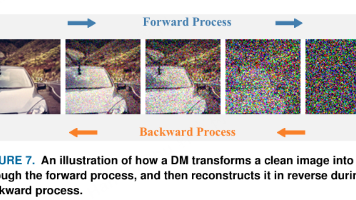
本节概述了扩散模型(DMs),解释了其基础的生成过程并追溯了其概念演变。由于其生成特性,扩散模型在合成新的场景方面表现出色,而非分析现有场景。因此,我们回顾了它们在自动驾驶(AD)场景生成中的应用,包括交通流合成、道路布局设计、图像生成和视频生成。在本节中,我们还重点讨论它们生成驾驶场景的能力,并将近期的工作分类为视觉生成、三维占用生成和多模态生成。此外,我们还讨论了相关的架构创新和基准测试。
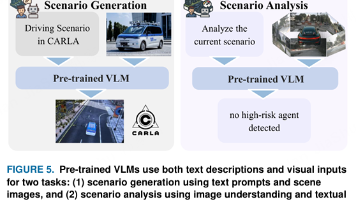
本节介绍了视觉语言模型(VLMs),总结了其关键的适应技术,并回顾了基于VLMs的情景生成在安全关键、真实世界以及高级驾驶辅助系统(ADAS)测试应用和图像数据集生成中的应用。此外,还探讨了VLMs如何支持情景分析任务,如视觉问答(VQAs)、场景理解、基准测试和风险评估。
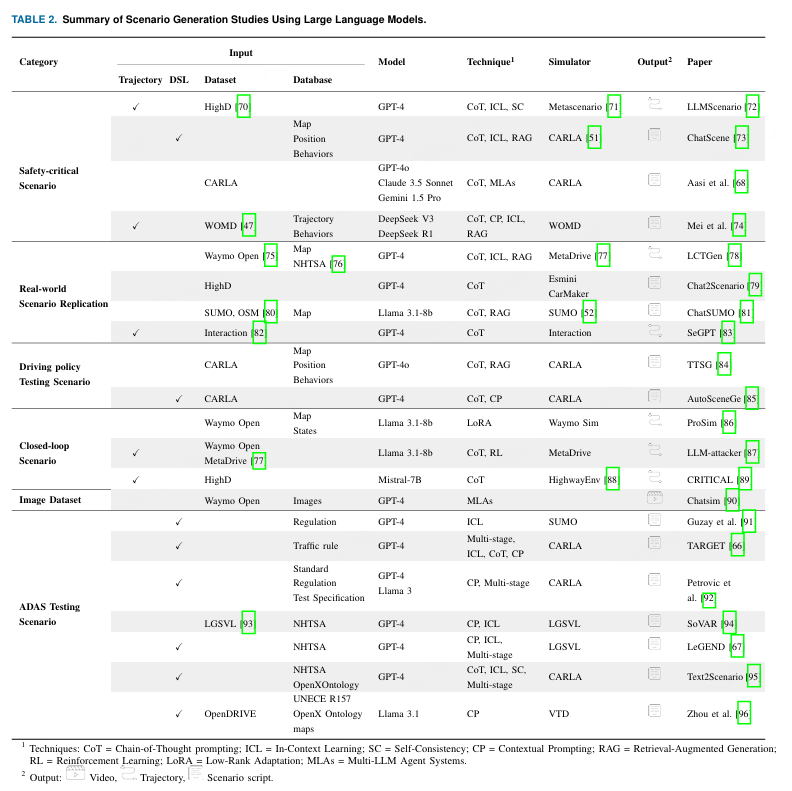
本节介绍了大语言模型(LLM)的基础和发展历程,展示了关键技术进展,并报告了常用的适配技术(例如提示工程和微调策略)。随后,我们探讨了大语言模型如何支持场景生成、安全关键案例、真实场景合成、驾驶策略评估、闭环仿真以及高级驾驶辅助系统(ADAS)测试。本节最后以场景分析的讨论作为总结,包括问答、场景理解和场景评估。
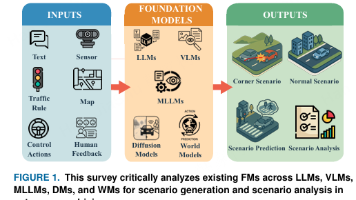
本文综述了基础模型(FMs)在自动驾驶场景生成与分析中的应用现状。随着自动驾驶技术发展,基于场景的仿真测试对系统验证至关重要,而传统方法在多样性和真实性上存在局限。近年来,以大型语言模型(LLMs)、视觉语言模型(VLMs)、多模态大语言模型(MLLMs)、扩散模型(DMs)和世界模型(WMs)为代表的基础模型,为提升场景生成质量提供了新途径。本文系统梳理了各类模型的原理、应用及评估指标,并整合相
本文综述了机器学习兴起前主流的图像特征提取方法,包括SIFT、SURF、ORB等7种算法。SIFT具有尺度不变性但计算量大;SURF在保持性能的同时提升了速度;ORB结合FAST和BRIEF实现快速检测;HOG适用于静态物体检测。这些传统方法通过不同技术手段提取图像关键点和描述符,在旋转、尺度、光照变化等方面各具优势,为计算机视觉发展奠定了基础。随着技术进步,这些方法在实时性、精度等方面不断优化,
近年来,自动驾驶技术在全球范围内迅速发展,为日益严重的交通拥堵和道路安全相关挑战提供了有效解决方案。在各种范式中,端到端自动驾驶由于其简化的架构、增强的决策一致性以及出色的泛化能力,已经成为传统模块化系统的一个有前景的替代方案。本综述全面回顾了端到端自动驾驶的发展历程和核心技术,强调了模仿学习(IL)、强化学习(RL)等范式的应用与发展。此外,本文还重点介绍了由基础模型赋能的新兴范式,例如大型语言
CBAM(Convolutional Block Attention Module)是一种旨在提升卷积神经网络(CNN)性能的注意力机制模块。通过引入通道注意力(CAM)和空间注意力(SAM)机制,CBAM能够有效地提升模型的特征表达能力,专注于重要的通道特征和空间位置特征。其设计不仅轻量级且计算效率高,能在不增加模型复杂度的情况下显著改善性能。CBAM的即插即用特性使得它能够方便地集成到现有网络

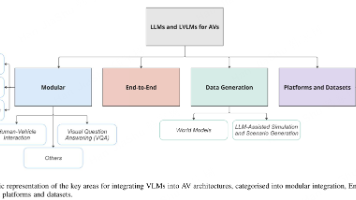
本文综述了大型(视觉)语言模型(LLMs/VLMs)在自动驾驶(AV)领域的应用现状与发展趋势。文章系统分析了截至2025年9月的77篇文献,重点探讨了VLMs在模块化集成、端到端系统、数据生成三大方向的应用,并介绍了相关评估平台与数据集。研究表明,VLMs显著提升了AV的感知推理、决策规划和人机交互能力,但其实际部署仍面临计算效率、实时处理、模型幻觉等挑战。文章指出未来需重点解决延迟优化、安全验
其实这块就叫做YOLOv1的全连接层。其实YOLOv1的网络结构是借鉴了GoogleNet的,输入图像的尺寸为448×448,经过24个卷积层,2个全连接的层(FC),最后在reshape操作,输出的特征图大小为7×7×30。(4)综上所述,因此每个grid cell输出的数据维度为30×1,而7×7个方格输出的维度即为7×7×30。全连接层之前,特征已经被打乱了,原来好好的照片被叠成了一个砖块,