- @higerwy


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文介绍了一个基于LangChain、Milvus和Qwen3构建的医疗AI问答系统。系统采用多层检索架构:通过多向量检索扩展语义覆盖,结合BM25和向量检索的混合策略,并引入重排序优化结果。同时实现了Qwen3大模型的本地化部署与API混合架构,兼顾隐私保护与推理能力。该系统能有效解决医疗领域专业术语匹配、语义鸿沟等挑战,适用于智能导诊、用药咨询等场景,在测试中展现出90%以上的Top-3命中率
本文系统讲解ONNX作为深度学习模型部署“通用语”的核心价值,针对训练与生产环境脱节的痛点,详述PyTorch/TensorFlow到ONNX的全流程转换方法,涵盖opset选择、动态维度处理、算子兼容性、数值对齐验证等关键环节,并提供YOLO、LLM等场景实战案例。结合ONNX Runtime性能调优、INT8量化、模型瘦身及跨平台部署(TensorRT/OpenVINO/Core ML/ORT

【代码】彩色图像转化灰度图像(python/matlab)

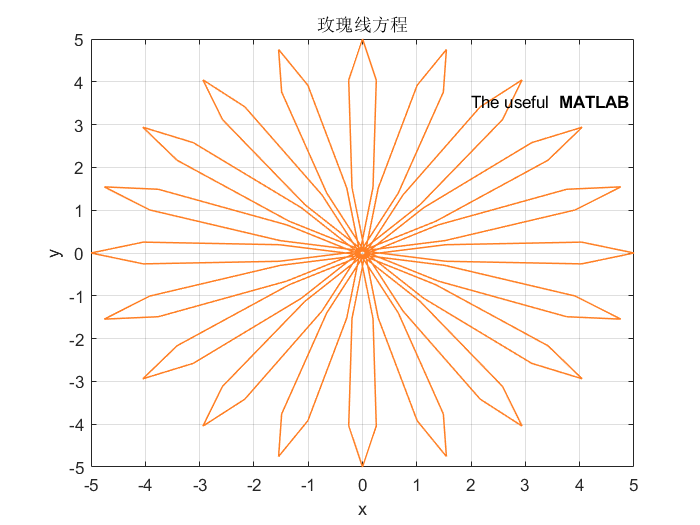
matlab实现高斯列主元消去法,编写了两个函数文件,都能实现相同的功能。
编写一个名为collatz()的函数,设置一个整型参数num。如果参数是偶数,那么collatz()就输出并返回num// 2;如果num是奇数,collatz()就输出并返回3 * number + 1。然后编写程序,让用户输入一个正整数,并不断对这个数调用collatz(),直到函数返回值1
本文介绍了如何利用微软提出的BEiT-base模型在CIFAR-100数据集上实现高精度图像分类。BEiT采用掩码图像建模(MIM)预训练策略,通过12层Transformer编码器提取视觉特征。针对CIFAR-100的32×32小图像特点,设计了包括上采样、强数据增强等预处理策略,并采用分层学习率优化(5e-5/1e-3)和标签平滑技术。实验在NVIDIA A10 GPU上训练10个epoch,
Docker技术2025年全景解析:本文系统梳理了Docker容器技术的现代实践,涵盖架构原理、构建优化、安全防护和生产部署等关键领域。重点包括:1)轻量级容器架构解析(Namespaces/Cgroups/UnionFS);2)多阶段构建与BuildKit应用(镜像体积缩减87.5%);3)全生命周期安全方案(Rootless模式/SBOM/运行时加固);4)生产级Compose配置与Kuber
阿里巴巴通义千问团队推出的Qwen3-0.6B和Qwen3.5-0.8B两款轻量级模型展现出显著代际差异。Qwen3.5-0.8B不仅参数量增加0.2B,更实现了架构革新:从纯文本模型升级为原生多模态模型,支持262K超长上下文和视觉处理能力。其采用混合注意力机制(3层线性+1层全注意力交替)降低计算复杂度,引入MRoPE三维位置编码支持多模态输入,并内置视觉编码器处理图像/视频数据。这些改进使Q
本文系统梳理了大模型三大核心技术:Transformer计算优化、位置编码演进和人类偏好对齐。在计算优化方面,分析了Self-Attention与FFN的复杂度瓶颈,介绍了Flash Attention的硬件感知优化、MQA/GQA架构及MoE技术;位置编码部分重点解析了RoPE旋转编码的数学原理及其外推技术(NTK/YaRN);最后对比了PPO和DPO两种对齐方法,指出DPO通过隐式奖励建模实现

本文提出了一种基于CNN-LSTM-MHA混合模型和灰狼优化算法(GWO)的时序预测方法。该模型通过1D-CNN提取局部特征,双向LSTM建模长期依赖,多头注意力机制聚焦关键时间步,实现了时序数据的多层次建模。创新性地引入GWO算法自动优化超参数,解决了传统调参效率低的问题。实验表明,该方法在保持较高预测精度的同时,显著提升了训练效率。全文提供了完整的PyTorch实现代码,包含混合精度训练、Cu