


- @Z_oioihoii


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
对大多数小微企业来说,这个够用,也够划算,省下来的工期是实打实的。大模型的水平面一点点升高,站在水底、礁石还是山上,早晚得选。11 月 2 日,一个在字节做 Coze 的人发了条动态,说自己的主页还挂着「Coze Workflow 引擎开发者」,估计明年再挂这玩意,就没人知道 Coze 是啥了。第二条最扎人:当年拼命做的拖拽节点,其实是在替模型的笨买单,说到底是从低代码延续出来的过渡模式,一个中间
先说名字,免得吓着人。Super-agent 不是"超级智能体"。这里的 super 是英语里"在上面"的意思,跟 sub(在下面)对着来的。你熟悉的 subagent 是在主 Agent 底下挂小弟,super-agent 反过来,是在干活的 Agent加一层,让上面那层管下面那层。跟超级智能没关系,就是个方位词。
模型能用,和模型好不好用,是两回事。命令行当然能完成拉取模型、启动模型和对话,但当本地模型开始变多,或者还想同时接入局域网里的大模型、云端 API,再继续靠命令行切来切去,使用体验很容易变得割裂。真正日常使用时,我更希望有一个统一入口:能看见有哪些模型、直接切换、保留聊天记录,还能继续扩展知识库和工具能力。OpenWebUI 适合解决的就是这类问题。

链表是,但与数组有本质区别。数组是连续的内存空间,支持随机访问;链表则是,只支持顺序访问。理解链表的核心在于掌握和。
中序遍历(Inorder Traversal)是二叉树遍历的一种经典方式,其遍历顺序遵循“左子树 → 根节点 → 右子树”的原则。A/ \B C/ \ \D E F// 二叉树节点结构int val;递归实现:直观易懂,适合快速实现和教学非递归实现:更高效,避免递归深度限制,是面试常考点理解两种实现方式不仅有助于掌握二叉树遍历,还能加深对递归和栈的理解,为学习更复杂的树形结构算法打下坚实基础。
数据库监控体系日趋完善,CPU 升高、I/O 波动、会话堆积、慢 SQL 等异常已能被快速发现。但真正的挑战在于异常出现后的根因定位——一次性能问题可能同时涉及服务器资源、SQL 执行、锁等待、长事务、索引等多个因素,DBA 需要在不同页面间反复切换、凭经验拼接线索。KEMCC 构建了覆盖性能、锁、根因、SQL、存储、索引及 SQL 统计的完整诊断框架,核心是将分散的诊断信息关联成一条可连续下钻的
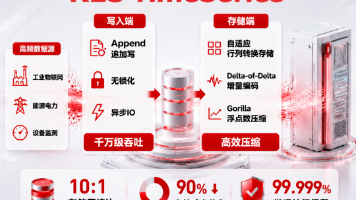
这使得时序数据(状态变化)、关系数据(业务属性)、GIS数据(空间位置)和向量数据(专业知识)能够围绕同一个业务对象(如一台设备)直接建立关联,为上层应用提供完整的数据上下文。一个简单的设备异常判断,AI需要的不仅是当下的读数,更需要理解设备过去的状态变化、关联设备的同步信息,甚至要结合维修记录和故障知识库。传统做法是,为不同类型数据引入多套专业系统,但这带来了数据同步复杂、接口开发繁琐、运维成本
C++20 的日历功能提供了类型安全的日期操作接口,包括基本的日期单位(如年、月、日)以及更复杂的日期表达方式。库在 C++11 的基础上进行了重大扩展,引入了日历和时区功能,极大地增强了对日期和时间的处理能力。(由 C++ 标准库的维护者 Howard Hinnant 编写),它提供了类似的功能。库为日期和时间的处理提供了强大的支持,结合日历和时区功能,可以满足大多数开发需求。C++20 的时区

8 月 26 日 GatesNotes 长文读后。最有价值的不是他的判断,是他给的那三条政策主张。盖茨这篇文章的标题很盖茨——《动荡的 AI 时代已经到来。我们现在所做的选择至关重要》。说实话,这类标题我这两年已经免疫了。“转折点”“分水岭”“历史性时刻”,翻来覆去说的都是同一套:AI 很厉害、风险很大、我们要负责任地发展。读完全文等于没读。但这篇我读完了,还做了笔记。
本文不会像教科书一样罗列Lambda的语法,而是带你重走一遍每个C++程序员认识Lambda的经典“真香”之路。从最初的反感,到偶然一试的惊喜,最终成为日常开发离不开的神器。要么定义一堆小函数,要么继承重写虚函数…要么用全局变量(丑陋),要么定义函数对象类(繁琐)。完蛋,得用函数对象,更复杂了!快来加入Lambda的"真香"阵营吧!真正的"真香"时刻,是当我发现Lambda能。就在我几乎要放弃的时