


- @Z4400840


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
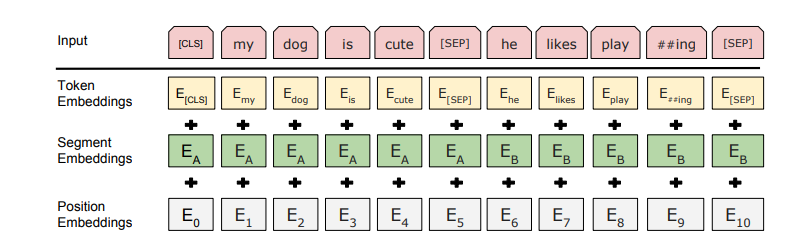
BERT(Bidirectional Encoder Representations from Transformers)自 2018 年由谷歌提出以来,便在自然语言处理(NLP)领域掀起了一场革命。它凭借独特的架构与训练方式,成为了众多 NLP 任务的首选模型,深刻改变了我们理解和应用语言的方式。unsetunset一、BERT 重要意义
什么是向量数据库?• 用于存储、索引、查询和检索高维向量数据。• 特别适合处理非结构化数据(如图像、音频、文本)。• 实现传统数据库难以完成的高级分析和相似性搜索。传统数据库的局限性• 无法理解非结构化数据的意义。• 无法有效搜索或分类复杂的文档、音频和图像数据。向量数据库的核心特性•• 数据以向量形式存储,捕捉语义和上下文。• 每个向量由ID(唯一标识)、维度(数值表示)、有效负载(元数据)组成

Ollama 是一个基于 Go 语言的开源框架,支持在本地运行大语言模型。文章介绍了 Ollama 的安装方法(支持 macOS 等系统),并详细说明了如何下载和使用大模型,如 gemma:2b 等。安装后可直接在终端与模型对话,还展示了/help、/show等交互命令的使用方式,适合开发者快速上手本地大模型部署与应用。
Ollama 是一个基于 Go 语言的开源框架,支持在本地运行大语言模型。文章介绍了 Ollama 的安装方法(支持 macOS 等系统),并详细说明了如何下载和使用大模型,如 gemma:2b 等。安装后可直接在终端与模型对话,还展示了/help、/show等交互命令的使用方式,适合开发者快速上手本地大模型部署与应用。
RAG实战:如何让大模型读懂表格数据 大多数开发者以为RAG只需调个API就能搞定,直到面对Excel表格时才意识到真正的挑战——表格数据处理才是RAG的终极考验。本文深入剖析表格数据处理的完整流程,提供可落地的解决方案。 核心方法 表格向量化三步骤 逐行向量化:将每行转为文本描述后生成向量,适合单行查询 逐列向量化:单独处理每列数据,支持字段筛选 整表嵌入:将整个表格转为文本整体处理,适合全局查
随着人工智能技术的飞速发展,大模型在自然语言处理等领域展现出了强大的能力。用户通过输入特定的 Prompt 与大模型进行交互,以获取所需的信息和帮助。然而,Prompt 的质量和方式会显著影响大模型的输出结果。因此,研究和掌握有效的 Prompt 技巧具有重要的现实意义。有一种观点认为,在与大模型对话时,Prompt 越礼貌越容易出好结果。这可能是因为从理论上来说,人们在网上提出更礼貌的问题,往往

生成对抗网络(GAN)是一种无监督的生成模型,由两个神经网络组成:一个生成器和一个判别器。生成器试图制造与真实数据无法区分的新数据(伪造数据),而判别器则试图区分真实数据和伪造数据。下图8展示了GAN的原理架构(也称为普通GAN)。生成器网络以噪声作为输入并生成伪造数据。判别器网络以真实数据和伪造数据作为输入,并使用Sigmoid激活函数和二元交叉熵损失将它们分类为真实或伪造。由于生成器没有直接访
本文主要介绍了向量数据库的原理和实现,包括向量数据库的基本概念、相似性搜索算法、相似性测量算法、过滤算法和向量数据库的选型等等。向量数据库是崭新的领域,目前大部分向量数据库公司的估值乘着 AI 和 GPT 的东风从而飞速的增长,但是在实际的业务场景中,目前向量数据库的应用场景还比较少,抛开浮躁的外衣,向量数据库的应用场景还需要开发者们和业务专家们去挖掘。读者福利:如果大家对大模型感兴趣,这套大模型

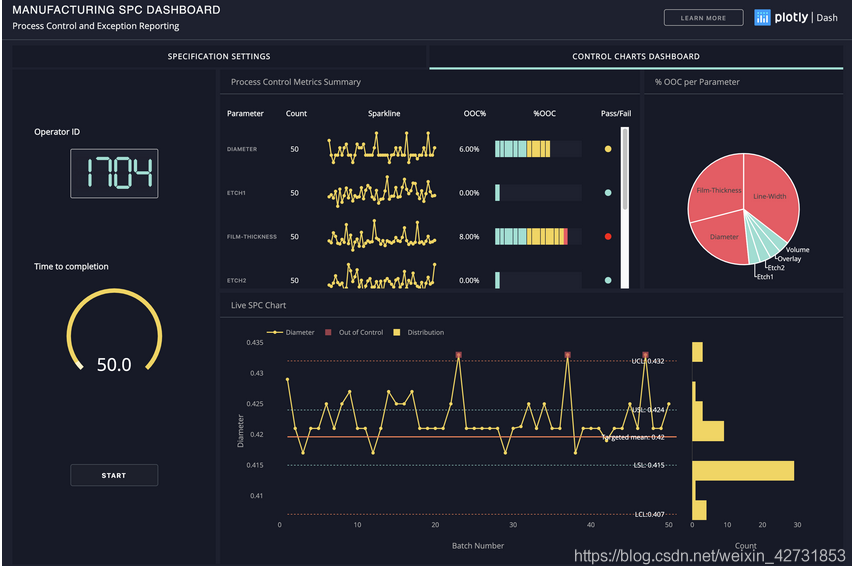
为什么很多人喜欢Python?对于初学者来说,这是一种简单易学的编程语言,另一个原因:大量开箱即用的第三方库,正是23万个由用户提供的软件包使得Python真正强大和流行。在本文中,我挑选了15个最有用的软件包,介绍它们的功能和特点。Dash是比较新的软件包,它是用纯Python构建数据可视化app的理想选择,因此特别适合处理数据的任何人。Dash是Flask,Plotly.js和React.js
学习如何使用Pandas和SQL高效地从数据库中读取、处理和写入大型数据集,以实现最佳性能和内存管理。处理大型数据集往往是一项挑战,特别是在涉及到从数据库读取和写入数据时。将整个数据集加载到内存中的传统方法可能会导致系统崩溃和处理时间缓慢。。这种技术使我们能够高效地处理大量数据,对于任何与数据库和数据帧一起工作的人来说都是一种宝贵的工具。我们将重点使用流行的数据分析库Pandas来演示如何从数据库
