- @DuLNode


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
刚在Jetson nano上面配置好了tensorflow,盘点一下我个人遇到的一些坑点,希望能够帮助大家少走弯路
LangChain 1.0重构结构化输出,以with_structured_output统一API,支持Tool与Provider双策略,联动Pydantic强校验,实现字段约束、非法数据自动修正及嵌套复杂结构解析,适配多模型与生产环境。
在大模型技术栈中,微调(Fine - tuning)是使预训练大模型适配特定领域任务的核心手段,而微调数据集作为模型训练的“燃料”,其构建的科学性与工程化程度直接决定微调效果上限。本文从流程、规模、工业实现、强化学习适配等维度,系统解析大模型微调数据集的构建技术。

在大语言模型(LLM)驱动的应用场景中,检索增强生成(RAG)技术愈发关键。而文本分割,作为RAG流程里的核心环节,直接影响着整个系统的性能与效果。接下来,我们将从文本分割的重要性、在RAG中的位置、不同分割方法以及实践建议等方面,进行全面且深入的剖析。

在人工智能技术飞速发展的当下,通用大模型无疑是最受关注的领域之一。它凭借强大的能力打破了传统 AI 模型的局限,为各行业的智能化升级提供了全新可能。本文将从通用大模型的定义出发,深入剖析其核心特点,并详细梳理常见的分类方式,带大家全面认识这一前沿技术。
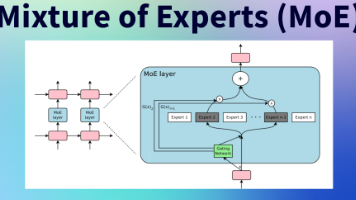
在人工智能大模型飞速发展的今天,Transformer 架构无疑是撑起整个领域的 “基石”,而 MoE(Mixture of Experts)架构则凭借其独特的 “稀疏激活” 思路,成为突破大模型参数规模与计算效率瓶颈的 “关键引擎”。无论是 ChatGPT 背后的技术支撑,还是自动驾驶中的多模态感知,这两种架构都扮演着不可或缺的角色。本文将从核心原理、大模型设计逻辑和关键差异三个维度,带大家全面
在人工智能模型的开发流程中,微调是让预训练模型适配特定任务、提升性能的关键环节。而在微调的启动方式上,“冷启动” 和 “热启动” 是两个高频出现但容易混淆的概念。很多刚接触模型微调的开发者,常会疑惑二者的核心区别的适用场景。今天这篇博客,就用通俗易懂的语言拆解这两个概念,结合实际微调案例,帮你搞懂什么时候该用冷启动,什么时候该选热启动。
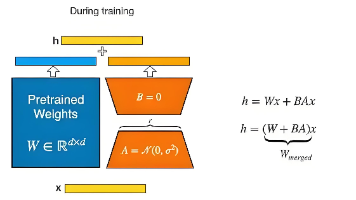
在大模型落地实践中,微调(Fine-tuning)是连接通用预训练能力与特定任务需求的关键环节。通过微调,我们能让在海量数据上预训练的模型 “适配” 具体业务场景,比如客服对话、代码生成、医学文献分析等。本文将系统梳理六种主流微调方式,从核心原理、参数调整逻辑到适用场景,帮你快速掌握不同方案的选型思路。
不同系列的显卡,适合的人群和做的事不一样,看下面的表就清楚啦

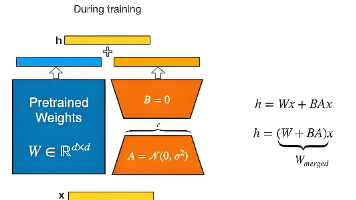
大型语言模型(LLM)参数规模极大,全参数微调存在诸多难题:- **成本高昂**:需存储和更新所有模型参数副本,训练开销大。- **部署困难**:每个任务都要存储完整模型副本,占用大量存储空间。- **资源需求高**:对计算资源和GPU内存要求严苛,普通设备难以支撑。