- @DBAxiaoye


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
外挂向量库解决了“相似度匹配”,但没有解决“业务口径”。大模型拿到相似的文档,不知道“有效订单”排除了测试单,不知道“复购率”按什么口径算,回答照样出错。电科金仓KES AI数据库将“库内语义构建”作为三大核心能力之一,把业务定义、指标口径、实体关系沉淀在数据库层,让向量检索的结果在语义层被过滤和重排,而不是只靠相似度排序。本文从语义断层的工程根因出发,拆解库内语义构建与库外拼装方案的路径差异。

搞RAG,为了喂大模型,我们被迫在业务库外硬挂向量数据库,导致数据流转慢、一致性难保证、内存开销巨大。本文深度拆解电科金仓刚发布的AI数据库,从“数据不出库”的底层机制出发,探讨原生融合架构如何干掉外挂链路,以及降内存、低延迟背后的真实技术考量。
本文分析了时序数据库选型的核心问题,指出写入、压缩和查询构成"不可能三角",需根据业务需求权衡取舍。文章比较了InfluxDB(写入优先)、TimescaleDB(平衡型)、Prometheus(短期监控)、金仓时序数据库(多模融合)和Amazon Timestream(云原生)等产品的特性差异,从写入吞吐、压缩比和查询能力三方面评估性能表现,并针对不同应用场景给出选型建议,强调应根据业务痛点、数

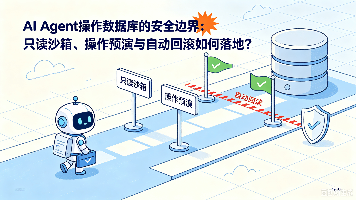
当AI Agent从“只读查询”走向“自主变更”,数据库的安全模型需要重新设计。人类DBA执行DELETE前会反复确认,Agent可能因为一个理解偏差直接执行。本文拆解Agent操作数据库的三层安全机制——只读沙箱隔离风险、操作预演预判影响、自动回滚兜底失误,给出可落地的安全框架。
时序数据库是2026年增长最快的数据库细分赛道之一。全球时序数据年复合增长率已突破45%,单一大型能源或制造企业的日均时序数据增量已可突破PB级。面对金仓时序数据库、TDengine、InfluxDB、TimescaleDB、IoTDB等众多选择,选型不能只看QPS数字。本文从架构设计、写入性能、查询能力、压缩效率、生态兼容五个维度,对5款主流时序数据库进行深度对比,帮助读者根据实际业务场景做出合
2026年6月,OceanBase发布湖库一体AI数据库,阿里云PolarDB年初已推出AI数据湖库(Lakebase),Databricks也在6月推出了LTAP架构。“湖库一体”成为2026年数据库圈最热的概念之一。本文从湖库一体的概念定义出发,拆解其技术原理,对比“湖仓一体”与“湖库一体”的差异,分析三大厂商的落地路径,并讨论这一趋势对DBA和架构师的现实意义。

关系数据库产品是企业核心系统的数据底座,全球超过70%的企业核心系统仍由关系型数据库承载。2026年,关系数据库产品市场正经历从“集中式垄断”向“分布式多元”的剧烈重构。本文从关系数据库产品的核心概念出发,梳理国际主流与国产两大阵营的产品格局,并从架构、场景、生态三个维度提供选型框架,帮助读者在复杂的产品版图中找到最适合自己的数据库。

2026年低代码/快速开发平台已从“工具属性”演变为企业数字化的“基础设施”。本文从快速开发平台对数据库的核心诉求出发,分析低代码时代数据库集成面临的三大挑战——异构数据源兼容、动态模型适配、信创环境适配。对比NocoBase、Retool、JeecgBoot等主流平台在数据库集成方面的差异,探讨如何降低信创环境下的应用开发门槛。

2026年上半年,国产数据库市场继续高速增长,AI与大模型的渗透深刻改变了数据库的产品形态和运维模式。本文基于行业报告及厂商动态,总结下半年三大核心趋势:多模数据库成为标配(一套库支持关系、JSON、时序、向量等);云原生数据库加速普及(Serverless、存储计算分离);AI融合从“可选”变为“必选”(内置向量检索、NL2SQL、自动索引推荐)。针对DBA,本文提出了转型建议:从运维操作向数据

上云本应是降本增效,但很多企业上云之后,账单反而越滚越大。实例规格买高了、历史数据堆在SSD上、测试环境没人关、过期快照没清理——每一笔费用都在悄悄累积。本文从云账单的三大“黑洞”出发,拆解云成本失控的根因,给出实例降配、冷热数据分层、僵尸资源清理三条可落地的优化路径,帮助DBA和运维工程师用数据驱动成本优化,让每一分钱都花在刀刃上。