


- @AbnerAI


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这个问题的主要挑战来自产品类别的大规模和细粒度特性,以及由于产品的不断更新,难以收集反映真实结账场景的训练图像。尽管具有重要的实践和研究价值,但这个问题在计算机视觉社区中并没有得到广泛的研究,主要是由于缺乏高质量的数据集。0 个显着对象:338 个图像 1 个显着对象:611 个图像 2 个显着对象:155 个图像 3 个显着对象:100 个图像 4+ 显着对象:20 张图像。缺点:图片为不同的尺
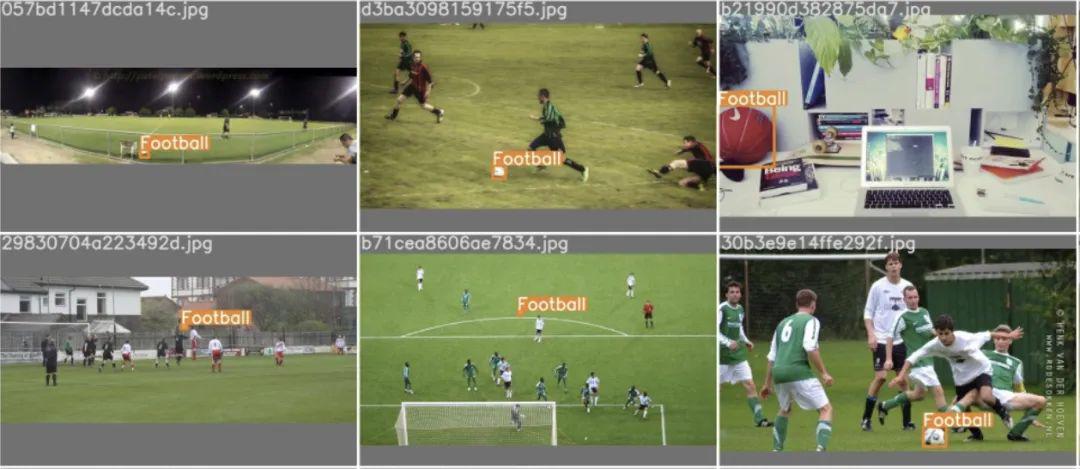
AI - Interview]IEEE Spectrum专访吴恩达(一)小就是新的大Small is the New Big。[AI - Interview]IEEE Spectrum专访吴恩达(二)小就是新的大Small is the New Big。[AI - Interview]IEEE Spectrum专访吴恩达(三)小就是新的大Small is the New Big。1 图像分类(Im
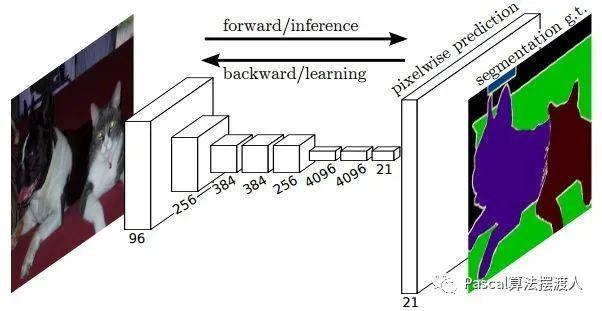
GENKI-R2009a包含11159个图像,GENKI-4K包含4000个图像,分为“笑”和“不笑”两种,每个图片的人脸的尺度大小,姿势,光照变化,头的转动等都不一样,专门用于做笑脸识别。GENKI-SZSL包含3500个图像,这些图像包括广泛的背景,光照条件,地理位置,个人身份和种族等。UCF50 是一个由中佛罗里达大学发布的动作识别数据集,由来自 youtube 的真实视频组成,包含 50
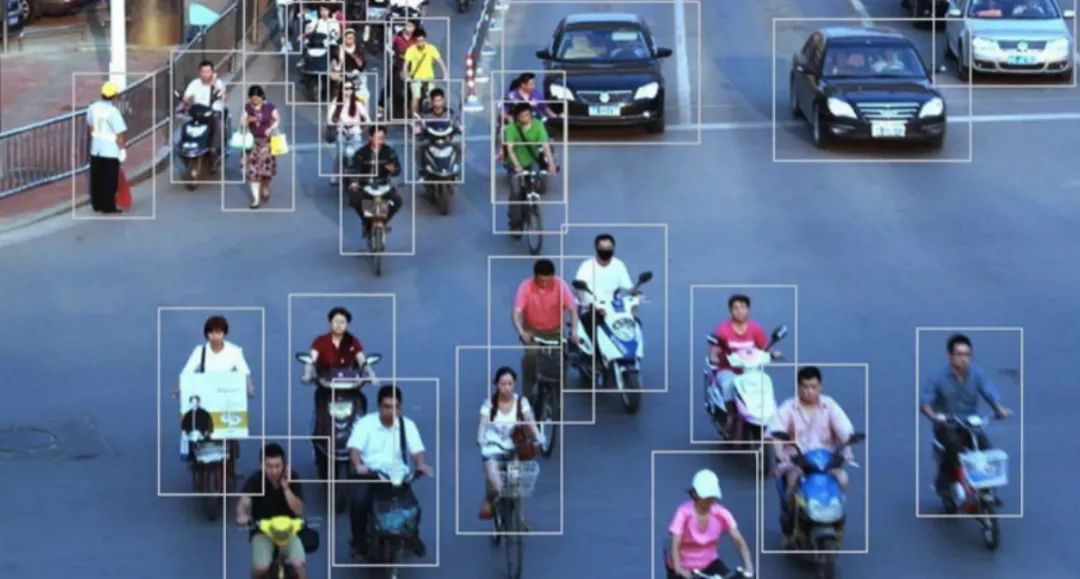
目录如下:导入包以及设置随机种子以类的方式定义超参数定义自己的模型定义早停类(此步骤可以省略)定义自己的数据集Dataset,DataLoader实例化模型,设置loss,优化器等开始训练以及调整lr绘图预测import numpy as npimport torchimport torch.nn as nnimport numpy as npimport pandas as pdfrom tor

数据集下载汇总链接:https://www.cvmart.net/dataSets数据集将会不断更新,欢迎大家持续关注!数据集下载地址:http://m6z.cn/5MjlYkAI-TOD 在 28,036 张航拍图像中包含 8 个类别的 700,621 个对象实例。与现有航拍图像中的目标检测数据集相比,AI-TOD 中目标的平均大小约为 12.8 像素,远小于其他数据集。数据集下载地址:http
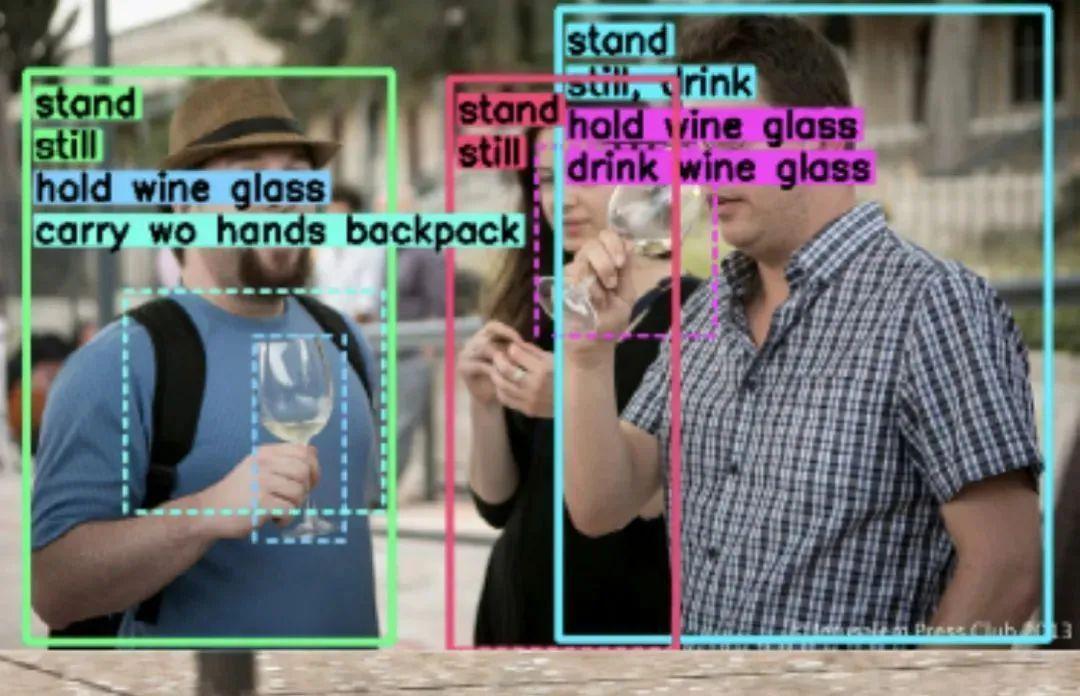
小时候看书,说我们人类面临三个世界,一个是虚拟的意识世界,另一个是现实的物理世界,第三个是真理世界,也就是数学世界。当然,我们可以比较客观地说,计算机视觉是让计算机去创造一种新的物种,像人一样具有可辨识、可观察的能力。所以我认为,在学术界的毕业生需要有一种哲学的思辨能力,而并不仅仅是做一种技术的应用,也并不仅仅是提高一些效率。在学术界,你的论文发表了之后,研究就结束了。但在工业界是不一样的,论文发
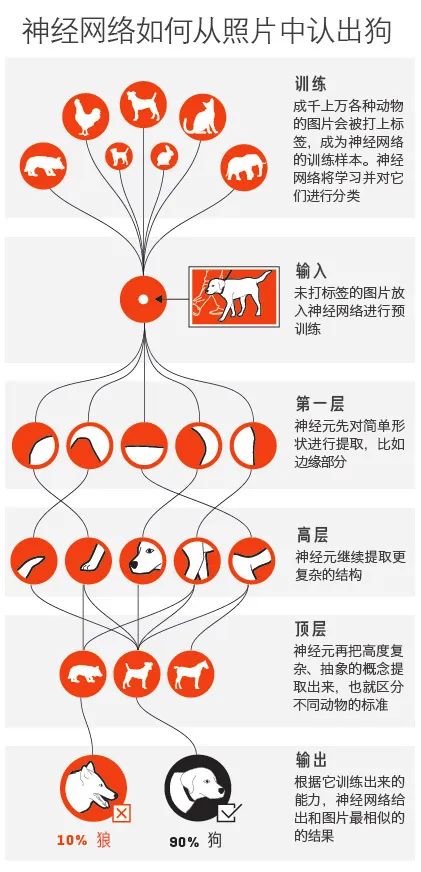
在构造数据集的时候,要注意做好数据的清洗和标注,一个高质量的数据集往往能够提高模型训练的质量和预测的准确率。在缺乏数据的情况下,可以尝试寻找一些公开数据集,特别是得到公认的被普遍使用的数据集。模型的选择、构建很重要,训练数据对模型也是非常重要的,在改变模型架构来尝试提高模型预测准确率的同时,也需要注意提高输入数据的质量,同时也考虑增加输入数据的数量,看是否能够提高模型的预测效果。在比赛中,参与者被
本文汇总了NLP 和 CV领域主流的数据集并提供了介绍。
接下来准备labels,把数据集格式转换成yolo_txt格式,即将每个xml标注提取bbox信息为txt格式,每个图像对应一个txt文件,文件每一行为一个目标的信息,包括class, x_center, y_center, width, height格式。dataSet #之后会在Main文件夹内自动生成train.txt,val.txt,test.txt和trainval.txt四个文件,存放

小时候看书,说我们人类面临三个世界,一个是虚拟的意识世界,另一个是现实的物理世界,第三个是真理世界,也就是数学世界。当然,我们可以比较客观地说,计算机视觉是让计算机去创造一种新的物种,像人一样具有可辨识、可观察的能力。所以我认为,在学术界的毕业生需要有一种哲学的思辨能力,而并不仅仅是做一种技术的应用,也并不仅仅是提高一些效率。在学术界,你的论文发表了之后,研究就结束了。但在工业界是不一样的,论文发