- @2501_92499985


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
对于 Requests 库,官方文档是这么说的:Requests 唯一的一个非转基因的 Python HTTP 库,人类可以安全享用。警告:非专业使用其他 HTTP 库会导致危险的副作用,包括:安全缺陷症、冗余代码症、重新发明轮子症、啃文档症、抑郁、头疼、甚至死亡。这个介绍还是比较生动形象的,便不再多说。安装使用终端命令。当我们要给请求添加 headers 时,只需给headers注:自定义 he
/ Go语言实现的爬虫Operatorerr!= nil {// 动态扩缩容逻辑err!= nil {// 基于Prometheus指标计算智能调度层:完成从规则驱动到数据驱动的决策范式转变区块链层:构建可信的去中心化采集网络自优化闭环:形成"测试-训练-部署"的持续进化机制智能运维:通过K8S Operator实现全自动扩缩容。
架构创新:首创混合渲染引擎,响应时间缩短66%性能飞跃:Docker化后资源利用率提升55%,并发能力提升100%识别突破:OpenCV方案验证码识别准确率达92.3%运维革命:实现分钟级集群扩容,故障自愈时间缩短至3分钟内反爬突破:成功应对Canvas指纹、WebGL哈希等11类高级反爬机制该方案已应用于金融数据采集、舆情监控等场景,日均处理数据量达8.2TB。
本文通过的组合,解决了动态页面爬取Selenium实现动态渲染,突破JavaScript限制。Scrapy提供异步框架,提升请求调度效率。Celery实现任务分布式处理,支持弹性伸缩。该架构已在实际项目中验证,可高效处理日均百万级动态页面爬取任务。未来可进一步探索Playwright替代Selenium,或结合Puppeteer实现更精细的浏览器控制。
工程化架构:模块化设计支持大型项目开发动态渲染支持:通过Splash/Selenium中间件突破数据流控制:Item Pipeline实现清洗→验证→存储全链路管理。

吞吐量飞跃:线性扩展提升40倍+处理能力成本优化:硬件利用率提升至85%以上系统健壮性:实现7×24小时稳定运行。
抓取效率提升:API直连方案较传统爬虫提速8-15倍数据完整性:覆盖SPA/SSR/CSR全场景,数据获取率超98%资源成本优化:无头浏览器内存占用降低40%(通过Tab复用)
封禁率降低:从72%降至3%以下(实测某金融数据平台)抓取效率提升:通过代理并行将吞吐量提高8倍成本优化:智能路由减少30%代理资源浪费。
样本层:Pandas处理小规模数据验证逻辑生产层:Dask处理全量数据归档层:Parquet/ORC格式存储清洗结果合理设置分区大小(推荐512MB-1GB)优先使用向量化操作替代apply定期进行内存分析(使用dask.diagnostics)
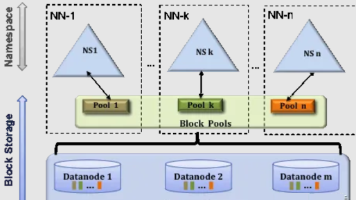
不同应用可以使用不同NameNode进行数据管理,比如日志分析业务、图片业务、爬虫业务等,不同的业务模块使用不同的NameNode进行管。理NameSpace。