- @2401_87000002


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文探讨了大模型Agent岗位面试中的三个核心考察点:大模型能力边界、RAG技术取舍和记忆分层架构。面试官通过这些问题考察候选人是否具备在工程约束下做出技术决策的能力,而非单纯的知识记忆。对于大模型,需要理解其规模效应带来的涌现能力,以及与小型模型在成本、部署上的权衡;RAG技术需掌握从数据准备到检索生成的全流程优化技巧;记忆系统则要设计分层架构,实现短期/长期记忆的平衡。面试关键在于展现对技术选
针对高频、重复度高的视觉 Agent 场景,最划算的优化往往不是把模型调得更好,而是让它少调、调更便宜的。一个 O(1) 的感知哈希挡在前面,一次数据驱动的模型选型落在后面。不需要改模型架构,不需要调 Prompt,不需要做蒸馏——仅仅通过工程化的前置判断和理性选型,就把成本打下来了。在 Agent 落地的战场上,工程素养比模型能力更容易被低估,也更容易产生超额收益。如果你也在做视觉 Agent
故事从一个真实的运营需求开始。运营想问的问题是开放式、组合式的:"上周从小红书来的客户里,聊过但最后没成单的,流失原因 top3 是什么?这个问题拆开来有五个维度:时间(上周)、来源渠道(小红书)、行为条件(聊过)、结果筛选(没成单)、分析目标(流失原因排行)。走传统路线意味着:提需求 → 写 SQL → 配 BI 看板 → 运营拖拽筛选。一套流程下来,半天到一周过去了。而运营真正需要的,是从想法
本文探讨了大模型Agent岗位面试中的三个核心考察点:大模型能力边界、RAG技术取舍和记忆分层架构。面试官通过这些问题考察候选人是否具备在工程约束下做出技术决策的能力,而非单纯的知识记忆。对于大模型,需要理解其规模效应带来的涌现能力,以及与小型模型在成本、部署上的权衡;RAG技术需掌握从数据准备到检索生成的全流程优化技巧;记忆系统则要设计分层架构,实现短期/长期记忆的平衡。面试关键在于展现对技术选
针对高频、重复度高的视觉 Agent 场景,最划算的优化往往不是把模型调得更好,而是让它少调、调更便宜的。一个 O(1) 的感知哈希挡在前面,一次数据驱动的模型选型落在后面。不需要改模型架构,不需要调 Prompt,不需要做蒸馏——仅仅通过工程化的前置判断和理性选型,就把成本打下来了。在 Agent 落地的战场上,工程素养比模型能力更容易被低估,也更容易产生超额收益。如果你也在做视觉 Agent
Function Calling 是一种让 LLM 在生成过程中按需调用外部工具 / API 的机制。它打破了模型"只能靠预训练知识作答"的天花板,让模型从"会说"变成"会做"。
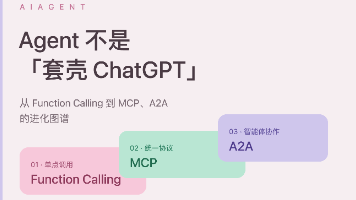
Function Calling 是一种让 LLM 在生成过程中按需调用外部工具 / API 的机制。它打破了模型"只能靠预训练知识作答"的天花板,让模型从"会说"变成"会做"。
Spring Boot 启动流程 = 准备环境 → 创建容器 → 刷新 Bean → 执行 Runner → 发布 Ready 事件。
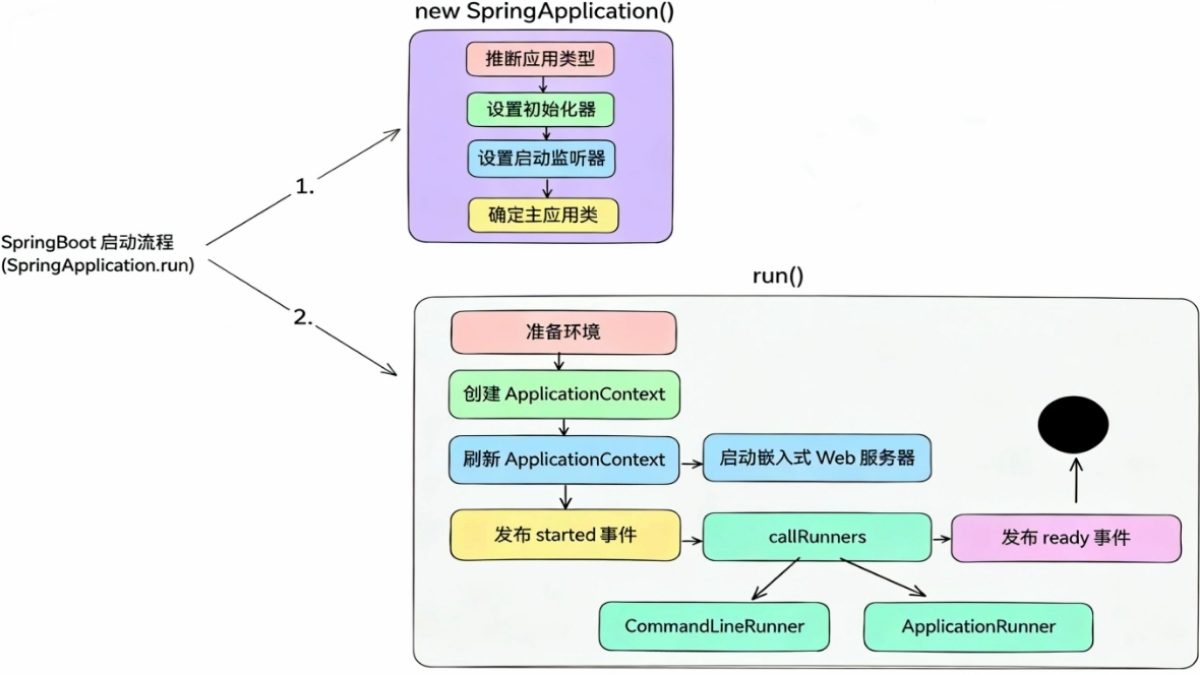
面试时回答要,并适当结合应用场景。
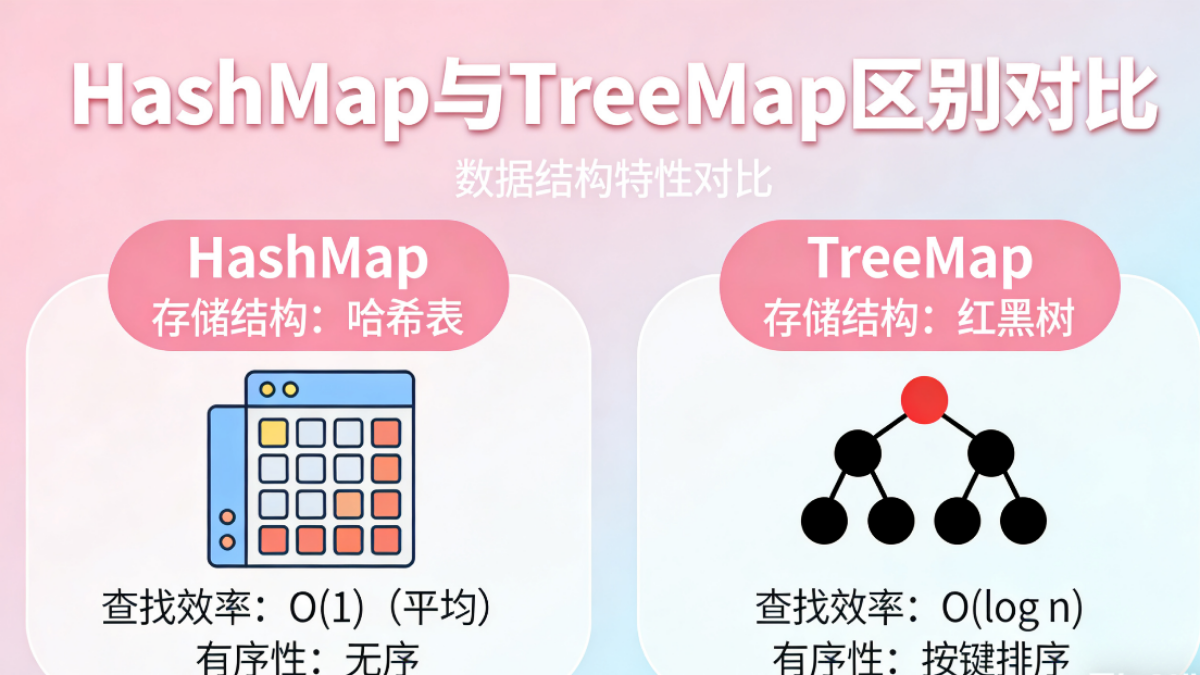
能保证原子性,但仅限于其提供的复合操作方法。自己组合的基本操作不保证原子性,这是 ConcurrentHashMap 使用中最容易出错的点之一。